
RynnWorld-Latent verbindet Robotervideos über gemeinsame latente Aktionen
Mindverse News
KI-gestützt erstellt 4 Quellen Arbeitsweise
Das Wichtigste in Kürze
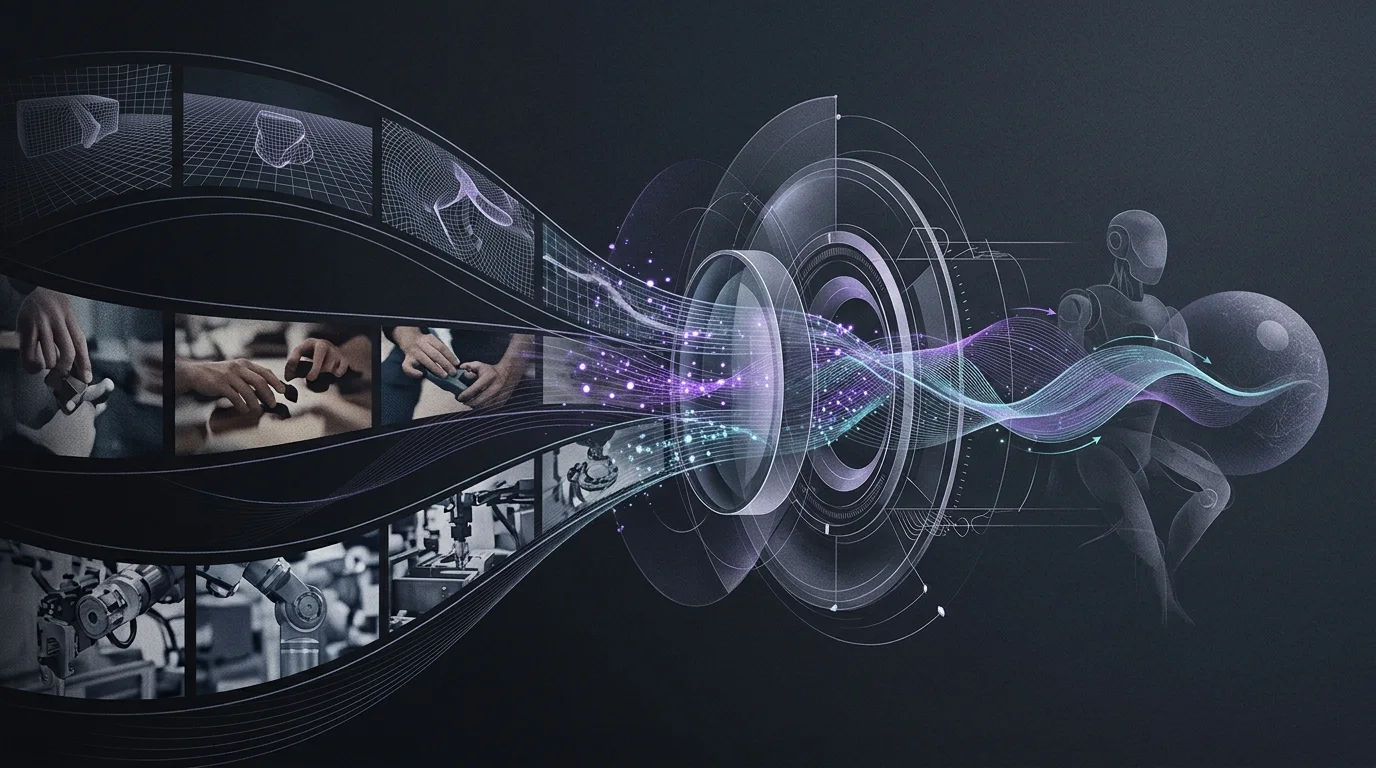
- Das Forschungsmodell nutzt 3D-verankerte latente Aktionen als gemeinsame Steuerungsschnittstelle für Videos von Menschen, Robotern und Simulationen. [1] [2]
- Für das Vortraining nennen die Autoren 23 Datensätze mit insgesamt rund 553,5 Millionen Einzelbildern; anschließend wird das Modell an Zielroboter angepasst. [1] [2]
- Zwei Verfahren sollen synthetische Trainingsdaten erzeugen: digitale Teleoperation mit Zielroboterbefehlen und die Übertragung latenter Bewegungen auf bearbeitete Startbilder. [2]
- Die Autoren berichten über bessere Vorhersagewerte und höhere Erfolgsraten in den ausgewerteten Tests, veröffentlichen in den vorliegenden Zusammenfassungen aber keine Effektgrößen. [1] [2]
- Ein ähnlicher Forschungsansatz, LAC-WM, wurde 2026 auf der ICML vorgestellt; seine Ergebnisse stammen aus eigenen, nicht direkt mit RynnWorld-Latent vergleichbaren Tests. [3] [4]
// Inhalt · 8 Abschnitte
- Ein Weltmodell soll unterschiedliche Roboterbewegungen vergleichbar machen
- Latente Aktionen als gemeinsame Darstellung
- Architektur verknüpft globale und zeitlich ausgerichtete Signale
- Vortraining mit mehr als einer halben Milliarde Einzelbildern
- Zwei Wege zu synthetischen Trainingsdaten
- Berichtete Tests decken Vorhersage und Policy-Training ab
- Einordnung in die Forschung zu robotübergreifenden Weltmodellen
- Was Unternehmen aus dem Ansatz ableiten können
- Quellen
Ein Weltmodell soll unterschiedliche Roboterbewegungen vergleichbar machen
Robotische Weltmodelle sollen vorhersagen, wie sich eine Umgebung verändert, wenn ein Roboter eine Aktion ausführt. Für den Einsatz über mehrere Robotertypen hinweg ist das schwierig: Systeme unterscheiden sich unter anderem in ihren Gelenken, Koordinatensystemen und Steuerungsfrequenzen. Videos von Menschen und Simulationen enthalten zudem häufig keine Steuerbefehle, die sich direkt als Roboteraktionen verwenden lassen. [2]
RynnWorld-Latent setzt an dieser Schnittstellenfrage an. Das von den Autoren beschriebene Modell soll künftige Videobilder anhand einer Beobachtung und einer Folge latenter Aktionen vorhersagen. Dafür soll es weder eine gemeinsame native Robotersteuerung noch eine Textanweisung benötigen. Die Arbeit ist als Forschungsbeitrag auf arXiv veröffentlicht; die beschriebenen Ergebnisse sind daher zunächst als Resultate der Autoren in den angegebenen Versuchsaufbauten zu verstehen. [1] [2]
- Die Herausforderung ist nicht nur, Bewegungen visuell zu erkennen, sondern sie mit einem Steuersignal für die Vorhersage künftiger Zustände zu verbinden. [2]
- RynnWorld-Latent ersetzt die unterschiedlichen nativen Aktionsräume im Vortraining durch eine gemeinsame latente Darstellung. [1] [2]
Latente Aktionen als gemeinsame Darstellung
Als Grundlage verwenden die Autoren RynnLAM, einen vortrainierten und eingefrorenen Encoder, der aus visuellen Übergängen kontinuierliche, laut Paper 3D-verankerte Aktionsdeskriptoren ableitet. Diese Deskriptoren dienen als gemeinsame Konditionierung für Videos aus unterschiedlichen Quellen. Dadurch können nach Darstellung der Autoren menschliche Interaktionen, Roboterdemonstrationen und Simulationsabläufe zusammen zum Vortraining beitragen, ohne dass ihre jeweiligen nativen Steuerungsformate angeglichen werden müssen. [1] [2]
Das Konzept unterscheidet sich von einer einheitlichen Roboterbefehls-Sprache: Die latente Aktion ist eine interne Repräsentation, die aus beobachteten visuellen Übergängen gewonnen wird. Erst in der Anpassung an einen konkreten Zielroboter wird das Weltmodell laut Arbeit zusätzlich auf dessen native Aktionen eingestellt. Die Darstellung kann daher gemeinsame Bewegungsinformationen nutzbar machen, ist aber nicht gleichbedeutend mit einem universellen, unmittelbar ausführbaren Steuerbefehl. [2]
Im Unterschied zu einer rein textgesteuerten Videovorhersage soll die Aktionsfolge feinere zeitliche Unterschiede abbilden. Die Autoren begründen den Ansatz damit, dass eine Aufgabenbeschreibung zwar ein Ziel wie das Aufheben eines Gegenstands nennen kann, aber nicht festlegt, wann ein Greifer schließt oder in welcher Reihenfolge Kontakte entstehen. [2]
Architektur verknüpft globale und zeitlich ausgerichtete Signale
RynnWorld-Latent baut auf einem vortrainierten Video-Diffusion-Transformer auf. Für die Aktionskonditionierung kombinieren die Autoren globale Aktionstokens mit einem lokal und zeitlich ausgerichteten Pfad, der mit einer Identitätsinitialisierung beginnt. Die globale Komponente stellt Aktionsinformationen bereit; der lokale Pfad ordnet einen Übergangsdeskriptor dem entsprechenden künftigen Video-Latent zu. [1] [2]
Diese Zuordnung soll die zeitliche Verbindung zwischen einer Aktion und ihrer visuellen Folge stärken. Sie ist für den Ansatz zentral, weil ein Modell nicht lediglich ein plausibles nächstes Bild erzeugen soll, sondern ein Video, dessen Verlauf von der vorgegebenen Aktionsfolge abhängt. In der Arbeit untersuchen die Autoren diese Steuerbarkeit unter anderem qualitativ, indem sie bei gleicher Ausgangsbeobachtung unterschiedliche latente Aktionsfolgen vorgeben. [2]
Vortraining mit mehr als einer halben Milliarde Einzelbildern
Für das Vortraining nennen die Autoren 23 Datensätze mit zusammen rund 553,5 Millionen Einzelbildern. Die Übersicht in der Arbeit beziffert den Umfang außerdem auf etwa 6.190 Stunden und 2,57 Millionen Episoden. Das Material umfasst menschliche Interaktionsvideos, reale Roboteraufnahmen und Simulationsdaten. [1] [2]
Die Datenmenge allein belegt noch nicht, wie gleichmäßig einzelne Robotertypen, Aufgaben oder Umgebungen vertreten sind. Sie zeigt aber die Größenordnung, in der die Autoren eine gemeinsame visuelle Dynamikrepräsentation lernen wollen. Für Unternehmen, die Robotikdaten aus verschiedenen Quellen zusammenführen, liegt der praktische Bezug in der Frage, ob eine solche Zwischendarstellung den Aufwand für die Harmonisierung unterschiedlicher Aktionsformate verringern kann. Das ist eine mögliche Anwendungsperspektive, kein durch die Datensatzgröße allein nachgewiesener Produktivitätseffekt. [2]
Nach dem Vortraining wird das Modell an Zielroboter angepasst. Die Arbeit beschreibt damit kein vollständig übertragbares System, das ohne robotspezifische Nachbearbeitung auf beliebiger Hardware läuft. Die Autoren rahmen das Vortraining vielmehr als gemeinsamen Ausgangspunkt für eine nachgelagerte Anpassung. [1] [2]
Zwei Wege zu synthetischen Trainingsdaten
Die Autoren beschreiben RynnWorld-Latent nicht nur als Vorhersagemodell, sondern auch als Grundlage für die Erzeugung von Trainingsdaten. Der erste Weg heißt digitale Teleoperation: Steuerungssignale eines Bedieners werden auf Aktionen des Zielroboters abgebildet und treiben die Videogenerierung an. So sollen gepaarte Aktions- und Videobeispiele entstehen, ohne für jede generierte Sequenz eine zusätzliche physische Roboterausführung zu benötigen. [2]
Der zweite Weg, die latente Aktionssynthese, beginnt mit einem vorhandenen Video. Das Modell extrahiert daraus eine Folge latenter Aktionen; anschließend wird das erste Bild bearbeitet, um etwa einen anderen Roboterkörper oder eine andere Umgebung darzustellen. Die ursprüngliche latente Aktionsfolge steuert die Generierung eines neuen Verlaufs. Diesen Verlauf koppeln die Autoren mit retargetierten, also auf den Zielroboter übertragenen, Pseudoaktionen für nachgelagertes Training. [1] [2]
Die beiden Wege unterscheiden sich in ihrer Datenbasis: Bei der digitalen Teleoperation geben Zielroboteraktionen die Generierung vor; bei der latenten Aktionssynthese wird Bewegung aus einem Quellvideo auf eine veränderte Ausgangsszene übertragen. Für Unternehmen ist diese Trennung relevant, weil sie unterschiedliche Anforderungen an vorhandene Demonstrationen, Bedienoberflächen und Validierung stellt. Die Arbeit belegt die beiden Verfahren als Forschungsansätze, nicht bereits einen standardisierten Produktionsprozess. [2]
Berichtete Tests decken Vorhersage und Policy-Training ab
Die Autoren evaluieren das Modell laut Abstract auf öffentlichen Benchmarks für Videovorhersagen sowie auf Daten von zwei realen Roboterplattformen. Sie berichten über verbesserte Vorhersagemetriken und zeigen qualitativ, dass sich bei gleicher Anfangsbeobachtung unterschiedliche Zukunftsverläufe durch verschiedene Aktionsfolgen erzeugen lassen. Die bereitgestellten Angaben enthalten jedoch keine konkreten Effektgrößen oder vollständigen Kennzahlen für diese Resultate. [1] [2]
Für nachgelagertes Policy-Training berichten die Autoren, dass synthetische Daten in Zwischentrainings die Erfolgsraten auf LIBERO und LIBERO-Plus verbessern. Außerdem hätten beide Erzeugungswege in den untersuchten realen Aufgaben höhere Erfolgsraten erzielt als ein Training ausschließlich mit realen Demonstrationen. Die Zusammenfassung nennt dafür weder absolute Erfolgsraten noch die Größe der Verbesserungen; Aussagen über die praktische Tragweite müssen deshalb auf diese qualitative Ergebnisbeschreibung begrenzt bleiben. [1] [2]
Die im Abstract genannten Ergebnisse sind ein Hinweis darauf, dass generierte Daten für die untersuchten Trainings- und Testbedingungen nützlich sein können. Sie belegen für sich genommen weder eine gleichwertige Übertragbarkeit auf beliebige Roboter und Aufgaben noch einen Ersatz realer Datenerhebung. Für eine betriebliche Bewertung wären insbesondere aufgabenspezifische Erfolgsraten, Fehlerfälle, Kosten der Anpassung und der Vergleich mit bestehenden Datenerzeugungsprozessen entscheidend; diese Informationen sind in den hier vorliegenden Zusammenfassungen nicht ausgewiesen. [1] [2]
Einordnung in die Forschung zu robotübergreifenden Weltmodellen
RynnWorld-Latent ist nicht der einzige Ansatz, der latente Aktionen für Weltmodelle über verschiedene Robotertypen hinweg untersucht. Ein eigenständiger Forschungsbeitrag mit dem Namen LAC-WM wurde 2026 auf der ICML vorgestellt. Er vergleicht einen Weltmodellansatz mit latenten Aktionen mit einer Variante, die explizite Bewegungslabels verwendet. Die Arbeiten adressieren damit eine verwandte Schnittstellenfrage, verwenden aber unterschiedliche Methoden und Versuchsaufbauten. [3] [4]
Für LAC-WM berichten die Autoren Verbesserungen gegenüber ihrem explizit aktionskonditionierten Vergleichsmodell von bis zu 46,7 Prozent bei dexteröser Manipulation und 11,7 Prozent auf einer modifizierten LIBERO-Auswertung. Diese Werte gehören ausschließlich zu den Tests von LAC-WM und lassen sich nicht als Vergleichszahlen für RynnWorld-Latent lesen. Sie zeigen vielmehr, dass gemeinsame Aktionsrepräsentationen ein aktives Forschungsfeld sind und dass Leistungsbehauptungen nur im jeweiligen Benchmark-Kontext aussagekräftig sind. [3] [4]
Was Unternehmen aus dem Ansatz ableiten können
Für Robotikteams liegt der mögliche Nutzen von RynnWorld-Latent vor allem in einer Datenstrategie: Visuelle Interaktionen aus heterogenen Quellen könnten über latente Deskriptoren für ein gemeinsames Vortraining zugänglich werden, während die Anpassung an die Zielhardware nachgelagert erfolgt. Das könnte dort interessant sein, wo Video leichter verfügbar ist als harmonisierte Aktionslabels. Diese Einordnung folgt aus der beschriebenen Architektur und den Datenquellen; einen konkreten Rückgang von Entwicklungsaufwand oder Kosten weisen die Autoren nicht nach. [2]
Die synthetischen Datenwege eröffnen zugleich eine neue Prüfaufgabe. Bei einer generierten Sequenz müssen Teams beurteilen, ob visuelle Plausibilität, Aktionszuordnung und Verhalten auf der realen Hardware zusammenpassen. Besonders bei der latenten Aktionssynthese stammen die Bewegungsvorgabe und die Zielroboterdarstellung aus unterschiedlichen Schritten des Verfahrens. Daraus folgt als Analyse, dass die Qualität der Retargetierung und die Validierung synthetischer Demonstrationen für einen produktiven Einsatz entscheidend wären; der bereitgestellte Abstract quantifiziert diese Aspekte nicht. [2]
Der Beitrag liefert damit einen konkreten technischen Vorschlag für ein bekanntes Integrationsproblem: unterschiedliche Aktionsräume sollen im Vortraining durch eine gemeinsame latente Schnittstelle überbrückt werden. Die berichteten Ergebnisse sind ermutigend für die untersuchten Benchmarks und Plattformen, erlauben aber noch keine pauschale Aussage über den Einsatz in industriellen Abläufen. Für eine belastbare Beschaffungs- oder Implementierungsentscheidung wären detaillierte Kennzahlen, Kostenangaben und Tests auf den jeweils relevanten Robotern und Aufgaben nötig. [1] [2]
Quellen
- [1] Paper page - RynnWorld-Latent: A Cross-Embodiment World Model Conditioned on Universal Latent Actions — https://huggingface.co/papers/2610.36791 (abgerufen am 2026-10-28)
- [2] RynnWorld-Latent: A Cross-Embodiment World Model Conditioned on Universal Latent Actions — https://arxiv.org/html/2610.36791v1 (abgerufen am 2026-10-28)
- [3] Cross-Embodiment Robot Foundation World Models with Latent Actions | OpenReview — https://openreview.net/forum?id=S30Y1sBz34 (abgerufen am 2026-10-28)
- [4] ICML Poster Cross-Embodiment Robot Foundation World Models with Latent Actions — https://icml.cc/virtual/2026/poster/63978 (abgerufen am 2026-10-28)
//Nächster Artikel
Robotik
OSMA-Bench prüft, ob Haushaltsroboter ihr Verhalten an Hindernisrisiken anpassenOSMA-Bench misst, ob Roboter Abstand und Tempo dem Hindernisrisiko anpassen. Die Studie findet Lücken bei VLM- und VLA-Policies. [S3]
// Artikel teilen
Mehr zu Robotik & Humanoide
Alle Robotik-News- ThinkWorld macht Weltveränderungen zum Lernsignal für Roboter
ThinkWorld nutzt Dynamikketten und Weltvorhersagen, um VLA-Modelle auch mit unbeschrifteten menschlichen Videos zu trainieren. [S1]
- Rollback nutzt Weltmodelle, um Roboterentscheidungen rückwärts zu verbessern
Rollback nutzt gelernte Weltmodelle, um Roboterentscheidungen rückwärts zu prüfen. Die Autoren melden höhere Erfolgsraten in drei realen Aufgaben.
- Klagen gegen Lieferroboter: Streit um biometrische Daten in Chicago
Zwei Klagen in Chicago werfen Coco Robotics und Serve Robotics die unzulässige Erfassung biometrischer Daten vor. Beide Unternehmen bestreiten die Vorwürfe.
- RoboJudge trennt physikalische Plausibilität von Aufgabenerfüllung in Robotervideos
RoboJudge bewertet KI-generierte Robotervideos getrennt nach physikalischer Plausibilität und Aufgabenerfüllung und meldet 0,719 Korrelation.
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.