
Rollback nutzt Weltmodelle, um Roboterentscheidungen rückwärts zu verbessern
Mindverse News
KI-gestützt erstellt 3 Quellen Arbeitsweise
Das Wichtigste in Kürze
- Rollback setzt ein gelerntes Weltmodell ein, um zu früheren Entscheidungspunkten zurückzukehren, alternative Aktionen zu simulieren und deren Folgen zu vergleichen. [1]
- Die Autoren berichten für Blockextraktion, Ballwurf und Tisch-Curling absolute Erfolgszuwächse gegenüber der jeweils stärksten Baseline. [1]
- Das Verfahren soll Gegenfaktisches in kleinteilige, aktionsbezogene Trainingssignale übersetzen, ohne ein separat gelerntes Wertmodell zu verwenden. [1]
- Reale Roboterübergänge sollen das Weltmodell fortlaufend korrigieren; die Arbeit nennt dafür eine leichtgewichtige LoRA-Pipeline. [1]
- Die verfügbaren Angaben nennen keine Versuchsdetails wie Stichprobengrößen oder Unsicherheitsintervalle. Die berichteten Resultate lassen sich daher anhand der Paper-Seite nicht unabhängig einordnen. [1]
// Inhalt · 7 Abschnitte
- Ein Weltmodell als Gegenfaktual-Maschine
- Vom simulierten Vergleich zum Trainingssignal
- Reale Daten sollen die Modellfehler begrenzen
- Drei reale Aufgaben, deutliche relative Zugewinne
- Einordnung gegenüber anderen Weltmodell-Ansätzen
- Was die Resultate für den praktischen Einsatz aussagen
- Offene Fragen zu Modelltreue und Nachweis
- Quellen
Ein Weltmodell als Gegenfaktual-Maschine
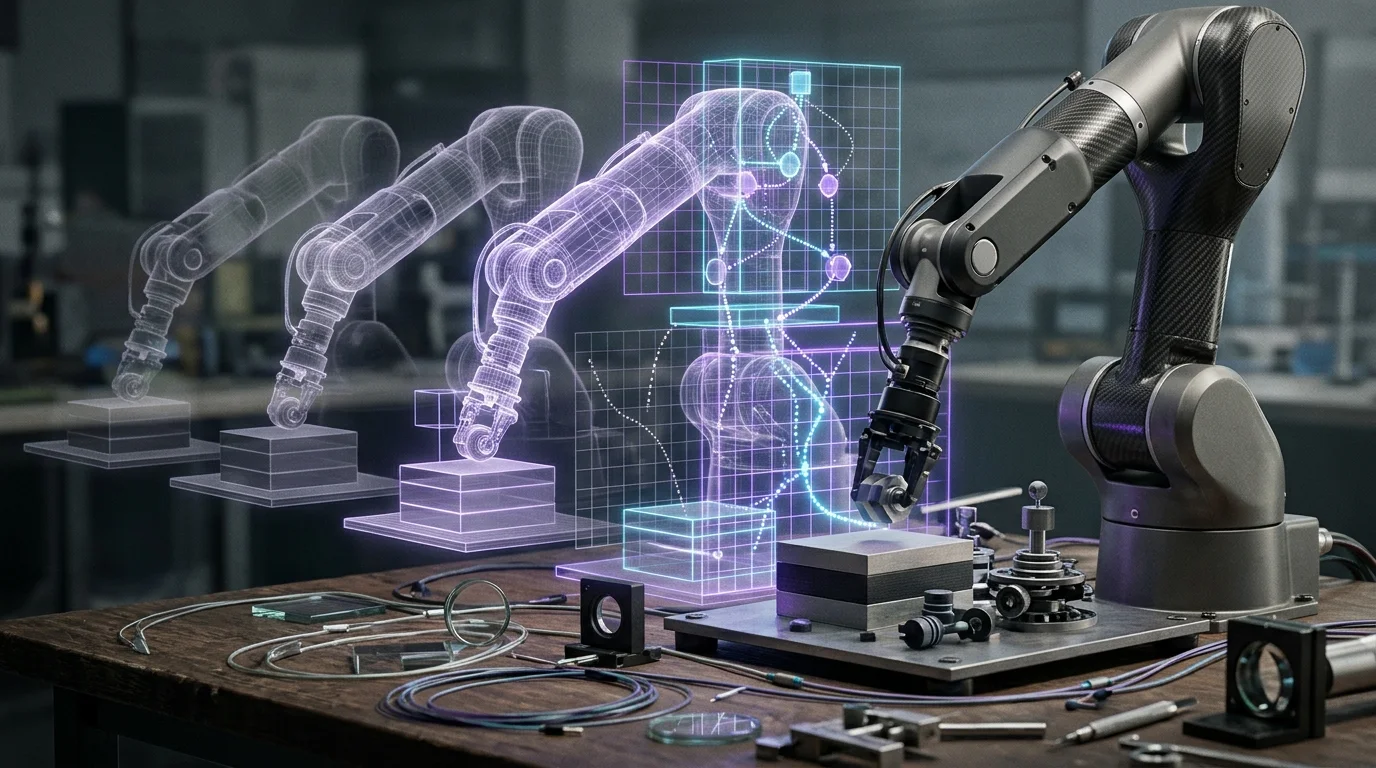
Die Arbeit „Rollback: Experience Backtracking in World Models for Policy Improvement“ beschreibt einen Ansatz, mit dem Roboterpolicies mithilfe gelernter Weltmodelle verbessert werden sollen. Statt ein Modell nur vorwärts als Ersatz für die physische Umgebung zu nutzen, kehrt das Verfahren laut Abstract zu wichtigen früheren Entscheidungspunkten zurück, verzweigt dort in alternative Aktionen und vergleicht die vorhergesagten Folgen. [1]
Der zentrale Gedanke: Ein Roboter kann einen bereits durchlaufenen Moment in der realen Welt nicht erneut betreten und dort eine andere Aktion ausprobieren. Ein Weltmodell kann dagegen einen früheren Zustand als Ausgangspunkt verwenden und simulieren, wie sich alternative Aktionen vermutlich ausgewirkt hätten. Rollback macht diese Möglichkeit nach Darstellung der Autoren gezielt für das Policy-Training nutzbar. [1]
Ein Weltmodell bildet dafür Zustandsübergänge ab: Es sagt voraus, wie sich ein Zustand unter einer bestimmten Aktion verändert. In verwandter Forschung wird diese Funktion als Vorhersage des nächsten Zustands anhand des aktuellen Zustands und der ausgeführten Aktion beschrieben. [2] Rollback ergänzt diesen Vorwärtsschritt um eine Rückkehr zu ausgewählten Entscheidungspunkten und um Verzweigungen in mehrere mögliche Zukunftsverläufe. [1]
- Die Suche soll sich auf kritische Entscheidungspunkte konzentrieren, statt alle möglichen Handlungsfolgen gleichmäßig auszuprobieren. [1]
- Der Vergleich der simulierten Folgen soll helfen, den Erfolg oder Misserfolg einzelnen Aktionen zuzuordnen. [1]
- Aus diesen Gegenfaktualen soll eine fein abgestufte, aktionsbezogene Trainingsaufsicht entstehen. [1]
Vom simulierten Vergleich zum Trainingssignal
Nach der Beschreibung der Arbeit entsteht die Verbesserung nicht allein dadurch, dass ein Roboter zur Laufzeit die im Modell beste Aktion auswählt. Vielmehr dienen die verzweigten Modellläufe dazu, Erfahrungen der Policy nachträglich zu analysieren und daraus gezieltere Trainingssignale abzuleiten. Die Autoren bezeichnen dies als Policy-Improvement-Paradigma, das Weltmodelle von passiven Simulatoren zu Werkzeugen für kontrafaktische Suche macht. [1]
Das Verfahren soll dabei unterschiedliche Konsequenzen alternativer Aktionen gegenüberstellen. Wenn eine Abzweigung zu einem besseren vorhergesagten Ergebnis führt als eine andere, kann dieser Kontrast nach dem Ansatz der Autoren Hinweise darauf geben, welche Entscheidung für den Erfolg maßgeblich war. Die Arbeit beschreibt die daraus abgeleitete Aufsicht als „action-level“, also auf Ebene einzelner Aktionen. [1]
Laut Abstract kommt Rollback dabei ohne ein separat gelerntes Wertmodell aus. Das ist eine Aussage über die dort beschriebene Methode, nicht der Nachweis, dass Wertschätzung für andere Verfahren oder andere Robotikaufgaben entbehrlich wäre. Die verfügbaren Angaben erläutern zudem nicht im Detail, wie die einzelnen Gegenfaktualverläufe gewichtet oder zu konkreten Updates der Policy zusammengeführt werden. [1]
Reale Daten sollen die Modellfehler begrenzen
Ein grundsätzliches Risiko modellbasierter Ansätze ist, dass Vorhersagefehler in längeren simulierten Verläufen anwachsen. Eine andere Arbeit zu Q-Learning mit Weltmodellen beschreibt diese kumulierende Modellverzerrung als Problem, das bei längeren Aufgaben und visuell komplexen Umgebungen stärker ins Gewicht fallen kann. [2] Rollback setzt nach Darstellung seiner Autoren deshalb auf gezielte Suche an kritischen Punkten und auf einen fortlaufenden Rückfluss realer Erfahrungen in das Weltmodell. [1]
Diesen Kreislauf nennen die Autoren „test-time physics grounding“: Das Weltmodell dient als Trainingsumgebung, während reale Übergänge aus der Interaktion der trainierten Policy genutzt werden, um seine Dynamik weiter zu korrigieren. Für diese Anpassung nennen sie eine leichtgewichtige LoRA-Pipeline. Die Paper-Seite liefert jedoch keine näheren Angaben dazu, welche Parameter konkret angepasst werden, wie häufig dies geschieht oder wie groß die Anpassung im Verhältnis zum Gesamtmodell ausfällt. [1]
Das beschriebene Trainingssystem verbindet außerdem verteilte Suche im Weltmodell mit asynchroner Ausführung auf realen Robotern. Daraus ergibt sich ein selbstverstärkender Prozess: Reale Erfahrungen sollen das Modell verbessern, und ein verbessertes Modell soll wiederum weitere Policy-Verbesserungen ermöglichen. Die Seite beschreibt diese Architektur als Systemansatz, nennt aber keine Laufzeiten, Hardwareanforderungen oder Durchsatzwerte. [1]
Drei reale Aufgaben, deutliche relative Zugewinne
Die Autoren berichten Experimente an drei realen Aufgaben: Blockextraktion, Ballwurf und Tisch-Curling. Gegenüber der jeweils stärksten Baseline habe Rollback die Erfolgsraten um absolute 10,67 %, 11,11 % beziehungsweise 11,85 % verbessert. Die Reihenfolge der Werte entspricht den drei Aufgaben in der Zusammenfassung der Paper-Seite. [1]
Zudem berichten die Autoren von stabileren Verbesserungen über den Trainingsverlauf. Ausgangspunkt seien teleoperierte Demonstrationen gewesen, deren Leistungsniveau deutlich unter dem menschlicher Spieler gelegen habe. Nach acht Stunden Training habe Rollback beim Ballwurf und beim Tisch-Curling die durchschnittliche Erfolgsrate menschlicher Spieler übertroffen. [1]
Diese Ergebnisse sind als Angaben der Autoren zu lesen. Die bereitgestellte Paper-Seite nennt weder die absoluten Erfolgsraten der Systeme noch die Zahl der Versuche, die Zahl der Trainingsläufe oder Unsicherheitsintervalle. Auch die Bedingungen, unter denen die menschlichen Vergleichswerte ermittelt wurden, sind dort nicht ausgeführt. Damit lässt sich aus den verfügbaren Angaben weder die statistische Belastbarkeit der Abstände prüfen noch beurteilen, wie stark die Resultate von der jeweiligen Versuchsanordnung abhängen. [1]
Einordnung gegenüber anderen Weltmodell-Ansätzen
Rollback steht in einem Forschungsfeld, in dem Weltmodelle unterschiedliche Rollen übernehmen. Q-Learning With World Models (QWM) nutzt ein Weltmodell beispielsweise für die Suche über vorgestellte Handlungsverläufe, um bei einer Entscheidung geeignete Aktionen auszuwählen. Die Policy und die Wertfunktion werden dort laut Arbeit jedoch nur mit realen Übergängen trainiert; die Modellsuche dient der Aktionsauswahl während des Trainings und der Auswertung. Die Experimente werden für die Benchmarks Robomimic und LIBERO berichtet. [2]
Rollback setzt den Schwerpunkt anders: Es verwendet das Weltmodell nach eigener Beschreibung, um zu früheren Entscheidungen zurückzugehen, Gegenfaktuale zu erzeugen und deren Ergebnisse in feinere Trainingsaufsicht zu überführen. Die beiden Ansätze illustrieren damit verschiedene Einsatzpunkte für Modellvorhersagen: Suche zur Auswahl einer Aktion auf der einen, kontrafaktischer Vergleich zur Policy-Verbesserung auf der anderen Seite. Ein direkter Leistungsvergleich zwischen QWM und Rollback ist aus den verfügbaren Quellen nicht ersichtlich. [1][2]
Auch BOOM, ein auf OpenReview dokumentiertes und als NeurIPS-2025-Poster angenommenes Verfahren, verbindet Weltmodellplanung mit Policy-Lernen. Dort initialisiert die aktuelle Policy den Planer; anschließend werden Planeraktionen über eine wertgewichtete Verhaltensangleichung in die Policy zurückgeführt. Die Experimente betreffen laut OpenReview DeepMind Control Suite und Humanoid-Bench. [3] Rollback und BOOM verfolgen somit beide einen Rückfluss zwischen Planer beziehungsweise Modell und Policy, beschreiben aber unterschiedliche Mechanismen und wurden in den vorliegenden Quellen nicht unter denselben Bedingungen verglichen. [1][3]
Was die Resultate für den praktischen Einsatz aussagen
Für Unternehmen, die Robotiksysteme trainieren, ist vor allem die mögliche Verschiebung des Lernaufwands relevant: Wenn ein Weltmodell alternative Aktionen an besonders wichtigen Punkten durchspielen kann, könnten zusätzliche Lernsignale entstehen, ohne jede Variante am physischen Roboter ausführen zu müssen. Das ist eine aus dem beschriebenen Verfahren abgeleitete Möglichkeit, kein in der Paper-Zusammenfassung quantifizierter Rückgang realer Versuche oder Trainingskosten. [1]
Die gemeldeten Verbesserungen beziehen sich auf drei Aufgaben und belegen für sich genommen keine Übertragbarkeit auf andere Roboter, Sensorik, Umgebungen oder längere Aufgabenfolgen. Ebenso wenig zeigen die Angaben, wie viel Rechenaufwand die verzweigte Suche benötigt oder ob sich die modellbasierte Suche in einem industriellen Trainingsbetrieb wirtschaftlich rechnet. Die Autoren bezeichnen das System zwar als skalierbar, doch die verfügbaren Angaben enthalten keine Kennzahlen, anhand derer sich diese Skalierbarkeit unabhängig bewerten ließe. [1]
Für die Einsatzplanung ist außerdem wichtig, Training und Betrieb auseinanderzuhalten. Die Paper-Seite beschreibt Rollback als Paradigma zur Policy-Verbesserung und als Trainingssystem mit Modell-Suche und realer Roboterausführung. Sie belegt nicht, dass die Suche im Weltmodell bei jeder späteren Roboteraktion zur Laufzeit ausgeführt wird. Unternehmen sollten daher aus den vorliegenden Angaben keine konkreten Aussagen zu Inferenzlatenz oder Echtzeitfähigkeit ableiten. [1]
Offene Fragen zu Modelltreue und Nachweis
Die Stärke eines kontrafaktischen Vergleichs hängt davon ab, ob das Weltmodell die Folgen alternativer Aktionen ausreichend zuverlässig vorhersagt. Reale Rückmeldungen und fortlaufende Modellanpassung sind dafür ein plausibler Bestandteil des von Rollback beschriebenen Kreislaufs; sie beseitigen Modellfehler jedoch nicht automatisch. Vergleichbare Forschung weist darauf hin, dass Modellfehler bei längeren Vorhersageketten kumulieren können. [1][2]
Die auf Hugging Face wiedergegebene Paper-Seite enthält einen Abstract und eine Zusammenfassung des Ansatzes, aber keine detaillierten Angaben zu Versuchsprotokollen, Ablationen oder statistischer Auswertung. Die Seite verlinkt zwar auf weitere Materialien, weist im bereitgestellten Text aber keinen Begutachtungsstatus aus. Auf Grundlage dieser Informationen lässt sich deshalb weder der Peer-Review-Status feststellen noch beurteilen, ob die berichteten Zugewinne in abweichenden Umgebungen reproduzierbar sind. [1]
Der zentrale Beitrag der Arbeit liegt nach ihrer eigenen Darstellung in der Verbindung von Rückwärtszugriff auf frühere Entscheidungspunkte, kontrafaktischer Verzweigung und realem Feedback für die Anpassung des Weltmodells. Die Resultate liefern einen konkreten Hinweis darauf, dass dieser Ansatz bei den drei untersuchten Aufgaben leistungsfähig sein kann. Für eine belastbare betriebliche Bewertung fehlen in den verfügbaren Angaben jedoch noch die Details zu Kosten, Versuchsbreite und Übertragbarkeit. [1]
Quellen
- [1] Paper page - Rollback: Experience Backtracking in World Models for Policy Improvement — https://huggingface.co/papers/2610.36068 (abgerufen am 2026-10-28)
- [2] Q-Learning With World Models — https://arxiv.org/html/2608.17163v1 (abgerufen am 2026-10-28)
- [3] Bootstrap Off-policy with World Model | OpenReview — https://openreview.net/forum?id=zNqDCSokDR (abgerufen am 2026-10-28)
//Nächster Artikel
Robotik
ThinkWorld macht Weltveränderungen zum Lernsignal für RoboterThinkWorld nutzt Dynamikketten und Weltvorhersagen, um VLA-Modelle auch mit unbeschrifteten menschlichen Videos zu trainieren. [S1]
// Artikel teilen
Mehr zu Robotik & Humanoide
Alle Robotik-News- Klagen gegen Lieferroboter: Streit um biometrische Daten in Chicago
Zwei Klagen in Chicago werfen Coco Robotics und Serve Robotics die unzulässige Erfassung biometrischer Daten vor. Beide Unternehmen bestreiten die Vorwürfe.
- RoboJudge trennt physikalische Plausibilität von Aufgabenerfüllung in Robotervideos
RoboJudge bewertet KI-generierte Robotervideos getrennt nach physikalischer Plausibilität und Aufgabenerfüllung und meldet 0,719 Korrelation.
- Nvidia veröffentlicht Flora-Modelle zur Auswertung von Robotikvideos
Nvidia stellt Flora-Modelle für Robotikvideos bereit. Die Kostenangaben, Benchmarks und Grenzen der automatischen Videoannotation im Überblick.
- Royal Berkshire setzt Robotik für Arthritis-Ultraschall ein
Das Royal Berkshire Hospital setzt ARTHUR für robotergestützte Ultraschallscans bei rheumatoider Arthritis ein. Was bekannt ist – und was noch fehlt.
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
//Chronik
Rund um den 28. Oktober 2026
← Davor erschienen