Model A
Rechnungsdaten extrahieren
Rechnungsnummer, Anbieter und Betrag als JSON ausgeben.
Strukturierte Ausgabe und die Qualitätsanforderung grenzen die Auswahl ein.

Mindverse Research / In Entwicklung
Hydra bringt Ihre Aufgabe mit dem passenden Modell zusammen. Qualität, Kosten und Antwortzeit bestimmen die Auswahl – mit einer nachvollziehbaren Entscheidung für jede Anfrage.
Aktuell: lokaler Entwicklungsplaner. Produktionszugang noch nicht aktiviert.
Illustrative Modellauswahl
Aufgabe + Prioritäten + zulässige Modelle
Eine Antwort. Eine dokumentierte Auswahl.
Konzeptdarstellung. Es wird keine Anfrage gesendet und kein Modell ausgeführt.
// 01 · Die Auswahl
Ein Modell pro Anfrage. Die Aufgabe und Ihre Prioritäten bestimmen, welches.
Model A
Rechnungsnummer, Anbieter und Betrag als JSON ausgeben.
Strukturierte Ausgabe und die Qualitätsanforderung grenzen die Auswahl ein.
Model B
Eine Retry-Bedingung auf einen Grenzfehler prüfen.
Ein Modell mit passendem Reasoning-Niveau analysiert den Code und formuliert das Ergebnis.
Model C
Auf eine verspätete Lieferung empathisch und ohne unbelegte Zusagen antworten.
Ein für Textaufgaben geeignetes Modell arbeitet mit den vorgegebenen Fakten und Tonalitätsregeln.
Illustrative Beispiele mit Platzhaltermodellen. Keine Live-Anfragen; der historische Benchmark unten ist separat.
// 02 · So funktioniert die Auswahl
01 / Verstehen
Aufgabentyp, Reasoning-Bedarf und gewünschtes Ausgabeformat bestimmen, welche Modelle für die Anfrage infrage kommen.
02 / Auswählen
Der aktuelle Planer verbindet die von der Anwendung zugelassenen Modelle mit Entwicklungsdaten zur jeweiligen Aufgabenkategorie. Qualität, Generierungskosten und Antwortzeit lassen sich gewichten.
03 / Ein Modell einsetzen
Die dargestellte Route sieht eine direkte Antwort durch ein Modell vor. Andere Modelle bleiben Alternativen. Multi-Modell-Ketten sind aktuell nicht verfügbar.
04 / Nachvollziehen
Aufgabenmerkmale, Auswahlkriterien und gewählte Modelle lassen sich im lokalen Entscheidungsprotokoll nachvollziehen.
Das Routing findet in Deutschland statt. Ausgewählte Modelle können bei externen Providern laufen.
Ein optionaler Portfoliofilter grenzt die Auswahl anhand geprüfter Modellklassifikationen und ausdrücklicher Self-Hosting-Annahmen ein. Gewichte und Lizenzbedingungen sind vor einem Deployment zu prüfen.
Ihre Datenschutzanforderungen bestimmen, welche Routen zulässig sind. Der aktuelle Planer verwendet die von der Anwendung vorgegebene Eignung.
Der Entwicklungspool umfasst aktuell 29 Modelle und 261 Aufgabenkombinationen – mit aufgabenspezifischen Rankings und anpassbaren Prioritäten.
// 03 · Interner Benchmark
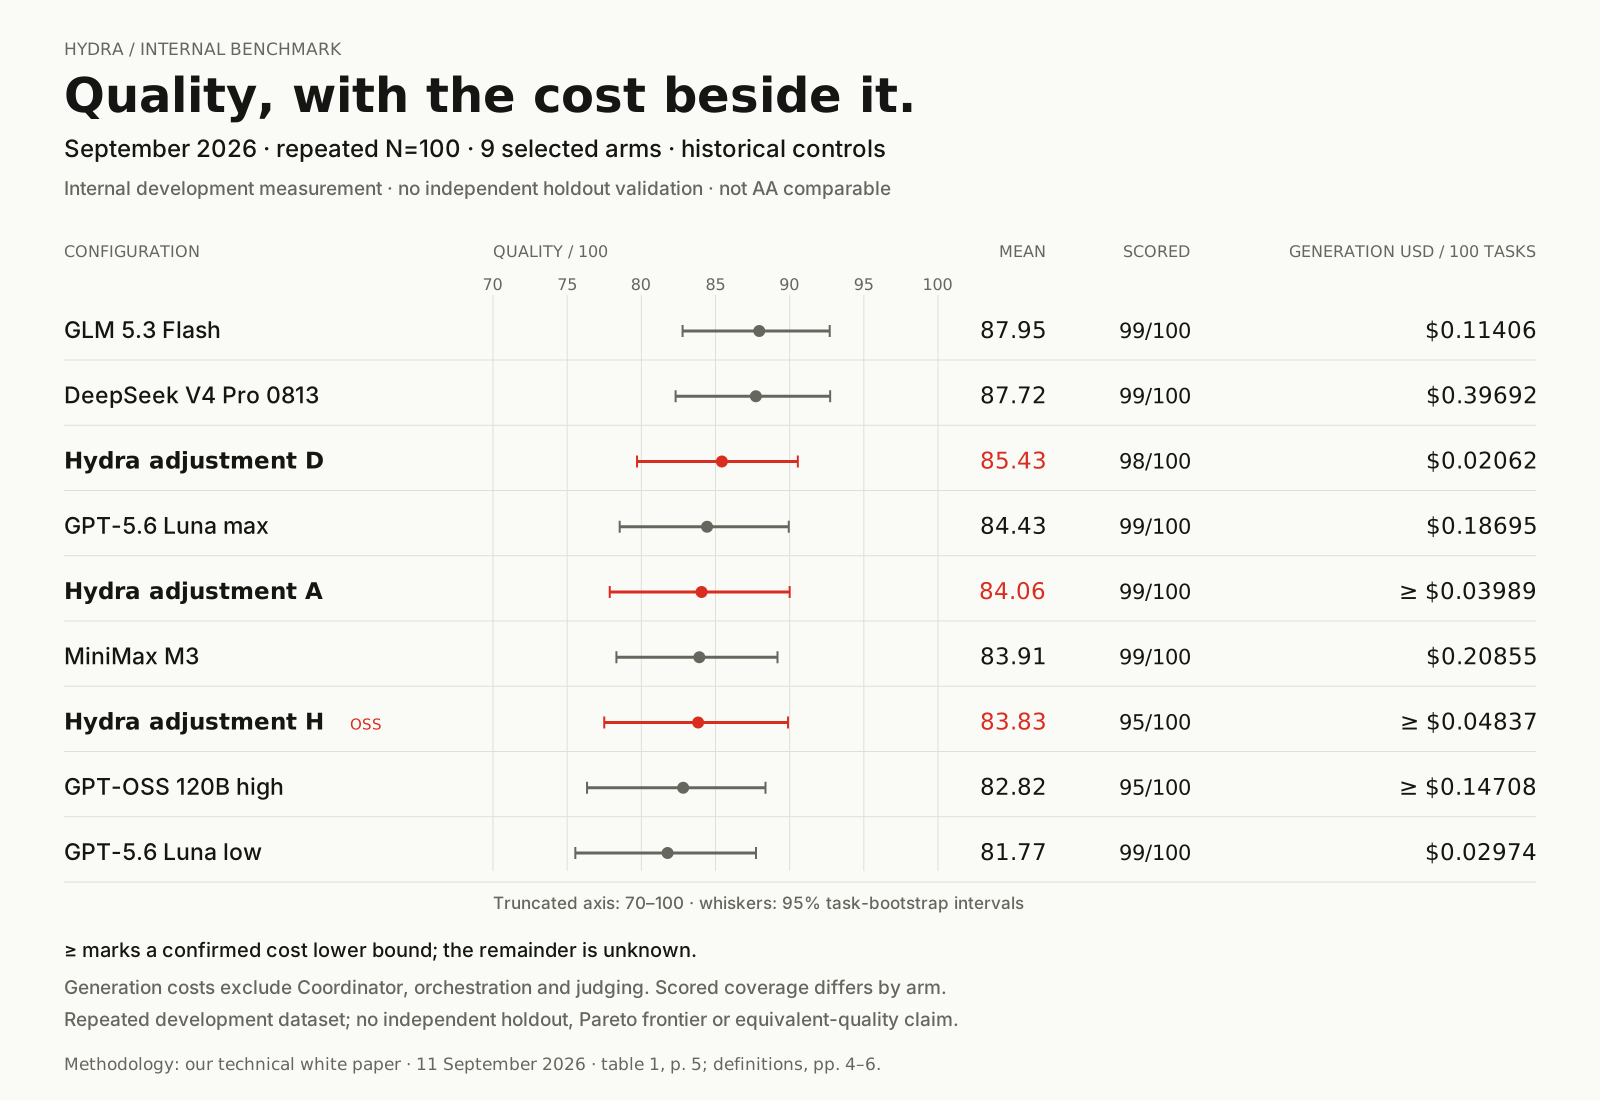
Drei Hydra-Konfigurationen und sechs historische Vergleichsmodelle auf 100 internen Aufgaben, bewertet mit Fable 5.1. Entwicklungsstand: September 2026.
| Konfiguration | Bewertet / 100 | Qualität / 100 | USD / 100 geplante Aufgaben |
|---|---|---|---|
| GLM 5.3 FlashHistorisches Vergleichsmodell | 99 | 87,95 | $0.11406 |
| DeepSeek V4 Pro 0813Historisches Vergleichsmodell | 99 | 87,72 | $0.39692 |
| Hydra adjustment DHydra-Konfiguration | 98 | 85,43 | $0.02062 |
| GPT-5.6 Luna maxHistorisches Vergleichsmodell | 99 | 84,43 | $0.18695 |
| Hydra adjustment AHydra-Konfiguration | 99 | 84,06 | ≥ $0.03989 + ? |
| MiniMax M3Historisches Vergleichsmodell | 99 | 83,91 | $0.20855 |
| Hydra adjustment H · OSSHydra-Konfiguration | 95 | 83,83 | ≥ $0.04837 + ? |
| GPT-OSS 120B highHistorisches Vergleichsmodell | 95 | 82,82 | ≥ $0.14708 + ? |
| GPT-5.6 Luna lowHistorisches Vergleichsmodell | 99 | 81,77 | $0.02974 |
Mittlerer Fable-5.1-Score der bewerteten Aufgaben, nicht aller 100 geplanten Aufgaben. Die Quellgrafik zeigt deskriptive 95-%-Task-Bootstrap-Intervalle (2.000 Wiederholungen). Der Aufgabensatz wurde wiederverwendet; unabhängige Holdout-Evidenz fehlt.
A und die festen Vergleichsmodelle: 9. September; D und H: 10. September 2026. Provider, Timeouts, Recovery und Bewertung unterschieden sich zwischen den Wellen.
Berichtete Generierungskosten in USD für 100 geplante Aufgaben inklusive erfasster Versuche. Ohne Koordinator, Orchestrierung, Bewertung und Service-Overhead. ≥ + ? kennzeichnet eine Untergrenze mit unbekanntem Rest, keinen vollständigen Preis.
Neun ausgewählte Konfigurationen für direkte Antworten ohne Tools. Unterschiedliche Bewertungsabdeckung, historische Kontrollen und überlappende Intervalle belegen weder universelle Einsparungen noch Überlegenheit oder eine Pareto-Front. Dies sind interne Scores, keine Artificial-Analysis-Rankings.
04 · Evaluation & Integration
Der aktuelle Entwicklungsstand plant die Modellauswahl lokal. Lassen Sie uns besprechen, welche Qualität, Kosten und Antwortzeiten Ihre Anwendung braucht – und was eine passende Evaluation zeigen muss.
Node.js / Offline
node current/head.mjs inspect
node current/head.mjs verify
Aus einer lokalen Hydra-Installation ausführen. Die Befehle inspizieren den Modellpool und verifizieren den Planer offline; sie führen keine Modelle aus. Produktionszugang ist noch nicht aktiviert.
// FAQ