
ThinkWorld macht Weltveränderungen zum Lernsignal für Roboter
Mindverse News
KI-gestützt erstellt 2 Quellen Arbeitsweise
Das Wichtigste in Kürze
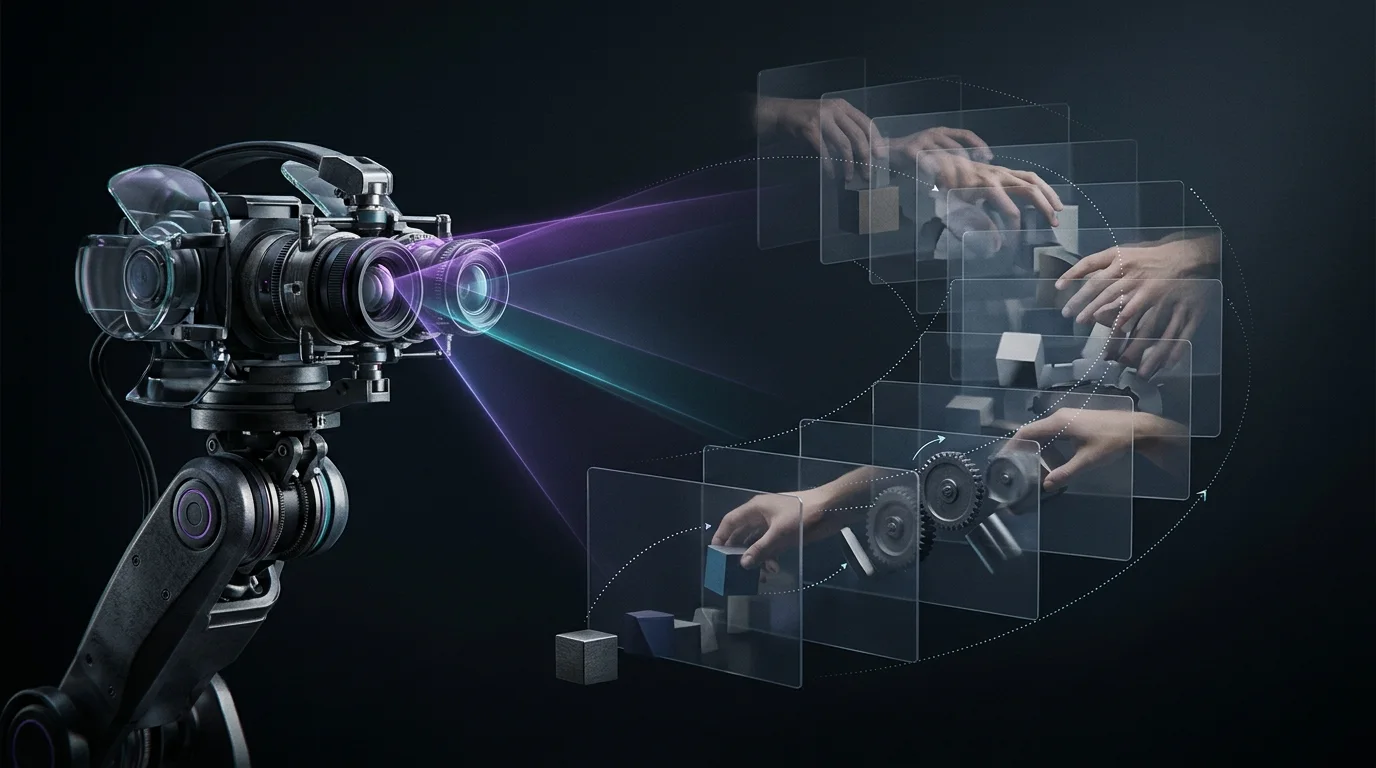
- ThinkWorld stellt Handlungen als Folgen diskreter Bewegungstokens dar, die den Übergang von einem aktuellen zu einem künftigen Weltzustand beschreiben. [1]
- Das Verfahren soll die vorhergesagten Folgen einer Handlung mit dem tatsächlich beobachteten Übergang abgleichen und passende Dynamikketten verstärken. [1][2]
- So sollen auch Videos ohne Aktionslabels Lernsignale liefern und menschliche sowie robotische Erfahrungen in einem gemeinsamen Handlungsraum zusammenführen. [1]
- Die Autoren berichten von Tests in Simulationen und mit realen Robotern sowie von Übertragungen auf unbekannte Aufgaben und Umgebungen; konkrete Messwerte nennt die bereitgestellte Zusammenfassung nicht. [1][2]
// Inhalt · 6 Abschnitte
Ein Engpass beim Lernen von Roboterhandlungen
Vision-Language-Action-Modelle (VLA) verbinden visuelle Beobachtungen und sprachliche Aufgabenbeschreibungen mit Roboterhandlungen. Nach Darstellung der ThinkWorld-Autoren bleibt ihre Verallgemeinerung jedoch durch die begrenzte Vielfalt und Abdeckung gelabelter Roboterdemonstrationen eingeschränkt: Für diese Daten muss bekannt sein, welche Aktion in einer Situation ausgeführt wurde. [1]
Menschliche Videos sind in deutlich größerer Vielfalt verfügbar und zeigen Handlungen in unterschiedlichen Umgebungen. Sie lassen sich aber nicht ohne Weiteres wie Roboterdemonstrationen verwenden, wenn die darin sichtbaren Bewegungen nicht als konkrete Roboteraktionen annotiert sind. ThinkWorld setzt deshalb nicht allein bei der Frage an, welche Aktion ausgeführt wurde, sondern bei der Veränderung, die eine Handlung in der Welt bewirkt. [1]
Die Herausforderung ist damit zugleich eine Frage der Repräsentation und der Trainingssignale: Ein Modell soll aus visuellen Beobachtungen handlungsrelevante Dynamik ableiten, ohne dass für jedes Video eine passende Roboteraktion vorliegen muss. Die Autoren ordnen ThinkWorld als VLA-Lernrahmen ein, der dieses Problem mit einer expliziten Zwischenrepräsentation und bestärkendem Lernen adressiert. [1][2]
- VLA-Modelle können laut den Autoren entweder Handlungen direkt vorhersagen oder Zwischenschritte für das Schlussfolgern verwenden. [2]
- Bei bestehenden Zwischenrepräsentationen liege der Schwerpunkt häufig auf übergeordneten Plänen oder der Szenenstruktur und weniger darauf, wie eine Handlung die Welt verändert. [2]
Dynamikketten als gemeinsame Handlungssprache
Der Kern des Ansatzes heißt Chain-of-Dynamics (CoD). Eine CoD ist laut Abstract eine Abfolge diskreter Bewegungstokens, die die Zwischendynamik zwischen dem aktuellen Zustand der Welt und einem künftigen Zustand abbildet. Die Handlung wird damit nicht nur als einzelner Zielbefehl behandelt, sondern als beschriebener Verlauf, der erklärt, wie die erwartete Veränderung zustande kommen soll. [1]
Die OpenReview-Zusammenfassung beschreibt CoD ebenfalls als Folge von „action thoughts“: Aus einer Beobachtung und einer Aufgabenanweisung erzeugt das Modell eine Kette, die angibt, wie sich die Welt während der Handlung entwickeln soll. Diese Kette sagt einen künftigen Weltzustand voraus; ihre Bewertung richtet sich danach, wie gut diese Vorhersage zum beobachteten Übergang passt. [2]
Als gemeinsamer Handlungsraum über verschiedene Verkörperungen hinweg soll die Tokenfolge eine Brücke zwischen menschlicher Erfahrung und Robotersteuerung schlagen. Die Zusammenfassungen erläutern jedoch nicht im Detail, wie die CoD-Tokens technisch erzeugt, auf konkrete Roboterkinematiken abgebildet oder in ausführbare Steuerbefehle übersetzt werden. Diese Implementierungsfragen lassen sich aus den bereitgestellten Angaben daher nicht beurteilen. [1][2]
Lernen durch Abgleich von Vorhersage und Beobachtung
Der beschriebene Trainingsablauf beginnt mit aktionsgelabelten Demonstrationen. Sie dienen dazu, die CoD-Repräsentation zu initialisieren. Anschließend sagt das Modell voraus, welche Zukunft eine jeweilige Dynamikkette herbeiführen würde. Dynamikketten, deren vorhergesagte Folgen besser mit dem tatsächlich beobachteten Ergebnis übereinstimmen, werden verstärkt. [1]
Damit verschiebt sich ein Teil der Aufsicht von der expliziten Aktionsannotation hin zum beobachtbaren Zustandsübergang: Wenn ein Video zeigt, wie sich eine Situation verändert, kann diese Veränderung nach dem Ansatz als direktes Lernsignal für die handlungsbezogene Schlussfolgerung dienen. Die Autoren beschreiben dies als Möglichkeit, auch Videos ohne Aktionslabels einzubeziehen. [1]
Die OpenReview-Beschreibung präzisiert die beabsichtigte Funktion des Abgleichs: Die CoD soll aufgabenrelevante Dynamik erfassen, indem sie danach bewertet wird, wie nahe der vorhergesagte Zustand am beobachteten Übergang liegt. Das bestärkende Lernen soll somit nicht bloß eine sprachlich plausible Begründung belohnen, sondern eine Repräsentation, deren erwartete Weltveränderung zu den Daten passt. [2]
Die Quellen liefern allerdings keine vollständige Beschreibung der Trainingsformel. Sie nennen weder eine konkrete Verlust- oder Belohnungsfunktion noch die verwendeten Zustandsmerkmale, die zeitliche Auflösung der Kette oder die genaue Behandlung mehrdeutiger Beobachtungen. Aussagen darüber, wie robust der Abgleich bei Kamerabewegungen, verdeckten Objekten oder abweichenden Perspektiven funktioniert, wären deshalb auf Basis der Abstracts spekulativ.
Was der Ansatz für menschliche Videos verspricht
Die zentrale Datenidee besteht darin, menschliche Videos nicht zwingend zuerst in Roboteraktionen übersetzen zu müssen. Stattdessen sollen sichtbare Zustandswechsel dabei helfen, den gemeinsamen CoD-Raum zu verfeinern. Laut den Autoren können so menschliche und robotische Erfahrungen dieselbe handlungsbezogene Repräsentation beeinflussen. [1]
Für die Übertragung zwischen Mensch und Roboter ist diese Trennung relevant: Bewegungen von Menschen und Robotern unterscheiden sich in Körperbau und Ausführung, während sich ein angestrebter Weltzustand oder die Dynamik einer Aufgabe in beiden Fällen beschreiben lassen kann. Das ist eine mögliche Erklärung dafür, warum die Autoren eine gemeinsame Repräsentation über verschiedene Verkörperungen hinweg anstreben; konkrete Belege oder eine formale Analyse dieses Übertragungsmechanismus enthält die bereitgestellte Zusammenfassung jedoch nicht. [1]
Die Autoren berichten, dass Experimente in Simulationen und mit realen Robotern einen wirksamen Transfer von Menschen auf Roboter sowie eine Verallgemeinerung auf ungesehene Aufgaben und Umgebungen zeigen. Die OpenReview-Zusammenfassung berichtet außerdem von Vorteilen gegenüber End-to-End-VLA-Modellen und VLA-Baselines mit Schlussfolgerungsrepräsentationen. [1][2]
Diese Angaben sind qualitative Ergebnisbehauptungen der Forschungsgruppe. In den verfügbaren Texten fehlen Benchmarknamen, Stichprobengrößen, Vergleichswerte, Fehlerbalken und Angaben zu den getesteten Robotern. Deshalb lässt sich aus ihnen weder die Größe des berichteten Fortschritts noch seine statistische Belastbarkeit oder Übertragbarkeit auf industrielle Aufgaben ableiten. [1][2]
Einordnung für Unternehmen und Robotikentwicklung
Für Unternehmen, die Robotikdaten erheben oder VLA-Systeme evaluieren, ist die Arbeit vor allem als Vorschlag für eine andere Nutzung vorhandener Videodaten relevant. Wenn beobachtete Zustandsübergänge tatsächlich ohne vollständige Aktionslabels als Trainingssignal ausreichen, könnte das den Aufwand für manuelle Aktionsannotation verringern. Das ist eine mögliche betriebliche Konsequenz des beschriebenen Mechanismus, kein in den bereitgestellten Quellen quantifizierter Kosteneffekt. [1]
Zugleich hängt der praktische Nutzen davon ab, ob eine CoD aus beobachteten Veränderungen verlässlich auf robotisch ausführbare Handlungen übertragbar ist. Die Quellen beschreiben diese Verbindung als Ziel des Rahmens und sprechen von einer gemeinsamen Repräsentation über Verkörperungen hinweg; sie nennen aber keine Angaben zu Datenmengen, Trainingskosten, Laufzeit, Sicherheitsprüfungen oder Betrieb in Produktionsumgebungen. [1][2]
Für eine Beschaffungs- oder Integrationsentscheidung reicht der Abstract daher nicht aus. Unternehmen müssten insbesondere prüfen, auf welchen Aufgaben und Robotertypen ThinkWorld getestet wurde, wie stark die Ergebnisse gegenüber geeigneten Baselines ausfallen und ob die Modelle unter veränderten Sensor- und Umgebungsbedingungen stabil bleiben. Die bereitgestellten Zusammenfassungen beantworten diese Fragen nicht; sie belegen eine Forschungsrichtung und berichtete Experimente, aber keine industrielle Einsatzreife. [1][2]
Was die vorliegenden Angaben offenlassen
Die verfügbare Beschreibung macht die konzeptionelle Kette nachvollziehbar: gelabelte Demonstrationen initialisieren die Dynamikrepräsentation, Vorhersagen werden mit beobachteten Folgen abgeglichen und unbeschriftete Videos sollen zusätzliche Übergänge liefern. Sie enthält aber nicht die Details, die für eine unabhängige technische Reproduktion erforderlich wären. [1][2]
Auch die experimentelle Evidenz bleibt in den bereitgestellten Texten knapp. Es gibt keine Zahlen zu Erfolgsraten oder zur Verbesserung gegenüber den genannten Baselines und keine Aufschlüsselung nach Aufgaben, Umgebungen oder Simulations- und Realrobotiktests. Die Aussage, ThinkWorld generalisiere auf ungesehene Aufgaben und Umgebungen, ist daher als Ergebnisbehauptung der Autoren zu verstehen, nicht als unabhängig bestätigter Leistungsnachweis. [1][2]
Die Quellen führen zudem unterschiedliche Titel und Datumsangaben: Die Hugging-Face-Seite verwendet den Titel „World Imagination Reinforces Chain-of-Dynamics Reasoning“ und zeigt „Published on Oct 26“ sowie eine Einreichung am 28. Oktober; der OpenReview-Eintrag nennt „World Imagination Reinforces Embodied Action Reasoning“ und führt eine Veröffentlichung am 2. Oktober 2026 sowie den Workshop PTA bei NeurIPS 2026 auf. Die bereitgestellten Angaben erklären diese Abweichungen nicht; ein eindeutiger Veröffentlichungs- oder Annahmestatus lässt sich daraus nicht ableiten. [1][2]
Der OpenReview-Eintrag bezeichnet die Einreichung als Kurzbeitrag mit vier Seiten. Er ist eine zusätzliche Beschreibung desselben ThinkWorld-Ansatzes, aber keine unabhängige Bestätigung der berichteten Resultate. Für eine belastbare Bewertung sind daher die vollständige Arbeit und nachvollziehbare experimentelle Details entscheidend. [2]
Quellen
- [1] Paper page - ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning — https://huggingface.co/papers/2610.37666 (abgerufen am 2026-10-28)
- [2] ThinkWorld: World Imagination Reinforces Embodied Action Reasoning | OpenReview — https://openreview.net/forum?id=PJNXtFkbcm&referrer=%5Bthe+profile+of+Fu-En+Yang%5D%28%2Fprofile%3Fid%3D%7EFu-En_Yang1%29 (abgerufen am 2026-10-28)
//Nächster Artikel
Robotik
Rollback nutzt Weltmodelle, um Roboterentscheidungen rückwärts zu verbessernRollback nutzt gelernte Weltmodelle, um Roboterentscheidungen rückwärts zu prüfen. Die Autoren melden höhere Erfolgsraten in drei realen Aufgaben.
// Artikel teilen
Mehr zu Robotik & Humanoide
Alle Robotik-News- Klagen gegen Lieferroboter: Streit um biometrische Daten in Chicago
Zwei Klagen in Chicago werfen Coco Robotics und Serve Robotics die unzulässige Erfassung biometrischer Daten vor. Beide Unternehmen bestreiten die Vorwürfe.
- RoboJudge trennt physikalische Plausibilität von Aufgabenerfüllung in Robotervideos
RoboJudge bewertet KI-generierte Robotervideos getrennt nach physikalischer Plausibilität und Aufgabenerfüllung und meldet 0,719 Korrelation.
- Nvidia veröffentlicht Flora-Modelle zur Auswertung von Robotikvideos
Nvidia stellt Flora-Modelle für Robotikvideos bereit. Die Kostenangaben, Benchmarks und Grenzen der automatischen Videoannotation im Überblick.
- Royal Berkshire setzt Robotik für Arthritis-Ultraschall ein
Das Royal Berkshire Hospital setzt ARTHUR für robotergestützte Ultraschallscans bei rheumatoider Arthritis ein. Was bekannt ist – und was noch fehlt.
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
//Chronik