
OSMA-Bench prüft, ob Haushaltsroboter ihr Verhalten an Hindernisrisiken anpassen
Mindverse News
KI-gestützt erstellt 3 Quellen Arbeitsweise
Das Wichtigste in Kürze
- OSMA-Bench vergleicht Navigation in räumlich abgestimmten Szenarien, in denen sich vor allem die Art des Hindernisses ändert. [3]
- Der Simulationsbenchmark umfasst 625 Szenarien mit 18 Hindernissen, sieben Routen und fünf Küchenlayouts. [3]
- Der Semantic Sensitivity Index bewertet, ob Abstand, Tempo und Bewegungsruhe der erwarteten Vorsicht gegenüber verschiedenen Hindernissen folgen. [3]
- Die Autoren berichten, dass getestete VLM- und VLA-Policies ihr Bewegungsverhalten nicht zuverlässig an die Sicherheitsrelevanz anpassen – auch nicht mit expliziten Sicherheitshinweisen. [2][3]
- Bei VLM-Policies verbessert ein separater Schritt zur Ableitung von Bewegungsparametern laut Studie die Anpassung; für VLA-Policies brachten untersuchte Eingriffe nur begrenzte Verbesserungen. [3]
// Inhalt · 6 Abschnitte
- Sicher navigieren heißt mehr als Kollisionen vermeiden
- Kontrollierte Vergleiche statt bloßer Erfolgsquoten
- Der SSI misst Bewegung in Hindernisnähe
- Erkennen führt nicht automatisch zu vorsichtigem Handeln
- Was der Befund für die Entwicklung von Robotiksystemen bedeutet
- Einordnung: Simulation und Vorabversion begrenzen die Aussagekraft
- Quellen
Sicher navigieren heißt mehr als Kollisionen vermeiden
Ein Haushaltsroboter kann ein Ziel erreichen, ohne ein Hindernis zu berühren, und sich dennoch unangemessen verhalten: etwa zu nah oder zu schnell an einem Menschen vorbeifahren. Die Frage, ob eine Navigation unfallfrei endet, erfasst deshalb nicht, ob ein System seine Bewegung an die Bedeutung und den Abstand eines Hindernisses anpasst. Mit dieser Lücke befasst sich OSMA-Bench, ein Simulationsbenchmark für die Bewertung sicherheitsangepasster Roboterbewegung in Wohnumgebungen. [1][3]
Die Arbeit stammt von Hyunwoong Bae, Jisu Han, Jiyeon Choi, Dohoon Kim und Taesup Moon. Sie stellt neben dem Benchmark den Semantic Sensitivity Index (SSI) vor. Dieser soll erfassen, ob sich Sicherheitsunterschiede zwischen Hindernissen in konkreten Bewegungsmerkmalen niederschlagen. Die Autoren berichten, dass die untersuchten Vision-Language-Modelle (VLMs) und Vision-Language-Action-Policies (VLAs) diese Anpassung nicht zuverlässig zeigen – auch dann nicht, wenn sie ausdrücklich zu sicherem Verhalten aufgefordert werden. [1][2][3]
Der Fokus liegt damit auf dem Übergang von einer semantischen Einschätzung zur Bewegung: Ein System muss nicht nur erkennen, dass ein Hindernis beispielsweise ein Lebewesen oder ein zerbrechlicher Gegenstand ist. Es muss diese Einschätzung auch in Abstand, Geschwindigkeit und ausgeführten Aktionen umsetzen. Die Autoren bezeichnen diese Verbindung als „semantic-to-motion grounding“. [3]
Kontrollierte Vergleiche statt bloßer Erfolgsquoten
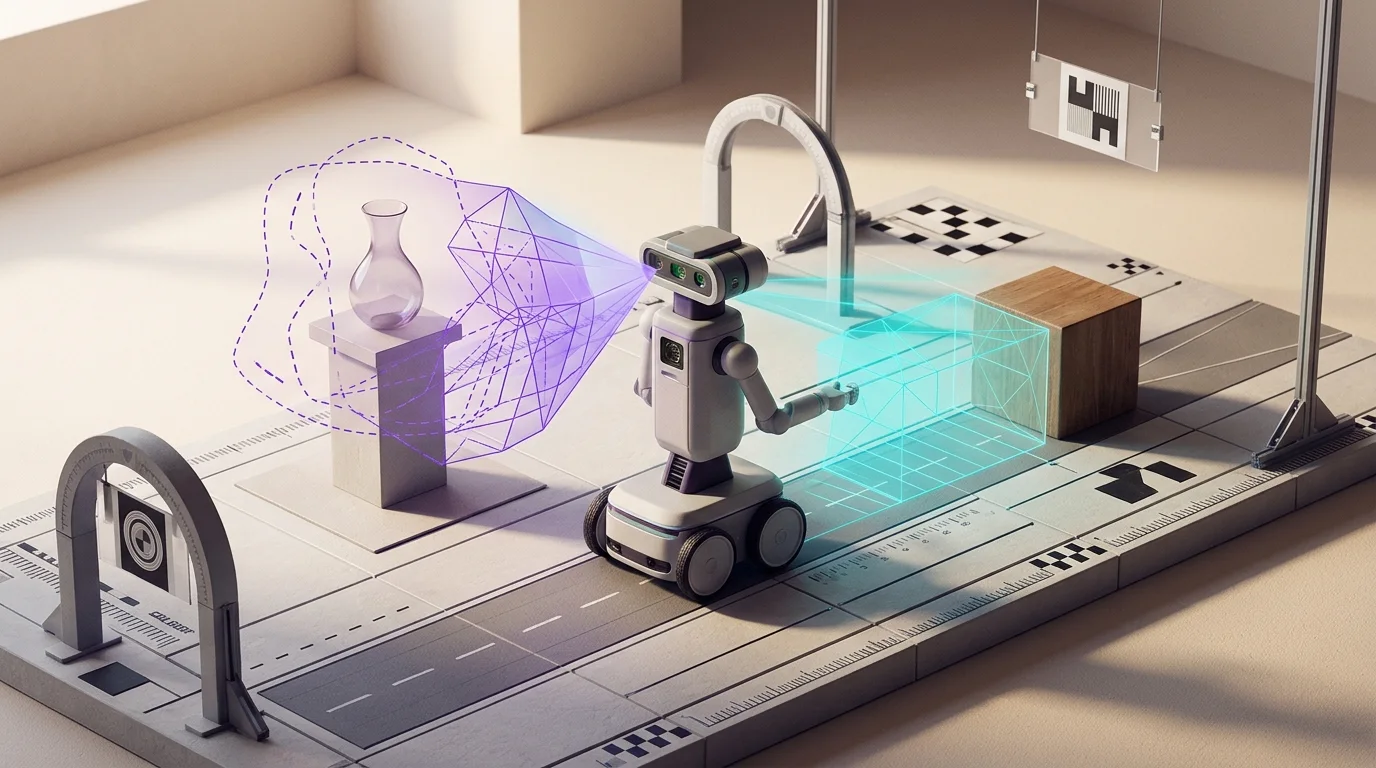
OSMA-Bench ist auf räumlich abgestimmte Vergleichsfälle ausgelegt. Innerhalb eines solchen Vergleichs bleiben Route, Hindernisposition und Umgebung konstant; verändert wird der Hindernistyp. So soll sich besser isolieren lassen, ob eine andere Bewegung tatsächlich auf die Sicherheitsrelevanz des Hindernisses zurückgeht und nicht auf eine veränderte Geometrie des Wegs. Die Autoren variieren zusätzlich Routen und Küchenlayouts, um zu prüfen, ob eine Anpassung über einzelne räumliche Konstellationen hinaus auftritt. [3]
Der Benchmark umfasst 625 Navigationsszenarien, fünf Layoutvarianten, sieben Routen und 18 Hindernisobjekte. Die Hindernisse werden in drei Vorsichtsstufen eingeteilt: „Living“ für Lebewesen, „Fragile“ für zerbrechliche oder verschüttbare Gegenstände und „Robust“ für robustere Objekte. Zu den Beispielen zählen ein Baby, ein Hund oder eine Katze in der ersten Gruppe, eine Vase oder eine Lampe in der zweiten und ein Mülleimer oder Karton in der dritten. Die Einstufung legt eine relative Vorsichtsreihenfolge für die Auswertung fest; sie ist Teil des Benchmarkdesigns. [3]
Die Tests setzen auf RoboCasa auf. Die Forschenden ergänzten beziehungsweise veränderten Hindernisse und Layouts, um die kontrollierten Vergleiche in plausiblen Küchenumgebungen zu ermöglichen. Eine Kombination wurde ausgeschlossen, weil der Mensch in dieser Konstellation bereits das Ziel der Route war. Diese Angaben beschreiben eine Simulation und belegen für sich genommen noch kein Verhalten physischer Haushaltsroboter in realen Wohnungen. [3]
Der SSI misst Bewegung in Hindernisnähe
Die zentrale methodische Unterscheidung der Arbeit betrifft die Ebene der Bewertung. Task Success Rate (TSR) erfasst, ob der Roboter das Ziel erreicht. Die Collision-Free Success Rate (CFSR) erfasst erfolgreiche Aufgaben ohne Kollision. Als primäre aufgabenbezogene Sicherheitskennzahl verwendet die Studie das Verhältnis CFSR zu TSR: Es beschreibt den Anteil der erfolgreichen Aufgaben, bei denen zugleich keine Kollision auftrat. [3]
Solche Kennzahlen sagen jedoch nicht, ob ein Roboter um ein risikoreicheres Hindernis einen größeren Abstand hält oder im Nahbereich langsamer fährt. Dafür betrachtet der SSI Bewegungsmerkmale entlang erfolgreicher, kollisionsfreier Ausführungen. Er bezieht den Mindestabstand sowie die Geschwindigkeit und die Bewegungsruhe in Abhängigkeit von der Entfernung zum Hindernis ein. [3]
Für die Bewegungsanalyse normalisieren die Autoren Geschwindigkeit, Beschleunigung und Ruck – eine Kenngröße für abrupte Änderungen der Beschleunigung – anhand des Oberflächenabstands zwischen Roboter und Hindernis. Die Messung konzentriert sich auf einen festgelegten Bereich in Hindernisnähe. Der Abstand zwischen den Oberflächen soll den Einfluss unterschiedlicher Objektgrößen verringern. Damit berücksichtigt die Auswertung, dass dieselbe Geschwindigkeit je nach Nähe zum Hindernis eine andere Sicherheitsrelevanz haben kann. [3]
Der SSI fragt anschließend, ob die beobachteten Unterschiede der erwarteten Vorsichtsreihenfolge entsprechen: Gegenüber einem robusten Gegenstand sollte die Bewegung gegenüber einem Lebewesen vorsichtiger ausfallen. Die Metrik ist damit diagnostisch ausgerichtet. Sie soll nicht nur feststellen, ob ein Lauf erfolgreich war, sondern ob die Bewegung systematisch auf die Hindernisart reagiert. [3]
Erkennen führt nicht automatisch zu vorsichtigem Handeln
Das zentrale Ergebnis der Autoren ist eine Diskrepanz zwischen der Erkennung sicherheitsrelevanter Unterschiede und ihrer Umsetzung in Bewegung. Die untersuchten Policies konnten Hindernisse nach ihrer Sicherheitsrelevanz unterscheiden, passten aber die erzeugten Bewegungsparameter oder Aktionen nicht zuverlässig entsprechend an. Explizite Sicherheitshinweise beseitigten diese Lücke in den Tests nicht. [2][3]
Bei VLM-basierten Ansätzen identifiziert die Studie eine mögliche Stelle, an der die Übersetzung verloren geht. Diese Systeme erkennen zunächst die Szene und erzeugen anschließend ein Navigationsprogramm. Laut Autoren fällt die Anpassung schwächer aus, wenn das Modell zugleich den Aufgabencode und die Bewegungsparameter erzeugen soll. Ein gesonderter Zwischenschritt, in dem Bewegungsparameter aus der Sicherheitseinschätzung abgeleitet werden, verbesserte die Anpassung im Benchmark. [3]
Bei VLA-Policies, die visuelle Eingaben und Sprache direkt in Aktionen überführen, waren untersuchte Eingriffe wie zusätzliche Aufforderungen oder Anpassungen der Aktionsauswahl laut Studie nur begrenzt wirksam. Das Ergebnis deutet nach Interpretation der Autoren auf eine Herausforderung hin, die nicht allein bei der sprachlichen Begründung liegt: Sicherheitswissen muss die tatsächlich ausgeführten Bewegungen beeinflussen. [3]
Die verfügbaren Textpassagen enthalten keine vergleichbaren numerischen SSI-Werte oder Ranglisten einzelner Modelle. Daher lässt sich aus ihnen weder die Größe der Unterschiede zwischen Systemen noch eine belastbare Rangfolge ableiten. Die Ergebnisdarstellung sollte hier entsprechend als berichteter Befund der Studienautoren und nicht als unabhängiger Nachweis für alle VLM- oder VLA-Systeme gelesen werden. [2][3]
Was der Befund für die Entwicklung von Robotiksystemen bedeutet
Für Unternehmen, die Roboter für Haushalte oder andere Umgebungen mit Menschen entwickeln, ergibt sich eine praktische Konsequenz: Eine erfolgreiche Aufgabenabschlussrate und eine geringe Zahl von Kollisionen reichen nicht aus, um abgestufte Sicherheitsreaktionen zu beurteilen. Ergänzend kann geprüft werden, ob ein System bei unterschiedlichen Hindernissen reproduzierbar mehr Abstand hält und sein Tempo in deren Nähe verändert. OSMA-Bench liefert dafür ein konkretes Evaluationsschema, nicht aber eine fertige Sicherheitszertifizierung. [3]
Die Ergebnisse sprechen außerdem dafür, die Schnittstellen zwischen Wahrnehmung, Planung und Steuerung gezielt zu testen. Bei den untersuchten VLM-Policies verbesserte ein eigener Schritt zur Parameterableitung die Anpassung. Für ein Produktteam kann es daher sinnvoll sein, nicht nur die Qualität der Objekterkennung oder die Plausibilität einer sprachlichen Antwort zu bewerten, sondern auch zu prüfen, ob eine erkannte Risikoklasse in nachvollziehbare Bewegungsparameter übergeht. Das ist eine aus den berichteten Befunden abgeleitete Entwicklungsimplikation, kein Nachweis, dass diese Architektur in realen Produkten bereits sicherer ist. [3]
Auch eine pauschal vorsichtige Bewegung ist nicht automatisch die beste Lösung. Die Autoren betonen, dass ein Roboter stärker auf risikoreiche Situationen reagieren sollte, ohne gegenüber jedem Hindernis unnötig konservativ zu werden. Für die betriebliche Bewertung bedeutet das: Neben Sicherheitsmerkmalen sollte auch sichtbar bleiben, ob zusätzliche Vorsicht selektiv eingesetzt wird und die Navigation nicht unabhängig von der Situation verlangsamt. [3]
Einordnung: Simulation und Vorabversion begrenzen die Aussagekraft
OSMA-Bench untersucht kontrollierte Szenarien in einer Simulation. Das erleichtert reproduzierbare Vergleiche, deckt aber nicht automatisch Unsicherheiten realer Sensoren, wechselnde Lichtverhältnisse oder unvorhersehbare Bewegungen in einer Wohnung ab. Die Arbeit selbst begründet den Benchmark als Diagnoseinstrument für ausgeführte Bewegung; aus den vorliegenden Angaben folgt keine Garantie für den Einsatz unter realen Bedingungen. [3]
Die Vorsichtsstufen sind eine vom Benchmark festgelegte Ordnung. Sie strukturieren den Vergleich, bilden aber nicht sämtliche konkreten Risiken jeder häuslichen Situation ab. Die Studie unterscheidet etwa Lebewesen, fragile und robuste Gegenstände; für die Anwendung in einem Produkt wären zusätzlich dessen konkrete Umgebung, Sensorik und mögliche Folgen eines Kontakts zu berücksichtigen. Diese Einschränkung folgt aus dem Umfang des beschriebenen Szenariodesigns. [3]
Die arXiv-Seite führt eine Version 1 mit Einreichungsdatum 26. Oktober 2026. Die Hugging-Face-Seite nennt dagegen „Published on Oct 25“ und führt zugleich eine Einreichung durch den Autor am 28. Oktober auf. Die Plattformangaben zur Datierung sind damit nicht einheitlich. Die verfügbaren Einträge weisen die Arbeit als arXiv-Vorabversion aus; eine begutachtete Veröffentlichung ist in den hier vorliegenden Quellen nicht dokumentiert. [1][2]
Quellen
- [1] Paper page - Benchmarking Obstacle-Conditioned Safety in Household Robot Navigation — https://huggingface.co/papers/2610.34674 (abgerufen am 2026-10-28)
- [2] [2610.34674] Benchmarking Obstacle-Conditioned Safety in Household Robot Navigation — https://arxiv.org/abs/2610.34674 (abgerufen am 2026-10-28)
- [3] Benchmarking Obstacle-Conditioned Safety in Household Robot Navigation — https://arxiv.org/html/2610.34674v1 (abgerufen am 2026-10-28)
//Nächster Artikel
Robotik
ThinkWorld macht Weltveränderungen zum Lernsignal für RoboterThinkWorld nutzt Dynamikketten und Weltvorhersagen, um VLA-Modelle auch mit unbeschrifteten menschlichen Videos zu trainieren. [S1]
// Artikel teilen
Mehr zu Robotik & Humanoide
Alle Robotik-News- Rollback nutzt Weltmodelle, um Roboterentscheidungen rückwärts zu verbessern
Rollback nutzt gelernte Weltmodelle, um Roboterentscheidungen rückwärts zu prüfen. Die Autoren melden höhere Erfolgsraten in drei realen Aufgaben.
- Klagen gegen Lieferroboter: Streit um biometrische Daten in Chicago
Zwei Klagen in Chicago werfen Coco Robotics und Serve Robotics die unzulässige Erfassung biometrischer Daten vor. Beide Unternehmen bestreiten die Vorwürfe.
- RoboJudge trennt physikalische Plausibilität von Aufgabenerfüllung in Robotervideos
RoboJudge bewertet KI-generierte Robotervideos getrennt nach physikalischer Plausibilität und Aufgabenerfüllung und meldet 0,719 Korrelation.
- Nvidia veröffentlicht Flora-Modelle zur Auswertung von Robotikvideos
Nvidia stellt Flora-Modelle für Robotikvideos bereit. Die Kostenangaben, Benchmarks und Grenzen der automatischen Videoannotation im Überblick.
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.