
OS-Helix trainiert Desktop-Agenten für den Wechsel zwischen Oberfläche und Code
Mindverse News
KI-gestützt erstellt 4 Quellen Originalmeldung: huggingface.co Arbeitsweise
Das Wichtigste in Kürze
- OS-Helix soll GUI-Steuerung und Codeausführung in einer trainierten Agenten-Policy koordinieren, statt beide Fähigkeiten lediglich als Werkzeuge bereitzustellen. [1][2]
- Das Team berichtet auf OSWorld-Verified 66,44 Prozent Erfolgsrate für OS-Helix-27B-RL; der Wert liegt laut den Autoren 42,9 Prozent relativ über dem verglichenen hybriden Qwen3.5-27B-Modell. [2][3]
- Die Trainingspipeline kombiniert reproduzierbare Ubuntu-Umgebungen, überprüfbare Aufgaben, gefilterte GUI-Code-Beispiele und Online-Reinforcement-Learning. [2][3]
- Auf WindowsAgentArena erreicht das Ubuntu-trainierte Modell laut Repository 63,87 Prozent, ohne Windows-spezifische Trainingsdaten; einzelne Aufgabenkategorien entwickeln sich dabei unterschiedlich. [3]
- Die Ergebnisse stammen aus den Angaben der Autoren. Das Repository kennzeichnet Code, Daten und Modellartefakte zum erfassten Stand als geplant oder „Coming Soon“. [3]
// Inhalt · 6 Abschnitte
Ein Agent für Oberfläche und Systemzustand
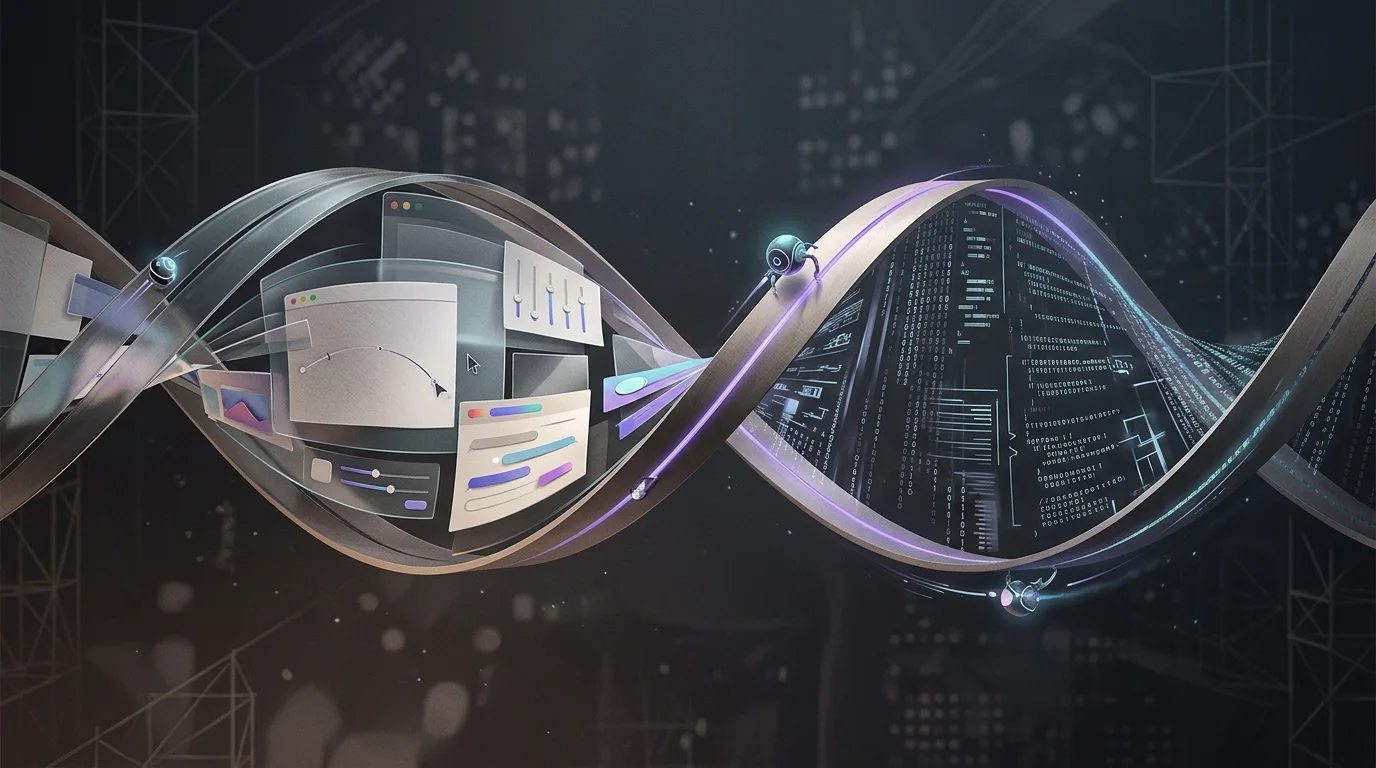
Desktop-Aufgaben lassen sich nicht immer allein durch sichtbare Klicks lösen: Neben der Bedienoberfläche spielen Dateien, Skripte und der Zustand des Betriebssystems eine Rolle. OS-Helix setzt an dieser Schnittstelle an. Die Studie beschreibt ein multimodales, end-to-end trainiertes System, das grafische Interaktionen und Codeausführung in einer gemeinsamen Handlungsstruktur zusammenführt. [1][2]
Nach der Darstellung im Projekt-Repository verarbeitet die Policy Bildschirmaufnahmen und kann GUI-Aktionen, Python- oder Bash-Ausführung sowie den Abschluss einer Aufgabe auswählen. Entscheidend ist damit nicht nur, dass ein Agent mehrere Werkzeuge aufrufen kann, sondern dass er lernen soll, wann welches Mittel sinnvoll ist und wann ein Ergebnis erneut geprüft werden sollte. [3]
- GUI-Aktionen geben dem Agenten Zugang zu sichtbaren Anwendungen und deren dargestelltem Zustand. [1][3]
- Code kann laut den Autoren präzise Operationen an Dateien und anderen strukturierten Artefakten ermöglichen. [1][3]
- OS-Helix trainiert die Auswahl und den Wechsel zwischen diesen Aktionsformen als Teil einer gemeinsamen Policy. [2][3]
Warum zusätzliche Werkzeugzugriffe nicht genügen
Die Autoren begründen ihren Ansatz mit einem diagnostischen Versuch: Bei einem Qwen3-VL-32B-Instruct-Modell sank die OSWorld-Erfolgsrate, als lediglich ein Codewerkzeug ergänzt wurde – von 34,17 auf 32,68 Prozent. Das ist ein Ergebnis aus dem Projektmaterial, kein allgemeiner Nachweis dafür, dass Codezugriff Desktop-Agenten grundsätzlich verschlechtert. Es stützt aber die engere These, dass ein zusätzlicher Werkzeugaufruf allein keine verlässliche Koordination lehrt. [1][3]
Trainingsdaten aus Anwendungen und echten Dateien
Für das Training erzeugt das Team nach eigener Darstellung ausführbare Ubuntu-Umgebungen, indem es Anwendungen mit passenden Datei-Artefakten kombiniert. Eine Präsentationsdatei kann beispielsweise in einer Präsentationsanwendung geöffnet und dort bearbeitet werden. Versionen sowie Start- und Initialisierungskonfigurationen sollen diese Umgebungen reproduzierbar machen. Das Inventar umfasst laut Repository 45 Anwendungseinträge aus Bereichen wie Büroarbeit, Programmierung, Grafik, Medien und Systemverwaltung. [3]
Auf dieser Grundlage erzeugt ein Erkundungsagent Aufgaben, indem er die jeweilige Anwendung und das Artefakt untersucht. Ein davon getrennter Evaluator prüft anschließend, ob der gewünschte Endzustand erreicht wurde, ohne eine bestimmte Lösung über die Oberfläche oder per Code vorzuschreiben. Für manche Zustände kommen regelbasierte Prüfungen zum Einsatz, für andere visuelle oder kombinierte Kriterien. Die Trennung soll nach dem Konzept der Autoren ermöglichen, Ergebnisse unabhängig vom Lösungsweg zu bewerten. [2][3]
Das Repository beziffert den erzeugten Bestand auf ungefähr 9.000 Anweisungen, 83.000 ungefilterte Desktop-SFT-Beispiele und 31.000 erfolgreiche, gefilterte Beispiele. Für die überwachte Feinabstimmung kombinieren die Autoren nach eigener Angabe die rund 31.000 erfolgreichen Desktop-Beispiele mit 40.000 allgemeinen multimodalen Beispielen. Fehlerhafte oder qualitativ unzureichende Handlungsabläufe werden vor der Verwendung aussortiert. [3]
- Die Aufgaben werden an konkrete Anwendungs- und Dateizustände gebunden. [3]
- Der Evaluator soll den Endzustand prüfen, ohne eine GUI- oder Codelösung vorzuschreiben. [2][3]
- Die Trainingspipeline kombiniert Desktop-Beispiele mit allgemeinem multimodalem Material. [3]
Prüfbarkeit und Grenzen der Aufgabenerzeugung
Das Team beschreibt zusätzliche Kontrollen: Aufgaben sollen auf Durchführbarkeit und Verständlichkeit geprüft, Evaluatoren kompiliert und gegen den Ausgangszustand getestet sowie ähnliche Aufgaben entfernt werden. Eine Übertragung über mehrere Anwendungen hinweg wird im Repository jedoch als begrenzter Prototyp eingeordnet; eine breitere Skalierung bleibt demnach offen. [3]
Überwachte Feinabstimmung und Online-Lernen
Die Policy startet mit überwachter Feinabstimmung auf gefilterten hybriden Handlungsabläufen. Anschließend führen die Autoren Online-Reinforcement-Learning in laufenden Ubuntu-Umgebungen durch. Das Projektmaterial nennt 1.000 Trainingsschritte und regelbasierte Belohnungen für überprüfbare Endzustände. Die Trainingsumgebung soll damit nicht nur vorab aufgezeichnete Beispiele auswerten, sondern Aktionen in einer aktiven Desktop-Sandbox trainieren. [2][3]
Für diese Phase schlagen die Autoren Step-balanced GSPO vor. Ihr Problem: Codeaktionen können aus vielen Tokens bestehen, während ein Klick oder Tastendruck kurz ist. Bei der beschriebenen Standardvariante von GSPO können lange Codeaktionen dadurch überproportional in die Gewichtung der Optimierung eingehen. Step-balanced GSPO mittelt nach dem Repository zunächst Log-Importance-Gewichte innerhalb einer Aktion und anschließend über Aktionsschritte, statt die Gewichtung an der bloßen Zahl der Assistant-Tokens auszurichten. [2][3]
In einem kontrollierten Vergleich erreichte Standard-GSPO laut Repository 60,47 Prozent Erfolg und einen Code-Aktionsanteil von 40,0 Prozent. Step-balanced GSPO kam auf 66,44 Prozent bei 26,1 Prozent Codeaktionen; die SFT-Ausgangspolitik lag bei 27,9 Prozent. Das spricht in diesem Versuch gegen die Annahme, mehr Codeaktionen seien automatisch besser. Die Autoren weisen zugleich darauf hin, dass die Methode keine gleichen Parametergradienten oder eine optimale Werkzeugwahl garantiert. [3]
- RL allein steigerte die Erfolgsrate in der angegebenen Ablation von 46,50 auf 48,20 Prozent. [3]
- Die Abfolge aus SFT und anschließendem RL erreichte 66,44 Prozent. [3]
- Die berichteten Ergebnisse sprechen dafür, dass die Feinabstimmung den größeren Anteil des Zuwachses liefert und RL darauf aufbaut. [3]
Was die Ablation zur Werkzeugkoordination zeigt
Eine weitere Ablation vergleicht denselben OS-Helix-Checkpoint mit und ohne Codezugriff. Ohne Codezugriff lag die Erfolgsrate bei 52,13 Prozent, mit Codezugriff bei 62,75 Prozent. Bei einem festen SFT-Budget von jeweils 10.000 Beispielen erreichte Training mit hybriden GUI- und Code-Demonstrationen 60,61 Prozent, gegenüber 57,56 Prozent bei GUI-Demonstrationen; bei beiden Varianten stand Code während der Auswertung zur Verfügung. Diese Vergleiche stützen die These, dass Training auf gemischten Abläufen mehr bewirkt als das bloße Freischalten eines Werkzeugs. [3]
Ergebnisse auf OSWorld-Verified
Auf OSWorld-Verified berichtet das Projekt für OS-Helix-27B eine Erfolgsrate von 62,75 Prozent. Der reproduzierte hybride Qwen3.5-27B-Vergleichswert beträgt 46,50 Prozent. Das entspricht einem Zuwachs von 16,25 Prozentpunkten beziehungsweise einer relativen Verbesserung von 35,0 Prozent, wie die Autoren sie angeben. Nach dem RL-Schritt steigt der Wert für OS-Helix-27B-RL auf 66,44 Prozent – 19,94 Prozentpunkte mehr als beim Vergleichswert und laut Abstract eine relative Verbesserung von 42,9 Prozent. [2][3]
Für OS-Helix-35B-A3B nennt das Repository 57,27 Prozent, gegenüber 42,84 Prozent für den hybriden Vergleichs-Backbone. Die Differenz beträgt 14,43 Prozentpunkte; die Autoren geben den relativen Zuwachs mit 33,7 Prozent an. Die Ergebnisse sind damit nicht nur für ein einzelnes Modellformat aufgeführt, beruhen aber weiterhin auf dem Evaluations- und Vergleichsaufbau der Studie. [2][3]
Die Zuwächse verteilen sich nicht gleichmäßig auf alle Aufgabenkategorien. Für das 27B-Modell vor RL weist die Ergebnistabelle beispielsweise 72,60 Prozent im Office-Bereich und 54,28 Prozent bei Workflows über mehrere Anwendungen aus. Nach RL steigen die ausgewiesenen Werte unter anderem bei Betriebssystem- und professionellen Aufgaben; Office und mehrstufige Workflows liegen dagegen nicht über dem SFT-Ergebnis. [3]
- OS-Helix-27B: 62,75 Prozent auf OSWorld-Verified, laut Autoren 35,0 Prozent relative Verbesserung gegenüber dem hybriden Vergleichswert. [2][3]
- OS-Helix-27B-RL: 66,44 Prozent, laut Autoren 42,9 Prozent relative Verbesserung gegenüber dem hybriden Vergleichswert. [2][3]
- OS-Helix-35B-A3B: 57,27 Prozent gegenüber 42,84 Prozent für den angegebenen hybriden Vergleichs-Backbone. [3]
Vergleichswerte sind nicht alle gleich gut vergleichbar
Das Repository unterscheidet zwischen reproduzierten Vergleichswerten für die passenden Backbones und weiteren Resultaten aus veröffentlichten Leaderboards. Zugleich weist es darauf hin, dass Budgets und Evaluationsharnesses veröffentlichter Vergleichssysteme voneinander abweichen können. Ein Ranking über sämtliche Modelle hinweg sollte deshalb vorsichtig gelesen werden. Auch ein separater Bericht von Chiosa merkt an, dass aus den Angaben nicht hervorgeht, ob OS-Helix und der Qwen3.5-Vergleich mit identischen Startgewichten begannen; der Vergleich belegt daher nicht isoliert, dass allein das Training den gesamten Unterschied verursacht. [3][4]
Transfer auf Windows – mit gemischtem Kategorienbild
Als Transferprüfung nennt das Team WindowsAgentArena. OS-Helix wurde demnach auf Ubuntu trainiert und erreichte nach einer Anpassung der Eingabeaufforderung 63,87 Prozent, ohne Windows-spezifische Trainingsdaten. Das Repository weist für das Modell Python-basierte Codeaktionen aus. Der Wert liegt 7,46 Prozentpunkte über dem dort angegebenen hybriden Qwen3.5-27B-Vergleichswert von 56,41 Prozent und 5,92 Punkte über OS-Helix-27B ohne RL mit 57,95 Prozent. [3]
Der Gesamtwert verdeckt unterschiedliche Entwicklungen nach Kategorien. In der Tabelle steigen die Ergebnisse von OS-Helix-27B zu OS-Helix-27B-RL etwa bei Web-, Code- und Medienaufgaben. Bei Systemaufgaben fällt der ausgewiesene Wert dagegen von 91,67 auf 75,00 Prozent; Office bleibt bei 39,53 Prozent und Utilities bei 75,00 Prozent. Der Transferwert ist deshalb kein Beleg für gleichmäßige Verbesserungen in allen Windows-Workflows. [3]
- WindowsAgentArena: 63,87 Prozent für OS-Helix-27B-RL laut Projektangaben. [3]
- Die Autoren berichten, dass dafür keine Windows-spezifischen Trainingsdaten verwendet wurden. [3]
- Die aufgeschlüsselten Kategorien zeigen sowohl Zuwächse als auch Rückgänge. [3]
Was Unternehmen aus dem Ergebnis ableiten können – und was nicht
Für Unternehmen ist die Architekturfrage relevant, wenn ein Arbeitsablauf sichtbare Bedienung mit Dateioperationen oder Skripten verbindet. OS-Helix untersucht genau diese Kombination und legt Messwerte für Ubuntu-Aufgaben sowie einen Transfer auf Windows vor. Analytisch lässt sich daraus ableiten, dass eine gemeinsam trainierte Entscheidungslogik für GUI und Code ein sinnvoller Gegenstand für Pilotprüfungen sein kann. Die Benchmarks belegen jedoch nicht, dass ein System damit bereits die Zuverlässigkeit, Sicherheit oder Wirtschaftlichkeit eines produktiven Unternehmensprozesses erreicht. [1][2][3]
In den bereitgestellten Angaben finden sich keine Resultate zu produktiven Unternehmenseinsätzen, Betriebskosten, Latenzen oder konkreten Zugriffsschutz- und Freigabeverfahren. Ebenso bleiben die gemeldeten Erfolgsraten Benchmark-Messungen der Autoren und keine unabhängige Bestätigung. Für eine Beschaffungs- oder Einsatzentscheidung wären daher zusätzliche Prüfungen in den eigenen Anwendungen, mit den eigenen Berechtigungsgrenzen und an relevanten Fehlerfällen nötig. Das ist eine Einordnung der Reichweite der vorgelegten Evidenz, kein von der Studie gemessenes Ergebnis. [2][3]
Auch die praktische Nachprüfbarkeit ist zum erfassten Stand eingeschränkt: Das GitHub-Repository kennzeichnet Trainings- und Evaluationscode, Daten sowie Modellartefakte als „Coming Soon“ beziehungsweise als für eine spätere Veröffentlichung geplant. Die Hugging-Face-Seite nennt zwar Projekt-, Modell- und Datensatzseiten, doch die vorliegenden Quellen belegen damit noch keine umfassend verfügbare Implementierung. [1][3]
Quellen
- [1] Paper page - OS-Helix: Unifying GUI Interaction and Code Execution in Native Computer-Using Agents — https://huggingface.co/papers/2610.22234 (abgerufen am 2026-10-19)
- [2] [2610.22234] OS-Helix: Unifying GUI Interaction and Code Execution in Native Computer-Using Agents — https://arxiv.org/abs/2610.22234 (abgerufen am 2026-10-19)
- [3] GitHub - OS-Copilot/OS-Helix · GitHub — https://github.com/OS-Copilot/OS-Helix (abgerufen am 2026-10-19)
- [4] How training helps desktop agents coordinate GUI and code - Chiosa — https://chiosa.app/papers/os-helix-unifying-gui-interaction-and-code-execution-in-native-computer-using-agents-2610-22234 (abgerufen am 2026-10-19)
//Nächster Artikel
Robotik
HexaShell lässt ein VLM eigene Werkzeuge für die Robotik programmierenHexaShell lässt ein VLM einen Dualarmroboter steuern und eigene Werkzeuge programmieren. Im RoboDojo-Benchmark zeigt sich eine klare Kontakthürde.
// Artikel teilen
Mehr zu KI-Coding
Alle Coding-News- Bluesky erweitert Attie um Vibe-Coding – und wirbt auf X
Bluesky erweitert Attie um Vibe-Coding für Spiele und Apps. Der Dienst bleibt in geschlossener Beta; die Werbung auf X trifft auf Kritik. [S1]
- ANTE trainiert Coding-Agenten, Änderungen vor der Ausführung zu bewerten
ANTE trainiert Coding-Agenten, Folgen von Änderungen vorab zu prognostizieren. Das Preprint berichtet bessere Benchmarkwerte, lässt aber Praxisfragen offen.
- Doc2Harness prüft, wie zuverlässig KI-Modelle Coding-Agent-Harnesses bauen
Doc2Harness testet 19 KI-Modelle beim Bau von Coding-Agent-Harnesses. Selbst der Spitzenreiter besteht nur 53,05 Prozent von 328 Fällen.
- KI-gestützte Programmierung und WebGPU: Was den aktuellen Boom um Three.js antreibt
Three.js verzeichnet wöchentliche Downloads in Millionenhöhe. Wie Vibe Coding, KI-Agenten und WebGPU die 3D-JavaScript-Bibliothek für Unternehmen verändern.
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
- Eigene Modelle und Assistenten trainierenBilden Sie einen digitalen Marken-Experten auf Ihrem Wissen aus.
- Dokumente und Daten analysierenAuswerten, vergleichen und Abweichungen automatisch erkennen.
- Die KI-Plattform für UnternehmenRollen, Freigaben und Abrechnung für den KI-Einsatz im ganzen Unternehmen.
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
//Chronik