
OpenHands verbindet Coding-Agenten mit Browser, Laufzeitumgebung und Evaluation
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 3 Quellen
Das Wichtigste in Kürze
- OpenHands ist eine offene Entwicklungsplattform, in der KI-Agenten Code schreiben, Kommandozeilen nutzen und im Web arbeiten können. [1]
- Die Plattform verbindet Agentenentwicklung, eine abgeschirmte Ausführungsumgebung, Zusammenarbeit mehrerer Agenten und Benchmark-Evaluation. [1][3]
- Die OpenHands-Arbeit wurde auf der ICLR 2025 angenommen; die arXiv-Version 3 wurde am 18. April 2025 aktualisiert. [1][3][7]
- Die Quellen nennen unterschiedliche Evaluationsumfänge: 15 Aufgaben in der arXiv-Fassung und 13 im OpenReview-Abstract. [1][3][7]
- OpenReview-Gutachter bewerteten die Plattform grundsätzlich positiv, verwiesen aber auch auf einfache implementierte Agenten, veraltete Benchmarks und offene Fragen zur Evaluationstiefe. [3]
Inhalt · 8 Abschnitte
- Eine Plattform für Agenten statt nur ein Coding-Assistent
- Ein gemeinsamer Rahmen für unterschiedliche Arbeitsweisen
- Ereignisstrom koordiniert die Arbeit mehrerer Agenten
- Sandboxing ist eine Architekturentscheidung, kein Sicherheitsnachweis
- Der Evaluationsumfang ist breit, die Zählung aber nicht einheitlich
- Gutachter sehen Nutzen, aber auch Grenzen der implementierten Agenten
- Was Unternehmen aus der Forschungsarbeit ableiten können
- Der Beitrag liegt in der integrierten Entwicklungsumgebung
- Quellen
Eine Plattform für Agenten statt nur ein Coding-Assistent
OpenHands ist als Umgebung konzipiert, in der KI-Agenten digitale Arbeitsabläufe ausführen können: Sie schreiben Code, bedienen eine Kommandozeile und navigieren im Web. Das unterscheidet den Ansatz von einem Werkzeug, das lediglich einzelne Codevorschläge erzeugt. Im Mittelpunkt der Forschungsarbeit steht eine Plattform, auf der Entwickler eigene Agenten implementieren und deren Verhalten in verschiedenen Aufgabenfeldern untersuchen können. [1][3]
Die Arbeit wurde zunächst im Juli 2024 auf arXiv eingereicht und in Version 3 am 18. April 2025 überarbeitet. OpenReview führt sie als angenommenen ICLR-2025-Beitrag; die Konferenz fand laut dem Publikationseintrag der University of Illinois vom 24. bis 28. April 2025 statt. Es handelt sich damit um einen Forschungsbeitrag und nicht um eine erstmalige Produktankündigung. [1][3][7]
Die Autoren beschreiben OpenHands als Gemeinschaftsprojekt aus akademischen und industriellen Beiträgen und nennen für ihre arXiv-Fassung mehr als 2.100 Beiträge von über 188 Mitwirkenden. Diese Angaben beschreiben den Entwicklungsstand, den die Autoren für die Arbeit dokumentieren; sie sind kein unabhängiger Nachweis für Nutzung oder Produktivität in Unternehmen. [1][7]
Ein gemeinsamer Rahmen für unterschiedliche Arbeitsweisen
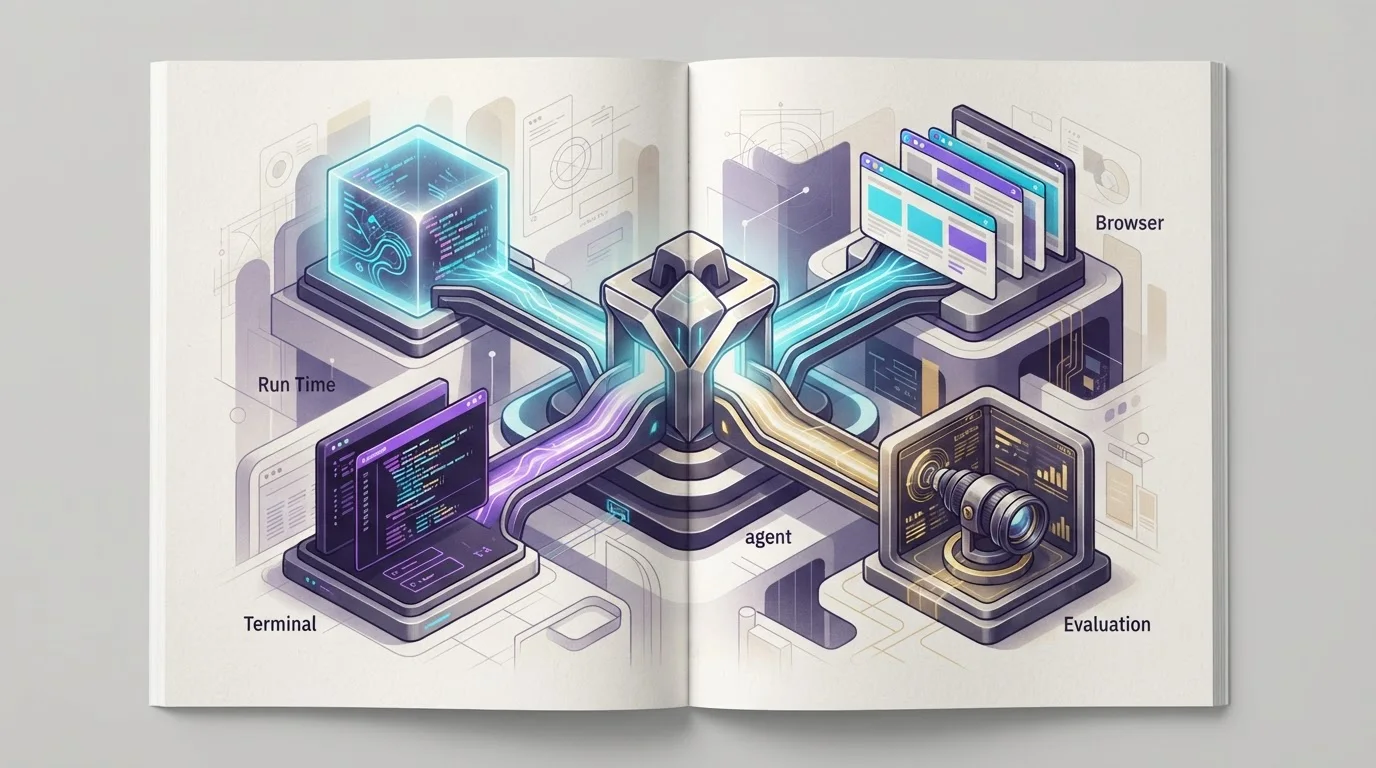
Der wesentliche Plattformgedanke besteht darin, mehrere Fähigkeiten in einem Entwicklungsrahmen zusammenzuführen. Neben dem Schreiben und Ausführen von Code gehören dazu die Interaktion mit einer Shell und das Bedienen eines Browsers. Die Autoren führen außerdem eine Umgebung für die Ausführung von Code, die Koordination mehrerer Agenten und die Einbindung von Benchmarks als Bestandteile der Plattform auf. [1]
Für Forschungsteams ist diese Zusammenführung relevant, weil sich dadurch Agenten für unterschiedliche Aufgaben in einem gemeinsamen Rahmen entwickeln und vergleichen lassen. Die Evaluationsbereiche der Arbeit reichen nach den Abstract-Angaben über Softwareentwicklung und Web-Browsing hinaus. Das ist zunächst eine Aussage über den Untersuchungsumfang: Daraus folgt nicht automatisch, dass ein einzelner Agent in allen Bereichen gleich leistungsfähig oder für einen produktiven Einsatz geeignet ist. [1][3]
Im OpenReview-Verfahren wird als weiterer Plattformbaustein AgentHub genannt, über den Nutzer eigene Agenten beisteuern können. Die Gutachter sehen darin einen Weg, verschiedene Agentenarchitekturen in einer gemeinsamen Umgebung zugänglich zu machen. Für Unternehmen kann ein solcher Ansatz die Erprobung eigener oder spezialisierter Agenten erleichtern; der tatsächliche Nutzen hängt jedoch davon ab, wie gut sich diese Agenten in die jeweiligen Entwicklungsprozesse integrieren lassen. [3]
Ereignisstrom koordiniert die Arbeit mehrerer Agenten
OpenHands setzt laut der Begutachtung auf eine ereignisbasierte Architektur für Zustandsverwaltung und Zusammenarbeit. In einer Antwort auf Rückfragen erläutern die Autoren, dass die Delegation über einen Ereignisstrom läuft: Ein Agent stellt eine Delegationsaktion ein; ein zentraler Controller leitet die Anfrage an einen passenden Unteragenten weiter und führt dessen Ergebnis über denselben Strom zurück. [3]
Die Unteragenten können auf bestimmte Aufgaben und den dafür nötigen Kontext beschränkt werden. Als konkrete Implementierungen nennen die Autoren einen Delegator, der Agenten für Repository-Analyse, Programmierung und Prüfung koordiniert, sowie einen Manager, der anhand von Beschreibungen und Einschränkungen passende Mikroagenten auswählt. Diese Beispiele zeigen, wie sich spezialisierte Arbeitsteilung auf der Plattform umsetzen lässt; sie belegen nicht, dass jede OpenHands-Konfiguration automatisch eine solche Struktur verwendet. [3]
Für den Betrieb in Unternehmen ist die Aufgabenteilung ein potenziell wichtiger Kontrollpunkt. Wenn Aufgaben und Ergebnisse über einen gemeinsamen Mechanismus laufen, kann ein Team grundsätzlich festlegen, welche Teilaufgaben spezialisierte Agenten bearbeiten. Das ist eine Analyse der beschriebenen Architektur, keine Aussage über bereits nachgewiesene Governance-, Protokollierungs- oder Fehlerkontrollfunktionen. Die verfügbaren Quellen belegen insbesondere nicht, dass Delegation allein Risiken durch fehlerhafte Agentenentscheidungen beseitigt. [3]
Sandboxing ist eine Architekturentscheidung, kein Sicherheitsnachweis
Die Plattform sieht nach Darstellung der Autoren eine abgeschirmte Laufzeitumgebung für Codeausführung vor. Das ist für Agenten wichtig, die nicht nur Text erzeugen, sondern Kommandos ausführen und mit Dateien oder Webdiensten interagieren können. OpenHands will diese Aktivitäten in einer kontrollierten Umgebung ermöglichen, statt sie unmittelbar im Hostsystem auszuführen. [1][3]
Die vorhandenen Angaben liefern jedoch keinen umfassenden unabhängigen Sicherheitsnachweis. Ein Gutachter fragte ausdrücklich nach den Schutzmaßnahmen gegen Ausbrüche aus der Sandbox und danach, ob die Umgebung gegen bekannte Schwachstellen getestet worden sei. Die im OpenReview-Auszug dokumentierten Antworten erläutern diese Sicherheitsfragen nicht. Deshalb lässt sich aus der Erwähnung einer Sandbox weder eine bestimmte Widerstandsfähigkeit noch eine Eignung für sensible Produktionssysteme ableiten. [3]
Für Sie als Verantwortliche in Entwicklung oder IT-Sicherheit bedeutet das: Die Laufzeitisolation ist ein relevantes Bauteil, ersetzt aber keine Prüfung der konkreten Konfiguration, Berechtigungen und erreichbaren Systeme. Diese Schlussfolgerung ergibt sich aus dem Unterschied zwischen einer beschriebenen Schutzarchitektur und den im Begutachtungsverfahren offengebliebenen Fragen; sie ist keine Zertifizierung oder Sicherheitsbewertung des Projekts. [1][3]
Der Evaluationsumfang ist breit, die Zählung aber nicht einheitlich
Die Autoren berichten über Tests auf anspruchsvollen Aufgaben aus Softwareentwicklung, Web-Browsing und weiteren Bereichen. Als Beispiele nennen sie SWE-Bench und WebArena. Die arXiv-Version 3 spricht von 15 Aufgaben; der Abstract auf OpenReview nennt 13. Auch der Eintrag der University of Illinois beschreibt eine Evaluation mit 15 Aufgaben. Die Quellen erläutern nicht, ob die Differenz auf eine überarbeitete Fassung, eine andere Zählweise oder eine abweichende Zusammenfassung zurückgeht. [1][3][7]
Diese Abweichung sollte bei Vergleichen berücksichtigt werden. Die Zahlen sind nicht ohne Weiteres als widersprüchliche Messergebnisse zu lesen, markieren aber eine Unklarheit darüber, welchen Umfang die jeweiligen Zusammenfassungen abbilden. Für eine belastbare Bewertung wären die genaue Aufgabenliste, die verwendeten Agenten- und Modellkonfigurationen sowie die Resultate je Benchmark entscheidend. Die hier dokumentierten Abstract-Angaben liefern diese Detailtiefe nicht. [1][3][7]
Auch die Annahme durch ICLR 2025 ordnet die Arbeit als begutachteten Konferenzbeitrag ein, ist aber kein Beleg dafür, dass OpenHands bei einzelnen Benchmarks den besten Stand erreicht. Die Gutachter würdigten die Breite der Evaluation; einer der im OpenReview-Eintrag zusammengefassten Kritikpunkte war zugleich, dass die Auswertung durch eine systematischere Erfassung von Erfolgen und Fehlschlägen vertieft werden könnte. [3][7]
Gutachter sehen Nutzen, aber auch Grenzen der implementierten Agenten
Die Rückmeldungen im OpenReview-Verfahren fallen nicht einheitlich aus, ergeben aber ein differenziertes Bild. Ein Gutachter bewertete die Arbeit als soliden Beitrag und hob die Agentenschnittstelle, Codeausführung und Web-Browsing-Funktionen hervor. Ein anderer beurteilte die Plattform ebenfalls positiv, hielt die bereits implementierten Agenten jedoch für vergleichsweise einfach. Als Beispiel nannte er den Browsing-Agenten, der auf einem einfachen WebArena-Agenten beruhe und nicht mit dem damaligen Spitzenstand konkurriere. [3]
In der Meta-Review wurden außerdem die Nutzung von MiniWoB++ als veraltet kritisiert und neuere Browser-Benchmarks als mögliche Ergänzung genannt. Die Gutachter sahen zudem Bedarf an tieferer Analyse der Agentenergebnisse. Diese Punkte beziehen sich auf die konkrete Forschungsfassung und ihre Evaluation; sie sind keine Feststellung, dass die Plattform als Ganzes ungeeignet wäre. Zugleich begrenzen sie, wie weit sich aus den Ergebnissen Aussagen über aktuelle Agenten oder reale Unternehmensabläufe ableiten lassen. [3]
Die Autoren positionieren OpenHands gegenüber anderen Frameworks als breiter angelegten Ansatz, der unter anderem Laufzeitumgebung, Terminal, Browser und Dateisystem integriert. Diese Einordnung stammt aus ihrer Antwort auf Gutachterfragen. Sie sollte nicht mit einem unabhängigen, systematischen Leistungsvergleich verwechselt werden: Die Rückmeldungen vermerken selbst, dass relevante Vergleichssysteme in der Arbeit nicht vollständig berücksichtigt worden seien. [3]
Was Unternehmen aus der Forschungsarbeit ableiten können
Für technische Entscheider ist OpenHands vor allem als Infrastrukturansatz interessant: Die Plattform richtet sich nicht nur auf die Leistung eines einzelnen Sprachmodells, sondern auch auf die Umgebung, in der Agenten handeln, Aufgaben abgeben und anhand von Benchmarks geprüft werden. Die Autoren veröffentlichen das Projekt unter der MIT-Lizenz. Das schafft nach den Angaben der Arbeit eine offene Grundlage zur Untersuchung und Erweiterung, sagt für sich genommen aber nichts über Support, Betriebskosten oder die organisatorische Einsatzreife aus. [1][3]
Eine mögliche Anwendung liegt in kontrollierten Pilotprojekten, in denen Unternehmen repetitive Entwicklungsaufgaben zunächst in einer abgegrenzten Umgebung untersuchen. Das ist eine betriebliche Schlussfolgerung aus den beschriebenen Fähigkeiten, kein von den Quellen nachgewiesener Produktivitätseffekt. Der Forschungsbeitrag enthält in den hier verfügbaren Angaben weder einen belastbaren Nachweis für Zeitersparnis noch einen quantifizierten Vergleich mit menschlichen Entwicklungsteams. [1][3]
Für eine Investitionsentscheidung sollten Sie deshalb drei Fragen getrennt behandeln: Welche Agenten sind für den konkreten Arbeitsablauf tatsächlich implementiert? Wie werden Ausführung, Zugriffsrechte und Fehlerfolgen in der eigenen Umgebung abgesichert? Und welche Benchmark-Ergebnisse sind für die eingesetzten Modelle und Aufgaben reproduzierbar? Die Gutachterhinweise zu Agentenqualität, Benchmark-Aktualität und Evaluationstiefe unterstreichen, warum ein Plattformversprechen und ein belastbarer Wirksamkeitsnachweis nicht dasselbe sind. [3]
Der Beitrag liegt in der integrierten Entwicklungsumgebung
OpenHands bündelt in einer offenen Plattform mehrere Bausteine, die für handlungsfähige Software-Agenten benötigt werden: Werkzeuge zur Interaktion mit Code und Web, eine isolierte Laufzeit, Möglichkeiten zur Agentendelegation und eine Einbindung von Benchmarks. Das ist der zentrale Forschungsbeitrag, den die Autoren vorstellen. Die Begutachtung bestätigt das Interesse an dieser Infrastruktur, macht aber zugleich deutlich, dass Plattformbreite allein weder überlegene Agentenleistung noch hinreichende Sicherheit garantiert. [1][3]
Für die B2B-Praxis ist die Arbeit daher eher als technischer Rahmen zur Entwicklung und Erprobung von Agenten zu lesen denn als Nachweis, dass sich komplexe Entwicklungsarbeit bereits zuverlässig automatisieren lässt. Die offenen Punkte betreffen gerade die Übergänge vom Rahmen zur Anwendung: die konkrete Leistungsfähigkeit der Agenten, die Qualität der Auswertung und die Absicherung ausführbarer Aktionen. [3]
Quellen
- [1] [2407.16741v3] OpenHands: An Open Platform for AI Software Developers as Generalist Agents — https://arxiv.org/abs/2407.16741v3 (abgerufen am 2026-11-10)
- [3] OpenHands: An Open Platform for AI Software Developers as Generalist Agents | OpenReview — https://openreview.net/forum?id=OJd3ayDDoF (abgerufen am 2026-11-10)
- [7] OPENHANDS: AN OPEN PLATFORM FOR AI SOFTWARE DEVELOPERS AS GENERALIST AGENTS - Illinois Experts — https://experts.illinois.edu/en/publications/openhands-an-open-platform-for-ai-software-developers-as-generali (abgerufen am 2026-11-10)
Nächster Artikel
Coding
KI-Coding-Agenten verändern den Berufseinstieg – die Ausbildung bleibt entscheidendKI-Coding-Agenten verändern Softwareteams. Warum weniger Einstiegsstellen zum Wissensproblem werden können und welche Befunde die Entwicklung bislang stützen.
Artikel teilen
Mehr zu KI-Coding
Alle Coding-News- Mistral Large 4 setzt bei Coding Akzente, bleibt im Gesamtvergleich aber zurück
Mistral Large 4 überzeugt bei Coding, Tempo und API-Kosten. Im Gesamtindex liegt das Modell jedoch hinter führenden chinesischen und US-Systemen.
- iX-Workshop setzt auf praktische Arbeit mit KI-Coding-Assistenten
Ein iX-Workshop vermittelt KI-gestützte Programmierung mit Copilot, Spec-Driven Development und Agentic Coding. Was das Angebot abdeckt – und was offenbleibt.
- GitHub bündelt Copilot-Zugang mit Enterprise Cloud – Verbrauchskosten bleiben relevant
GitHub bündelt Copilot-Zugang für Enterprise-Cloud-Kunden. Preise, manuelle Zuweisung, Credits und die Kostenversprechen von Copilot Fusion im Überblick. [S1]
- GitHub sieht TypeScript weiter vorn – KI-Agenten verändern die Projektpraxis
GitHub meldet mehr KI-beteiligte Pull Requests und anhaltende TypeScript-Nutzung. Die Zahlen zeigen Trends, belegen aber keine eindeutige Ursache.
Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Recherchieren Sie KI-News wie diese selbst – mit Mindverse Studio.
7 Tage kostenlos testen – ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
Chronik