
GeoState trennt Szenengeometrie von Kamerabewegung bei 3D-Prognosen
Mindverse News
KI-gestützt erstellt 3 Quellen Originalmeldung: huggingface.co Arbeitsweise
Das Wichtigste in Kürze
- GeoState soll verhindern, dass ein 3D-Weltmodell Veränderungen durch Kamerabewegung mit tatsächlichen Veränderungen der Szene verwechselt. [1] [2]
- Ein Scene Tokenizer verdichtet Geometrieinformationen mehrerer Ansichten zu einem festen Szenenzustand; ein Decoder erzeugt daraus Tiefenkarten für gewählte Kameraperspektiven. [2]
- Auf Waymo berichten die Autoren für einen Prognosehorizont von zwei Sekunden einen AbsRel-Wert von 0,127, gegenüber 0,213 für VGGT-World. Die Verfahren verwenden dabei unterschiedliche Regeln zur Skalenanpassung. [4]
- Ablationen und Tests mit wechselnden Blickwinkeln stützen den Ansatz, belegen aber weder eine allgemeine Leistungsfähigkeit außerhalb von Fahrszenen noch einen direkten Nutzen für Planung oder autonome Fahrzeugsteuerung. [4]
// Inhalt · 7 Abschnitte
- Warum Kamerabewegung die Vorhersage erschwert
- Vom Mehrkamera-Bild zum kompakten Szenenzustand
- Zukunftszustand und Kamerapfad werden getrennt modelliert
- Waymo-Ergebnisse zeigen einen Vorteil – mit Vergleichsvorbehalt
- Ablationen prüfen die Vorhersagbarkeit der Repräsentation
- Mehrere Ansichten, aber kein Nachweis allgemeiner 3D-Genauigkeit
- Bedeutung für Unternehmen: Forschungsbefund, keine Einsatzfreigabe
- Quellen
Warum Kamerabewegung die Vorhersage erschwert
3D-Weltmodelle sollen nicht nur künftige Bilder erzeugen, sondern räumliche Eigenschaften einer Umgebung über die Zeit abbilden. Dafür können sie Merkmale nutzen, die Geometrie-Grundlagenmodelle aus Bilddaten gewinnen. Der Nachteil solcher Merkmale: Sie hängen oft davon ab, aus welcher Perspektive die Szene beobachtet wird. Bewegt sich die Kamera, können sich die Merkmale deshalb verändern, obwohl die zugrunde liegende Umgebung gleich bleibt. [1] [2]
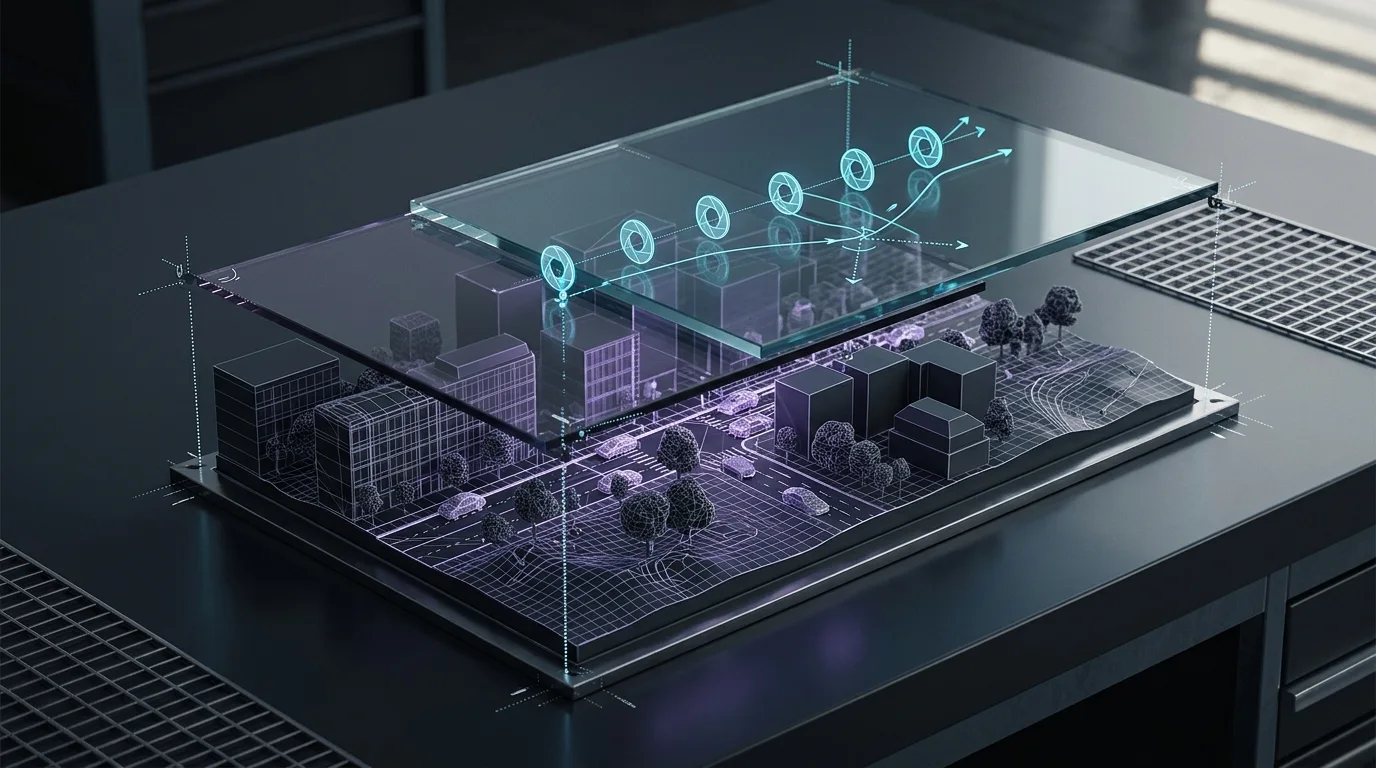
Ein zeitliches Modell muss dann zwei Ursachen für Veränderungen in seiner Repräsentation auseinanderhalten: tatsächliche Dynamik, etwa Bewegung in der Szene, und Effekte der Beobachtung, die aus der Kamerabewegung entstehen. Die Autoren argumentieren, dass diese Vermischung die Vorhersage erschwert, insbesondere über längere Zeiträume. GeoState setzt an dieser Repräsentationsebene an: Der Zustand soll beschreiben, welche Geometrie die Szene hat; die Kamera soll erst bestimmen, wie diese Geometrie beobachtet wird. [2]
Das ist eine andere Schwerpunktsetzung als bei Modellen, die geometrische Merkmale direkt als zeitliche Zustände vorhersagen. GeoState versucht nicht, Kamerabewegung aus dem Gesamtsystem zu entfernen. Stattdessen trennt es die Vorhersage des Szenenzustands von der späteren Abfrage aus einer bestimmten Perspektive. [1] [2]
Vom Mehrkamera-Bild zum kompakten Szenenzustand
Die Methode beginnt mit synchronisierten Mehrkamera-Beobachtungen. Ein eingefrorenes Geometrie-Grundlagenmodell extrahiert daraus Merkmale und geometrische Informationen in einem gemeinsamen Koordinatensystem. Der Scene Tokenizer fasst diese Eingaben anschließend zu einem GeoState zusammen, der nicht an eine einzelne Eingabekamera gebunden sein soll. In der beschriebenen Konfiguration besteht der Zustand aus 512 Tokens; seine Größe bleibt damit unabhängig davon, wie viele Quellansichten zusammengeführt werden. [2]
In die Zusammenführung fließen nicht nur Merkmale aus dem Grundlagenmodell ein. Die Autoren ergänzen sie um geometrische Hinweise wie 3D-Punkte, Konfidenzwerte, Kameraposen und Blickstrahlen. Die Idee ist, Informationen aus mehreren Ansichten in einer gemeinsamen Szenendarstellung nutzbar zu machen, statt für jede Kamera eine eigene dichte Repräsentation als Vorhersagezustand fortzuschreiben. [2]
Der Decoder erhält den GeoState und eine Abfragekamera. Deren Strahlen werden mit dem Szenenzustand verarbeitet, um eine Tiefenkarte für den gewünschten Blickwinkel zu erzeugen. Nach Darstellung der Arbeit kann derselbe Zustand aus mehreren Perspektiven abgefragt werden, ohne die Szene für jede Perspektive erneut aus den Eingabebildern zu kodieren. [1] [2]
Für Unternehmen ist diese Aufgabenteilung analytisch interessant, wenn ein System räumliche Vorhersagen für wechselnde Kameraperspektiven bereitstellen soll: Die Szene und die Beobachtung werden als getrennte Größen behandelt. Das ist zunächst eine Eigenschaft der Modellarchitektur, kein Nachweis, dass sich dadurch bestehende Produktionssysteme einfacher oder kostengünstiger betreiben lassen. Die bereitgestellten Quellen nennen keine Laufzeitmessungen. [2] [4]
Zukunftszustand und Kamerapfad werden getrennt modelliert
Auf dem GeoState setzt ein autoregressives Weltmodell auf. Es nutzt vier historische Szenenzustände als Kontext und sagt daraus künftige Zustände voraus. Die Vorhersage erfolgt als Änderung gegenüber dem letzten Zustand. Damit soll das zeitliche Modell die Entwicklung der Szene abbilden, während perspektivabhängige Veränderungen erst bei der Dekodierung berücksichtigt werden. [2]
Für die Ausgabe wird ein vorhergesagter Szenenzustand mit einer Zukunftskamera kombiniert. Diese Kamera kann laut Arbeit entweder extern vorgegeben oder durch ein separat trainiertes Kameramodell prognostiziert werden. Die Trennung erlaubt grundsätzlich, denselben vorhergesagten Zustand mit unterschiedlichen Abfragekameras zu untersuchen. Sie bedeutet aber auch, dass die Qualität einer Tiefenprognose von mehr als dem GeoState-Weltmodell abhängen kann: Eine vorhergesagte Kamera bestimmt mit, welche Ansicht dekodiert wird. [1] [2]
Ein weiterer Schwerpunkt ist die Maßstabskonsistenz. GeoState verwendet nach der detaillierten Auswertung einen aus dem beobachteten Kontext abgeleiteten Maßstab für den gesamten Vorhersageverlauf und verzichtet auf eine separate Skalenanpassung für jeden zukünftigen Frame. Das ist methodisch relevant, weil eine nachträgliche Anpassung anhand künftiger Referenzdaten die Interpretation eines Prognosevergleichs verändern kann. [1] [4]
Waymo-Ergebnisse zeigen einen Vorteil – mit Vergleichsvorbehalt
Die Autoren testen die Tiefenvorhersage auf Waymo und vergleichen GeoState unter anderem mit VGGT-World. Für einen Horizont von zwei Sekunden weist die detaillierte Ergebnisdarstellung für GeoState einen absoluten relativen Tiefenfehler (AbsRel) von 0,127 und einen δ₁-Wert von 0,848 aus. VGGT-World erreicht dort AbsRel 0,213 und δ₁ 0,731. Die Arbeit stellt den Unterschied beim AbsRel als relative Verringerung um 40,4 Prozent dar. [4]
AbsRel beschreibt den absoluten Tiefenfehler relativ zur Referenztiefe. δ₁ gibt den Anteil gültiger Pixel an, bei denen das Verhältnis zwischen geschätzter und Referenztiefe – in der jeweils günstigeren Richtung – unter 1,25 liegt. Beide Kennzahlen beziehen sich in der ausgewerteten Darstellung auf gültige, auf Bildpixel projizierte LiDAR-Punkte und werden über Frames gemittelt. [4]
Die Zahlen sind nicht als vollständig kontrollierter Vergleich zu lesen. GeoState verwendet eine einmalige Maßstabskalibrierung aus der letzten beobachteten Frontkameraansicht, während VGGT-World eine Skalenanpassung pro Ziel-Frame nutzt; auch FR3D wird mit einer Anpassung von Maßstab und Verschiebung pro Frame beschrieben. Zudem können sich die von den Verfahren verwendeten vorhergesagten Kameratrajektorien unterscheiden. Der Vergleich belegt damit nicht isoliert, dass allein die Entkopplung der Ansicht den gesamten Abstand verursacht. [4]
Auch ein direkter Vergleich mit einer unveränderten Szene ist aufschlussreich: Für zwei Sekunden und vorhergesagte Kameras nennt die Quelle AbsRel 0,127 für GeoState und 0,132 für Copy-Last, das einen Zustand beibehält und ihn aus den künftigen Kameras dekodiert. Mit tatsächlichen Zukunftskameras liegen die Werte bei 0,099 beziehungsweise 0,108. Diese Ergebnisse sprechen dafür, dass die Vorhersage des Szenenzustands einen Beitrag leisten kann; die relativ kleinen Abstände in diesem Vergleich zeigen zugleich, wie wichtig die Perspektivbehandlung bleibt. [4]
Ablationen prüfen die Vorhersagbarkeit der Repräsentation
Ein besserer Tiefenwert könnte grundsätzlich auch darauf beruhen, dass eine Repräsentation bereits bei der Rekonstruktion einer Szene Vorteile hat. Eine Ablation vergleicht deshalb laut Quelle GeoState mit einer komprimierten Merkmalsrepräsentation, die dasselbe Weltmodell und dasselbe Trainings- und Auswertungssetup verwendet. Bei der Rekonstruktion liegen die AbsRel-Werte nahe beieinander: 0,072 für GeoState und 0,074 für die Vergleichsrepräsentation. [4]
Bei der vorhergesagten Tiefe nach zwei Sekunden fällt der Abstand größer aus: GeoState erreicht AbsRel 0,133 und δ₁ 0,834, die komprimierte Merkmalsvariante 0,144 und 0,804. Das passt zur These, dass ein von der Ansicht entkoppelter Zustand zeitlich leichter vorherzusagen sein könnte. Die Ablation beweist jedoch nicht, dass View-Decoupling allein für den Unterschied verantwortlich ist; dafür müssten andere mögliche Einflüsse ebenfalls ausgeschlossen werden. [4]
Die Hauptauswertung nutzt nach der bereitgestellten Analyse zudem zusätzliche seitliche Waymo-Kameras. Ein Front-only-Kontrollversuch zeigt laut derselben Quelle weiterhin einen Vorteil gegenüber externen Prognoseverfahren, wobei Unterschiede bei den Regeln zur Maßstabsanpassung bestehen bleiben. Das mindert die Sorge, dass das Ergebnis ausschließlich auf den zusätzlichen Seitenansichten beruht, ersetzt aber keinen Vergleich unter vollständig identischen Bedingungen. [4]
Mehrere Ansichten, aber kein Nachweis allgemeiner 3D-Genauigkeit
Für einen Cross-View-Test wird derselbe vorhergesagte GeoState aus unterschiedlichen Kamerapositionen dekodiert. Die Autoren vergleichen die daraus entstehenden Tiefen nach einer gegenseitigen Reprojektion. Bei den größten getesteten Perspektivabweichungen und einem Horizont von zwei Sekunden beträgt der symmetrische Reprojektionsfehler laut Quelle 0,096 für vorhergesagte Zustände und 0,091 für aus Beobachtungen kodierte Zustände. [4]
Dieser Test untersucht, ob die Tiefen aus verschiedenen Blickwinkeln zueinander passen. Er misst nicht unmittelbar, wie genau die rekonstruierte Geometrie im Verhältnis zur physischen Wirklichkeit ist. Hinzu kommt, dass für den beobachtungsbasierten Referenzzustand eine Maßstabsinformation aus dem Zielzeitpunkt und dortiger LiDAR-Kalibrierung verwendet wird, während GeoState seinen historischen Ankermaßstab beibehält. Die Werte sind deshalb als Hinweis auf perspektivübergreifende Konsistenz zu verstehen, nicht als alleiniger Beleg für absolute geometrische Genauigkeit. [4]
Die Arbeit berichtet außerdem über Zero-Shot-Übertragungen auf KITTI und nuScenes. Das deutet auf eine Prüfung außerhalb des Waymo-Auswertungssatzes hin, bleibt aber innerhalb der untersuchten Fahrszenarien. Aus diesen Tests folgt kein Nachweis für beliebige Umgebungen, andere Robotikaufgaben oder eine allgemeine 3D-Simulation. [1] [2] [4]
Bedeutung für Unternehmen: Forschungsbefund, keine Einsatzfreigabe
Für Anbieter und Anwender von Perzeptions- oder Simulationssystemen ist der Ansatz als Architekturentscheidung relevant: Eine Repräsentation, die Szenengeometrie von der Abfrageperspektive trennt, könnte es erleichtern, Vorhersagen aus mehreren Kamerawinkeln zu untersuchen. Die Studie liefert dafür Ergebnisse zu Tiefenprognosen und perspektivübergreifender Konsistenz in Fahrszenen. Eine Übertragbarkeit auf betriebliche Systeme lässt sich daraus jedoch nicht ohne eigene Tests ableiten. [1] [2] [4]
Insbesondere ist GeoState in den bereitgestellten Ergebnissen ein Modell zur geometrischen Vorhersage, kein demonstriertes Planungssystem. Die Quellen weisen keine Erprobung von Fahrzeugentscheidungen, Interaktionen mit anderen Verkehrsteilnehmern oder einer vollständigen autonomen Fahrfunktion aus. Auch Laufzeit und Rechenaufwand werden in der detaillierten Auswertung nicht berichtet. Diese offenen Punkte sind für eine technische Bewertung ebenso wichtig wie die erreichten Tiefenfehler. [4]
Der belastbare Kern des Befunds ist damit begrenzt, aber konkret: Die Autoren schlagen vor, Szenengeometrie und Kameraperspektive in getrennten Modellkomponenten zu behandeln. Ihre Waymo-Ergebnisse und Ablationen stützen diese Designentscheidung für die untersuchte Tiefenvorhersage; Vergleichsbedingungen, Skalenbehandlung und der enge Anwendungskontext setzen der Interpretation jedoch Grenzen. Für Unternehmen ist GeoState daher vor allem ein Forschungsansatz, dessen Nutzen für den eigenen Daten- und Einsatzbereich separat validiert werden müsste. [1] [2] [4]
Quellen
- [1] Paper page - GeoState: Learning View-Decoupled Geometry States for 3D World Modeling — https://huggingface.co/papers/2610.22343 (abgerufen am 2026-10-19)
- [2] GeoState: Learning View-Decoupled Geometry States for 3D World Modeling — https://arxiv.org/html/2610.22343v1 (abgerufen am 2026-10-19)
- [4] GeoState: Learning View-Decoupled Geometry States for 3D World Modeling | alphaXiv — https://www.alphaxiv.org/abs/2610.22343 (abgerufen am 2026-10-19)
//Nächster Artikel
Bild & Video
Paper entkoppelt bei Videogenerierung Modellfenster und Ausgabe [S2]Ein Paper trennt Modellfenster und Ausgabegranularität bei interaktiver Videogenerierung. Die Autoren berichten Qualitäts- und Latenztests mit klaren Grenzen. [S2][S3]
// Artikel teilen
Mehr zu Bild- & Video-KI
Alle Bild & Video-News- PPMem setzt auf kompakte 3D-Flächen als Langzeitgedächtnis für Videomodelle
PPMem speichert Szenen als kompakte 3D-Flächen und soll so kohärente Videogenerierung über lange Sequenzen und wechselnde Blickwinkel ermöglichen. [S1]
- OmniCompass soll Video-KI über Zeit, Raum und Audio systematisch prüfen
OmniCompass bündelt Video-KI-Tests zu Zeit-, Orts- und Audioverständnis und zeigt Schwächen bei präziser Verortung und Referenzkonsistenz.
- FLUX.3 Image Klein in Diffusers: Architektur, Layout-Steuerung und Systemanforderungen im Überblick
Black Forest Labs veröffentlicht FLUX.3 Image Klein mit nativer Diffusers-Unterstützung, Bounding-Box-Layout-Steuerung sowie FP8- und NVFP4-Quantisierung.
- FlashVSR+: Effiziente 4K-Video-Super-Resolution durch hybride Attention und Reward-Distillation
FlashVSR+ ermöglicht ungekachelte 4K-Video-Super-Resolution auf einer RTX 4090 durch hybride Attention und Reward-Yield Distribution Matching.
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
- Dokumente und Daten analysierenAuswerten, vergleichen und Abweichungen automatisch erkennen.
- Eigene Modelle und Assistenten trainierenBilden Sie einen digitalen Marken-Experten auf Ihrem Wissen aus.
- Die KI-Plattform für UnternehmenRollen, Freigaben und Abrechnung für den KI-Einsatz im ganzen Unternehmen.
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
//Chronik
Rund um den 19. Oktober 2026
← Davor erschienen