
BLIP-Live macht Antwortzeit und Zurückhaltung bei Video-KI messbar
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 4 Quellen
Das Wichtigste in Kürze
- BLIP-Live verbindet einen annotierten Datensatz, eine Bewertungsmetrik und Verfahren zur Anpassung und zum Training von Video-Sprachmodellen. [1] [3]
- BLIP-Live-780K umfasst laut Manuskript 784.944 Antwortdatensätze aus 177.789 Videos; Menschen prüften und korrigierten Inhalt und Zeitpunkt der Antworten. [3]
- Die Metrik PAUC-F kombiniert Antwortqualität und -timing mit einer Präzisionskomponente, die auch unnötige oder wiederholte Antworten berücksichtigt. [3]
- Für ProactiveVideoQA berichtet das Paper einen mittleren PAUC-F-Wert von 49,08 gegenüber 34,01 für die Vergleichsmethode MMDuet2; die Autoren bezeichnen dies als relativen Zugewinn von 44 Prozent. [4]
- Die Ergebnisse beruhen auf Benchmarktests; reale Latenz, Betriebskosten und die Zahl nötiger Modellaufrufe belegt die Studie damit nicht. [4]
Inhalt · 8 Abschnitte
- Bei Live-Video zählt auch der richtige Zeitpunkt
- Ein Datensatz soll Antwortzeitpunkte mittrainieren
- PAUC-F berücksichtigt überflüssige Antworten
- Ein Harness und ein Trainingsschema setzen die Entscheidungen um
- Benchmarkwerte sind vielversprechend, aber nicht vollständig vergleichbar
- Ablationen testen Wiederholungen und Nutzerpräferenzen
- Für den Praxiseinsatz fehlen noch Latenz- und Betriebsdaten
- Streaming-Forschung bearbeitet weitere technische Engpässe
- Quellen
Bei Live-Video zählt auch der richtige Zeitpunkt
Ein Video-Sprachmodell, das einen vollständigen Clip auswertet, kann seine Antwort auf den gesamten sichtbaren Inhalt stützen. Ein System, das einen fortlaufenden Videostream verarbeitet, muss dagegen mit den Informationen arbeiten, die bis zum jeweiligen Zeitpunkt eingetroffen sind. Es muss deshalb wiederholt entscheiden, ob die vorhandenen Bilder eine Antwort rechtfertigen oder ob es besser ist, zunächst abzuwarten. [3]
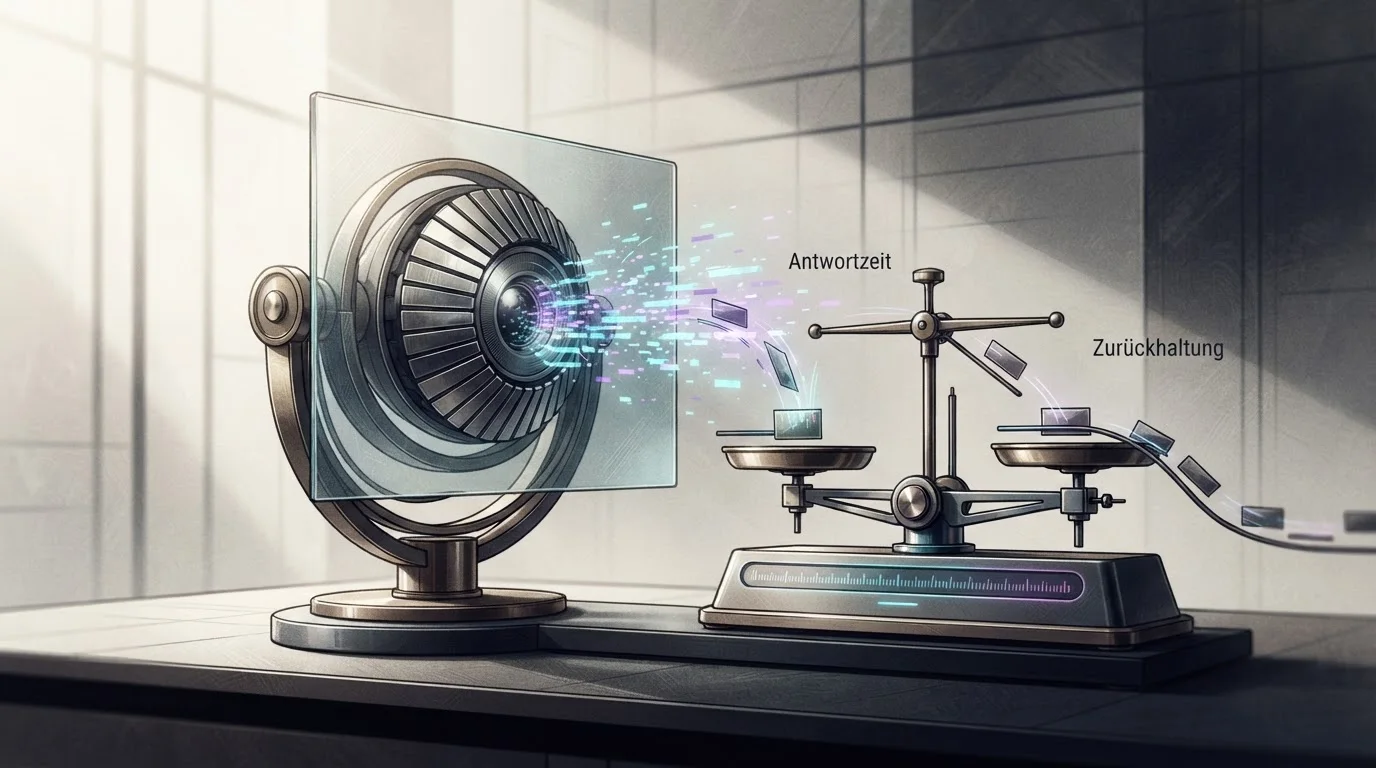
Diese Entscheidung beeinflusst mehr als die Geschwindigkeit. Eine korrekte Antwort kann verfrüht sein, wenn die entscheidenden Bildhinweise noch fehlen; eine verspätete Antwort kann den Zweck einer Live-Interaktion verfehlen. Auch wiederholte Antworten auf ein unverändertes Ereignis können die Interaktion beeinträchtigen. BLIP-Live setzt genau bei diesem Zusammenspiel aus Antwortinhalt, Zeitpunkt und Schweigen an. [1] [3]
Das Framework stammt von Salesforce AI Research. Das arXiv-Manuskript ist als Version 1 auf den 16. November 2026 datiert; die Hugging-Face-Seite nennt den 15. November als Veröffentlichungsdatum und den 19. November als Zeitpunkt der Einreichung durch den Paper-Verfasser. Die bereitgestellten Einträge erklären die Abweichung zwischen den Plattformdaten nicht. [1] [3]
Benchmark-Vergleich
PAUC-F-Werte auf ProactiveVideoQA
Die Autoren des Papers berichten die mittleren PAUC-F-Werte für BLIP-Live-Qwen und MMDuet2.
PAUC-F Skala 0 bis höchster Wert
- BLIP-Live-Qwen Im Fokus 49,08 Punkte
- MMDuet2 34,01 Punkte
Hinweis: Der Mittelwert fasst WEB, EGO, TV und VAD zusammen; GPT-4.1 dient als Bewertungsmodell.
Quelle:[3] alphaxiv.org
Stand 19.11.2026
Daten KI-gestützt aus den Quellen des Artikels übernommen.
Ein Datensatz soll Antwortzeitpunkte mittrainieren
Für das Training entwickelten die Forschenden BLIP-Live-780K. Das Manuskript zählt 784.944 Antwortdatensätze aus 177.789 Videos und Fragen. Zu jeder Frage gehört eine zeitlich verankerte Folge natürlicher Antworten; die Annotationen erfassen außerdem Zeitpunkte, an denen keine Antwort erfolgen soll. Die Auflösung der erfassten Entscheidungen beträgt eine Sekunde. [3]
Die Erstellung erfolgt in mehreren Schritten. Zunächst erzeugt ein Vision-Language-Modell mögliche Fragen sowie Antworten und Schweigephasen. Dieses Modell erhält das gesamte Video, soll sich bei jeder Antwort aber nur auf bis dahin sichtbare Hinweise stützen. Damit daraus keine ungeprüften Vorgriffe auf spätere Szenen in die Trainingsdaten gelangen, kontrollieren menschliche Annotatoren die Gültigkeit der Frage, den Antwortinhalt und den Zeitpunkt. Fachkundige Prüfer bewerten die überarbeiteten Stichproben zusätzlich; unzureichende Chargen gehen zur Korrektur zurück. [3]
Die menschliche Prüfung veränderte den automatisch erzeugten Bestand deutlich: Von 893.562 vorgeschlagenen Antwortdatensätzen wurden 40,51 Prozent gelöscht und 11,69 Prozent verändert; zusätzlich kamen 28,35 Prozent neue Datensätze hinzu. Die Zahlen beziehen sich auf die ursprünglichen Vorschläge, wobei hinzugefügte und bearbeitete Einträge unterschiedliche Vorgänge darstellen. Sie zeigen, dass das Ergebnis nicht einfach eine unveränderte Übernahme maschinell erzeugter Labels ist. [3]
Als Ausgangsmaterial nennt das Paper Videos aus LLaVA-Video-178K. Die Autoren stellen eine öffentliche Veröffentlichung von Daten und Code in Aussicht; aus den vorliegenden Angaben geht jedoch nicht hervor, dass beides zum Zeitpunkt der Ankündigung bereits verfügbar war. [1] [3]
PAUC-F berücksichtigt überflüssige Antworten
Die Forschenden schlagen mit PAUC-F eine Metrik vor, die rechtzeitige und qualitativ bewertete Antworten mit der Präzision des Auslösens verbindet. Ausgangspunkt ist PAUC, das Antworten innerhalb eines annotierten Zeitfensters nach Qualität und Zeitpunkt bewertet. Laut Paper hat dieser Ansatz eine Schwäche: Antworten außerhalb des vorgesehenen Fensters fließen nicht in die Bewertung ein, und mehrere Antworten innerhalb des Fensters können unzureichend bestraft werden. [3]
PAUC-F ergänzt deshalb eine Präzisionskomponente. Für jede annotierte Antwortgelegenheit zählt höchstens die früheste Antwort innerhalb des passenden Zeitfensters, sofern ein Bewertungsmodell ihr zumindest teilweise korrekte Inhalte zuordnet. Alle ausgegebenen Antworten gehen in die Gesamtzahl der Auslösungen ein – auch solche außerhalb des Fensters. Zusätzliche oder unpassend getimte Antworten erhöhen damit den Nenner, ohne einen zusätzlichen Beitrag zum Zähler zu leisten. [3] [4]
Die beiden Bestandteile werden über ein harmonisches Mittel zusammengeführt. Dadurch kann eine hohe Bewertung für das Timing eine schwache Auslösepräzision nicht einfach ausgleichen. Ein Gewichtungsparameter übernimmt dabei die Abwägung zwischen Antwortqualität und zeitlicher Passung aus PAUC. Das macht PAUC-F zu einer konkreten Operationalisierung des Zielkonflikts, nicht zu einem Nachweis, dass ein Modell in jeder Anwendung die für Nutzer beste Antwortstrategie gewählt hat. [3]
Für Unternehmen ist diese Unterscheidung bei der Evaluation relevant: Eine Kennzahl, die nur zählt, ob ein System irgendwann eine passende Antwort gibt, bildet nicht automatisch ab, wie oft es unnötig dazwischengeht. PAUC-F versucht, beide Aspekte gemeinsam zu erfassen. Ob der Wert die Erwartungen von Nutzerinnen und Nutzern über andere Branchen, Videotypen und Systeme hinweg zuverlässig abbildet, muss jedoch gesondert untersucht werden. [3] [4]
Ein Harness und ein Trainingsschema setzen die Entscheidungen um
BLIP-Live untersucht sowohl angepasste Inferenz als auch zusätzlich trainierte Modelle. Ein Inferenz-Harness verändert die Gewichte eines bestehenden, für Offline-Videos entwickelten Modells nicht. Stattdessen organisiert es, welche Bildausschnitte und welcher Gesprächskontext dem Modell in jedem Schritt vorgelegt werden und wie dessen Antwort ausgewertet wird. Die Autoren berichten, dass eine Kombination aus gleitendem Bildfenster, Interaktionsgedächtnis und strukturierten Ausgaben in ihren Tests besonders gut abschnitt. [1] [3]
Im beschriebenen Harness erhält ein Modell unter anderem aktuelle Frames, die Frage und Informationen über die zuletzt akzeptierte Antwort. AlphaXiv gibt für diese Konfiguration drei aktuelle Bilder mit einer Entscheidung pro Sekunde an. In den trainierten Varianten kann das Modell laut derselben Paper-Zusammenfassung bis zu 32 Frames bei einer Bildrate von einem Frame pro Sekunde verarbeiten. Diese Werte beschreiben die untersuchten Einstellungen, nicht eine allgemein garantierte Reaktionsrate für den Produktivbetrieb. [4]
Beim Training unterscheidet BLIP-Live drei Zustände: „Response“ für eine neue, ausreichend belegte Antwort, „Hold“ für ein bereits gemeldetes und weiterhin sichtbares Ereignis sowie „Silence“ für eine zum aktuellen Zeitpunkt irrelevante Szene. Nur „Response“ gibt eine Antwort aus; „Hold“ soll Wiederholungen unterdrücken, ohne ein fortdauerndes Ereignis mit einer irrelevanten Szene gleichzusetzen. Das Training nutzt diese Zustände, um nicht nur den Text, sondern auch die Entscheidung zum Antworten oder Warten zu lernen. [4]
Das Team berichtet zwei trainierte Modelle, BLIP-Live-Gemma und BLIP-Live-Qwen. Der Anspruch der Autoren, den Inferenzansatz modellunabhängig einsetzen zu können, ist dabei von der Übertragbarkeit der trainierten Gewichte zu unterscheiden: Das Harness ist als Anpassung für vorhandene Modelle konzipiert, während die genannten Modellvarianten auf konkreten Modellfamilien beruhen. [1] [3]
Benchmarkwerte sind vielversprechend, aber nicht vollständig vergleichbar
Auf dem Benchmark ProactiveVideoQA erreicht BLIP-Live-Qwen laut einer im Paper ausgewiesenen Ergebnistabelle bei einem Gewichtungswert von 0,5 einen mittleren PAUC-F-Wert von 49,08. Für MMDuet2 nennt die Tabelle 34,01; der Mittelwert fasst die Teilbereiche WEB, EGO, TV und VAD zusammen. Die Auswertung verwendet GPT-4.1 als Bewertungsmodell. Die Autoren beziffern den Abstand als relativen Zugewinn von 44 Prozent gegenüber der Vergleichsmethode. [4]
Das Abstract beansprucht außerdem führende Ergebnisse von BLIP-Live-Qwen auf vier proaktiven Streaming-Benchmarks und berichtet, dass das Modell mehrere geschlossene API-Modelle übertreffe. Diese Aussagen sind Ergebnisse der Autoren und keine unabhängige Bestätigung. Außerdem kommen in den verschiedenen Benchmarks unterschiedliche Kennzahlen zum Einsatz; auch die verglichenen Modelle nutzen nicht durchgängig ein identisches Harness. Ein einzelner, über alle Aufgaben hinweg direkt vergleichbarer Messwert lässt sich daraus daher nicht ableiten. [1] [3] [4]
Das ist für die Einordnung von „State of the Art“ entscheidend: Der Befund gilt im Rahmen der berichteten Datensätze, Metriken und Testkonfigurationen. Er belegt weder eine generelle Überlegenheit gegenüber allen verfügbaren Videoagenten noch eine bessere Leistung in ungetesteten betrieblichen Umgebungen. Die Studie liefert vielmehr einen Vorschlag, wie Antworttiming und Selektivität in bestimmten Streaming-Aufgaben gemeinsam gemessen werden können. [3] [4]
Ablationen testen Wiederholungen und Nutzerpräferenzen
Eine Ablation des Zustands „Hold“ prüft, ob die Unterscheidung zwischen einem fortlaufenden und einem neuen Ereignis tatsächlich etwas ändert. Für BLIP-Live-Gemma auf dem WEB-Teilbereich steigt die Zahl der ausgegebenen Antworten ohne „Hold“ von 978 auf 2.840. Die Präzision sinkt in diesem Vergleich von 75,1 auf 25,8 Prozent; der Anteil wiederholter Antworten steigt von 15 auf 65 Prozent. Der PAUC-Wert bleibt dagegen nahezu unverändert. [4]
Der Versuch illustriert, warum eine reine Timing- oder Recall-Kennzahl die Systematik übermäßiger Antworten übersehen kann: In dieser Ablation verändert sich das Antwortverhalten stark, während PAUC kaum reagiert. Die Werte belegen den Effekt für das untersuchte Modell und den genannten Benchmark-Teilbereich; sie sind kein allgemeiner Nachweis, dass ein zusätzlicher Zustand in jeder Streaming-Anwendung dieselbe Wirkung hat. [4]
Die Autoren verglichen außerdem zwei Harness-Varianten, von denen eine auf PAUC und die andere auf PAUC-F optimiert war. In einer Nutzerstudie mit zehn Teilnehmenden wurde die PAUC-F-Variante für WEB in 94 Prozent und für EGO in 97 Prozent der Vergleiche bevorzugt. Der Umfang war begrenzt: Verglichen wurden zwei Systeme anhand von 20 Videos je Teilbereich. Das Ergebnis stützt den Nutzen von Zurückhaltung in diesem Versuchsaufbau, zeigt aber nicht, dass PAUC-F-Ranglisten die menschlichen Präferenzen über eine große Zahl unterschiedlicher Modelle hinweg zuverlässig vorhersagen. [3] [4]
Für den Praxiseinsatz fehlen noch Latenz- und Betriebsdaten
Für Anbieter und Anwender, die Videoassistenten bewerten, liegt der naheliegende Beitrag der Arbeit zunächst in der Messlogik: Neben der Qualität einer Antwort lassen sich auch ihr Zeitpunkt und unnötige weitere Ausgaben berücksichtigen. Das kann bei der Prüfung von Systemen für laufende Videoüberwachung, Assistenz oder Live-Auswertung helfen. Diese möglichen Einsatzfelder sind eine Analyse der untersuchten Aufgaben, keine von BLIP-Live ausgewiesenen Unternehmenseinsätze. [3] [4]
Die Ergebnisse dürfen nicht mit einem Nachweis geringerer Latenz, niedrigerer Kosten oder weniger Modellaufrufe verwechselt werden. Die Tests bewerten Antwortverhalten anhand von Benchmarks; die verfügbare Zusammenfassung hält ausdrücklich fest, dass daraus keine gemessenen Einsparungen bei Token, Aufrufen oder Verzögerung folgen. Zudem wird nur in Sekundenschritten entschieden. Ob eine dichtere Taktung hilfreicher wäre oder welchen Ressourcenaufwand sie verursachen würde, bleibt damit offen. [4]
Auch der geplante Zugang zu Trainingsmaterial und Code ist ein offener Punkt für eine mögliche technische Nachprüfung. Die Autoren kündigen eine öffentliche Freigabe an, doch die bereitgestellten Quellen bestätigen keine bereits erfolgte Veröffentlichung. Unternehmen sollten deshalb die berichteten Leistungswerte als Forschungsresultate betrachten und vor einer Beschaffungs- oder Integrationsentscheidung eigene Tests mit den vorgesehenen Daten, Sicherheitsanforderungen und Betriebsbedingungen durchführen. [1] [3]
Streaming-Forschung bearbeitet weitere technische Engpässe
BLIP-Live konzentriert sich auf die Frage, wann ein System antworten oder schweigen sollte. Eine weitere Forschungsarbeit zu Streaming-Video, StreamAgent, setzt an einem anderen Engpass an: Sie beschreibt vorausschauende Planung relevanter Zeitabschnitte und Bildbereiche sowie eine Speicherarchitektur, die frühere Videoinformationen gezielt abrufen soll. Die Arbeit behandelt damit aktive Wahrnehmung und Kontextverwaltung als zusätzliche Bausteine für Streaming-Systeme. [7]
Die beiden Ansätze sind in den vorliegenden Quellen nicht direkt gegeneinander getestet. Für die technische Bewertung ergibt sich dennoch ein nützlicher Rahmen: Ein Echtzeitagent muss nicht nur die Schwelle zum Antworten passend setzen, sondern auch relevante Hinweise über die Zeit verfügbar halten. BLIP-Live liefert Mess- und Trainingsbausteine für die erste Frage; die StreamAgent-Arbeit untersucht Planungs- und Speichermechanismen für die zweite. Ein integriertes System oder ein belastbarer Vergleich ihrer Leistungsfähigkeit ist damit noch nicht belegt. [3] [7]
Quellen
- [1] Paper page - BLIP-Live: Balancing Timeliness & Firing Precision in Proactive Streaming Video Agents — https://huggingface.co/papers/2611.21553 (abgerufen am 2026-11-19)
- [3] BLIP-Live: Balancing Timeliness & Firing Precision in Proactive Streaming Video Agents | alphaXiv — https://www.alphaxiv.org/abs/2611.21553 (abgerufen am 2026-11-19)
- [4] BLIP-Live: Balancing Timeliness & Firing Precision in Proactive Streaming Video Agents — https://arxiv.org/html/2611.21553v1 (abgerufen am 2026-11-19)
- [7] Towards Anticipatory Agents for Streaming Video Understanding — https://aclanthology.org/2026.findings-emnlp.65.pdf (abgerufen am 2026-11-19)
Nächster Artikel
Bild & Video
FastFrames zielt auf interaktive Videogenerierung mit 36 Millisekunden LatenzFastFrames soll autoregressive Videogenerierung auf 36 Millisekunden pro Frame senken. Was die Technik leistet, welche Hardware nötig ist und wo Grenzen bleiben.
Artikel teilen
Mehr zu Bild- & Video-KI
Alle Bild & Video-News- SALA nutzt Sprachsignale, um Humanvideos für Robotertraining zu erschließen
SALA verbindet unpaarige Human- und Robotervideos über Sprachähnlichkeit. Ein Preprint meldet Fortschritte, doch die Skalierung bleibt begrenzt belegt.
- G-STAR verkürzt Bildgenerierung durch stärker gruppierte visuelle Tokens
G-STAR kombiniert stark komprimierte Bildtokens mit autoregressiver Erzeugung; die Autoren berichten 2,5 Sekunden je 1024er Bild auf einer H200. [S1][S3]
- APEX teilt bei Streaming-Videos Generator und Verteilungsschätzer
Ein Paper zu APEX beschreibt Condition Shifting für Streaming-Videos: weniger Trainingsspeicher und kürzere Iterationen, aber offene Fragen zur Vergleichbarkeit.
- BYOD macht aus vier Sprachmodellen Diffusionsmodelle – mit klarer Qualitätslücke
BYOD wandelt vier vortrainierte Sprachmodelle per LoRA in Diffusionsmodelle um. Die Studie berichtet kurze Trainingszeiten, aber Schwächen bei freier Textgenerierung.
Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
- Dokumente und Daten analysierenAuswerten, vergleichen und Abweichungen automatisch erkennen.
- Die KI-Plattform für UnternehmenRollen, Freigaben und Abrechnung für den KI-Einsatz im ganzen Unternehmen.
- KI-Chat mit allen führenden ModellenGPT, Claude und Gemini in einer Oberfläche – mit Websuche und Quellenangaben.
Recherchieren Sie KI-News wie diese selbst – mit Mindverse Studio.
7 Tage kostenlos testen – ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.