
APEX teilt bei Streaming-Videos Generator und Verteilungsschätzer
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 5 Quellen
Das Wichtigste in Kürze
- APEX nutzt Condition Shifting, damit ein Videogenerator zugleich die erzeugte Verteilung schätzt und kein separates Fake-Score-Netz benötigt. [1]
- Für 180-Sekunden-Videos berichten die Autoren bessere Werte bei der Instruktionsbefolgung und visuellen Ästhetik als S2-Avatar. [1]
- Eine menschliche Bewertung bevorzugte APEX besonders beim Befolgen von Anweisungen; bei Bewegungsqualität schnitt S2-Avatar besser ab. [1]
- Unter abgeglichenen Trainingsbedingungen meldet die Arbeit 4,4 Prozent weniger maximalen GPU-Speicher und 9,2 Prozent kürzere mittlere Iterationen gegenüber DMD. [1]
- Die Angaben belegen weder eine schnellere Videogenerierung zur Laufzeit noch eine unabhängige Replikation; die bereitgestellte Zusammenfassung enthält keine vollständigen Methodenangaben. [1]
Inhalt · 8 Abschnitte
- Ein gemeinsames Netz statt eines separaten Schätzers
- Warum die Schätzung der Ausgabeverteilung zählt
- Streaming stellt andere Anforderungen als kurze Clips
- Berichtete Ergebnisse: Vorteile mit klarer Begrenzung
- Menschliche Bewertung zeigt ein gemischtes Profil
- Trainingsressourcen sind nicht gleich Laufzeitgewinn
- Was die Arbeit für einen Praxistest offenlässt
- Ein Ansatz für effizienteres Training, kein fertiger Leistungsnachweis
- Quellen
Ein gemeinsames Netz statt eines separaten Schätzers
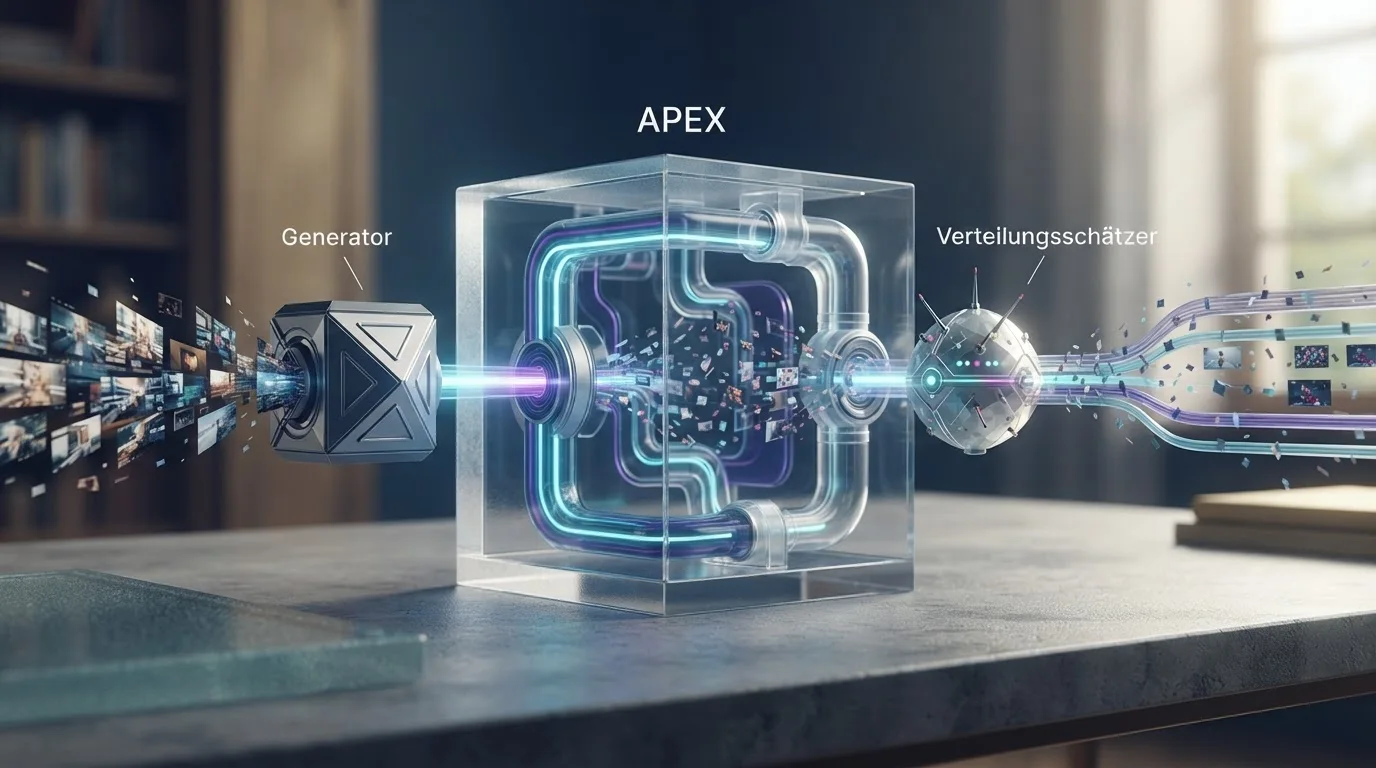
Eine neue Arbeit zu Streaming-Videogenerierung schlägt vor, den Trainingsaufwand für Modelle mit wenigen Generierungsschritten durch eine Änderung am Schätzverfahren zu senken. Das Verfahren APEX verwendet Condition Shifting: Das Generatornetz nutzt eine ursprüngliche Textbedingung, um Videos zu erzeugen, und eine verschobene Bedingung, um die Verteilung seiner eigenen Ausgaben einzuschätzen. Beide Aufgaben laufen laut Zusammenfassung mit denselben Modellparametern. Damit soll ein separates Fake-Score-Netz entfallen, das bei Distribution Matching Distillation (DMD) zusätzlich trainiert wird. [1]
Die Arbeit baut dabei auf einem zuvor für Bildsynthese beschriebenen APEX-Ansatz auf. Dessen Autoren erläutern Condition Shifting als Möglichkeit, ein internes Signal zur Korrektur der Generatorausgaben aus einem Flow-Modell abzuleiten, statt dafür einen zusätzlichen Diskriminator einzusetzen. Die Videostudie überträgt dieses Prinzip auf einen anderen Anwendungsfall: fortlaufend erzeugte Videosequenzen. Das ist eine methodische Weiterentwicklung, aber noch kein Nachweis, dass die Ergebnisse auf andere Generatoren oder Produktumgebungen übertragbar sind. [1][3]
Warum die Schätzung der Ausgabeverteilung zählt
DMD soll einen kompakten Generator dazu bringen, Ausgaben ähnlich der Verteilung eines leistungsfähigeren Referenzmodells zu erzeugen. Dafür wird neben dem Generator ein Modell zur Schätzung der vom Generator produzierten Verteilung verwendet. Die Zielarbeit beschreibt dieses zusätzliche Netz als Speicher- und Rechenaufwand, das zudem mit dem sich verändernden Generator Schritt halten müsse. [1]
Die technische Motivation lässt sich über das sogenannte Geschwindigkeitsfeld einordnen. Flow-Modelle beschreiben, wie sich ein verrauschtes Signal während der Generierung in Richtung eines Ergebnisses bewegt; das Geschwindigkeitsfeld gibt dabei eine lokale Bewegungsrichtung des Signals an. Die frühere APEX-Arbeit nutzt laut Abstract eine verschobene Bedingung, um ein solches Feld als Schätzer der aktuellen Generatorverteilung zu verwenden. Für die Videoversion soll das Netz diesen Schätzer intern bereitstellen. [1][3][8]
Das ersetzt jedoch nicht das gesamte Training durch einen einzelnen simplen Schritt. Die Videoarbeit behält nach ihrer Zusammenfassung einen eingefrorenen Referenzlehrer, Self-Replay Forcing und eine wahrnehmungsbezogene Regularisierung bei. APEX verändert demnach einen Bestandteil des Trainingsaufbaus, nicht die gesamte Pipeline. [1]
Streaming stellt andere Anforderungen als kurze Clips
Bei Streaming-Videogenerierung muss ein Modell fortlaufend neue Bildabschnitte bereitstellen, statt eine komplette Sequenz ausschließlich als zusammenhängenden Offline-Auftrag zu verarbeiten. Andere Arbeiten zu autoregressiven Videomodellen beschreiben den Übergang von bidirektionaler Verarbeitung zu schrittweiser Erzeugung als Voraussetzung für solche Abläufe. Sie verweisen zugleich auf Herausforderungen wie Fehlerfortpflanzung und Qualitätsverlust bei langen Sequenzen. [6][7]
Diese Probleme sind für die Einordnung von APEX relevant, weil ein Effizienzgewinn bei der Berechnung nicht automatisch gleichbleibende Qualität über längere Laufzeiten bedeutet. In einer weiteren Arbeit zur Videodestillation werden etwa Übersättigung, zeitliche Inkonsistenz und nachlassende Bewegung als mögliche Folgen stark reduzierter Generierungsschritte diskutiert. Das ist kein direkter Befund zu APEX, zeigt aber, weshalb neben dem Speicherbedarf auch zeitliche Stabilität und Bewegungsqualität geprüft werden müssen. [8]
Die Autoren von APEX berichten eine Evaluation mit 180 Sekunden langen Videos. Diese Dauer macht die Arbeit für Anwendungsfälle interessant, in denen Inhalte fortlaufend entstehen sollen; sie sagt für sich genommen jedoch nichts über Bildrate, Auflösung oder die Latenz bis zum ersten nutzbaren Bild aus. Solche Betriebskennzahlen nennt die bereitgestellte Zusammenfassung nicht. [1]
Berichtete Ergebnisse: Vorteile mit klarer Begrenzung
Im Vergleich mit S2-Avatar erreicht APEX laut Arbeit auf dem Progressive-Track einen höheren Wert für die Erfüllung von Videoanweisungen: 3,856 gegenüber 3,831. Bei der visuellen Ästhetik berichtet die Zusammenfassung höhere Werte für APEX in beiden untersuchten Tracks; genannt werden 0,641898 gegenüber 0,632606. Die Differenzen betragen damit 0,025 beziehungsweise 0,009292 Punkte. Ohne Angaben zur Skala, Streuung oder statistischen Unsicherheit lässt sich aus diesen Zahlen allein nicht ableiten, wie deutlich oder verlässlich der praktische Qualitätsunterschied ist. [1]
Die Evaluation wurde nach Angaben der Autoren mit drei Backbone-Auswertungen pro Block und einem räumlichen Refiner mit einem Generierungsschritt durchgeführt. Das ist für die Interpretation wichtig: „Few-Step“ beschreibt hier nicht ohne Weiteres eine einzelne Netzauswertung für das gesamte Video. Der angegebene Aufbau umfasst mehrere Komponenten und Auswertungen, sodass eine pauschale Aussage wie „ein Schritt pro Video“ von der Zusammenfassung nicht gedeckt wäre. [1]
Zusätzlich berichten die Autoren einen Vergleich mit 320 Fällen aus StreamAV-Bench. Die bereitgestellte Beschreibung nennt jedoch keine detaillierten Resultattabellen für diese Fälle. Deshalb lässt sich daraus hier weder ein weiterer konkreter Leistungsabstand noch eine Rangfolge für einzelne Teilaufgaben ableiten. [1]
Menschliche Bewertung zeigt ein gemischtes Profil
In einer als 70 Fälle beschriebenen menschlichen Bewertung lag der stärkste berichtete Vorteil von APEX bei der Befolgung der Anweisungen: Die Autoren geben eine Netto-Präferenz von plus 30,0 Prozent an. Für Konsistenz und Videoqualität nennen sie jeweils plus 4,3 Prozent. Bei der Bewegungsqualität bevorzugten die Bewertenden dagegen überwiegend S2-Avatar. Die audiovisuelle Synchronisierung endete meist unentschieden, und bei der Benutzerfreundlichkeit meldet die Arbeit keinen Unterschied. [1]
Diese Ergebnisse sprechen nicht für einen uneingeschränkten Qualitätsvorsprung in jeder Dimension. Vielmehr hängt die Bewertung davon ab, welches Kriterium im Vordergrund steht: APEX wird vor allem bei der Übereinstimmung mit dem Textprompt besser eingeschätzt, während die Bewegungsqualität eine Schwäche im Vergleich darstellen kann. Die Zusammenfassung nennt keine Angaben zur Zahl der Teilnehmenden, zur Auswertungsmethode oder zu Unsicherheitsintervallen. Die 70 Fälle sollten daher nicht mit 70 unabhängigen Personen gleichgesetzt werden. [1]
Trainingsressourcen sind nicht gleich Laufzeitgewinn
Unter abgeglichenen Trainingsbedingungen messen die Autoren gegenüber DMD 4,4 Prozent weniger maximal zugewiesenen GPU-Speicher pro GPU und eine um 9,2 Prozent kürzere mittlere Iterationszeit. Diese Werte beziehen sich auf Trainingsmessungen. Sie belegen weder eine entsprechend schnellere Generierung im Einsatz noch geringere Gesamtkosten für das Training. Dafür wären unter anderem Angaben zur Zahl der nötigen Iterationen, zur Konvergenz und zum vollständigen Rechenaufwand nötig; diese Details enthält die bereitgestellte Zusammenfassung nicht. [1]
Für Unternehmen ist die Reduktion des zusätzlichen Netzes dennoch ein plausibler Ansatzpunkt: Wenn sich die berichteten Einsparungen unter den eigenen Trainingsbedingungen reproduzieren lassen, könnte das den Ressourcenbedarf einzelner Trainingsläufe verringern. Das ist eine praktische Folgerung aus den gemeldeten Messwerten, keine bereits nachgewiesene Wirkung auf Produktionskosten oder Durchsatz. Auch die Leistungsfähigkeit einer Bereitstellung müsste separat geprüft werden. [1]
Was die Arbeit für einen Praxistest offenlässt
Die verfügbare Darstellung der Zielarbeit besteht aus einer Paper-Seite mit Abstract und zusammengefassten Ergebnissen, nicht aus vollständigen Angaben zu Versuchsaufbau und Auswertung. Sie enthält unter anderem keine Konfidenzintervalle zu den Qualitätswerten, keine ausführliche Beschreibung der menschlichen Bewertung und keine detaillierten Laufzeitmessungen für die Videogenerierung. Die gemeldeten Vorteile sind deshalb als Ergebnisse der Autoren zu behandeln, nicht als unabhängig bestätigte Leistungsdaten. [1]
Auch eine Code- oder Modellfreigabe nennt die bereitgestellte Zusammenfassung nicht. Die frühere APEX-Arbeit zur Bildgenerierung wird auf arXiv mit einem Verweis auf verfügbaren Code beschrieben; daraus folgt aber nicht, dass der Videocode oder ein nutzbares Videomodell veröffentlicht wurde. Für eine technische Prüfung sollten Sie daher auf eine bestätigte Implementierung und reproduzierbare Vergleichsbedingungen warten, bevor Sie aus den Trainingswerten Rückschlüsse auf den Einsatz in Ihrer Infrastruktur ziehen. [1][3]
Ein Ansatz für effizienteres Training, kein fertiger Leistungsnachweis
APEX adressiert einen konkreten Engpass: den zusätzlichen Aufwand eines separaten Netzes zur Schätzung der generierten Verteilung bei der Destillation. Die gemeldeten Speicher- und Iterationsvorteile sind messbar, fallen in den berichteten Versuchen aber moderat aus. Die Qualitätsdaten wiederum zeigen ein uneinheitliches Bild mit Vorteilen bei Instruktionsbefolgung und Ästhetik, aber einem Nachteil bei der Bewegungsqualität. [1]
Für eine geschäftliche Bewertung kommt es daher auf den eigenen Anwendungsfall an. Wenn präzise Prompt-Umsetzung und lange Streaming-Ausgaben entscheidend sind, sind die berichteten Resultate relevant; wenn natürliche Bewegung, geringe Latenz oder zuverlässige audiovisuelle Synchronisierung wichtiger sind, reichen die vorliegenden Angaben für eine Entscheidung nicht aus. Diese Abwägung ist eine Analyse der genannten Metriken, keine Empfehlung für oder gegen den Einsatz. [1][6][7]
Quellen
- [1] Paper page - Few-Step Streaming Video Generation via Condition Shifting — https://huggingface.co/papers/2611.14033 (abgerufen am 2026-11-11)
- [3] [2604.12322] Self-Adversarial One Step Generation via Condition Shifting — https://arxiv.org/abs/2604.12322 (abgerufen am 2026-11-11)
- [6] From Slow Bidirectional to Fast Autoregressive Video Diffusion Models — https://causvid.github.io/ (abgerufen am 2026-11-11)
- [7] MotionStream: Real-time Video Generation — https://joonghyuk.com/motionstream-web/paper.pdf (abgerufen am 2026-11-11)
- [8] Adaptive Video Distillation: Mitigating Oversaturation and Temporal Collapse in Few-Step Generation — https://openaccess.thecvf.com/content/CVPR2026/papers/You_Adaptive_Video_Distillation_Mitigating_Oversaturation_and_Temporal_Collapse_in_Few-Step_CVPR_2026_paper.pdf (abgerufen am 2026-11-11)
Nächster Artikel
Bild & Video
BYOD macht aus vier Sprachmodellen Diffusionsmodelle – mit klarer QualitätslückeBYOD wandelt vier vortrainierte Sprachmodelle per LoRA in Diffusionsmodelle um. Die Studie berichtet kurze Trainingszeiten, aber Schwächen bei freier Textgenerierung.
Artikel teilen
Mehr zu Bild- & Video-KI
Alle Bild & Video-News- GLOW-FM setzt bei Low-Light-Bildern auf eine einzige latente Modellberechnung
GLOW-FM soll Low-Light-Bilder mit einem einzigen Flow-Schritt verbessern. Was die Methode leistet – und was für den Praxiseinsatz noch offen ist.
- KI-Videos planbarer produzieren: Warum ein Bild als Startpunkt hilft
Warum Text-to-Video oft schwer steuerbar ist und wie ein Image-to-Video-Workflow mit Referenzbild, klarer Regie und Nachbearbeitung mehr Kontrolle schafft.
- Holo4D verbindet 4D-Szenenspuren mit Video-Diffusion für neue Kameraperspektiven
Holo4D verbindet 4D-Punkttrajektorien mit Video-Diffusion, um Kamerafahrten in Einzelkamera-Videos geometrisch zu steuern. Was Tests zeigen – und wo Grenzen liegen.
- AB-Attention zielt auf präzisere Beschleunigung von Video-Diffusion
AB-Attention soll den Rechenaufwand von Video-Diffusion-Transformern durch gewichtete Blockauswahl senken – bei hoher Sparsität und geringerem Qualitätsverlust.
Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
Recherchieren Sie KI-News wie diese selbst – mit Mindverse Studio.
7 Tage kostenlos testen – ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.