
Soft-MTP soll störende Gradienten beim Multi-Token-Training entfernen
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 3 Quellen
Das Wichtigste in Kürze
- Eine neue Arbeit schlägt Soft-MTP vor: Das Verfahren soll bei Multi-Token Prediction einen nach Darstellung der Autoren verrauschten Gradientenanteil entfernen. [1]
- Dazu kombiniert ein Straight-through-Verfahren Kreuzentropie-Gradienten, um den Gradienten einer KL-Selbst-Destillation zurückzugewinnen; zusätzliche Parameter oder messbarer Mehraufwand seien nicht nötig. [1]
- Die Autoren berichten Verbesserungen bei Next-Token-Perplexität, spekulativer Dekodierung und Zero-Shot-Genauigkeit für Modellgrößen von 167 Millionen bis 1,2 Milliarden Parametern. [1]
- Die bereitgestellte Zusammenfassung nennt jedoch weder konkrete Messwerte noch ausführliche Versuchsdetails; die Resultate sind daher als Angaben der Autoren und nicht als unabhängige Bestätigung einzuordnen. [1]
- Frühere MTP-Experimente zeigen, dass Ergebnisse mit Modellgröße, Aufgabe und Zahl der vorherzusagenden Tokens variieren können. [3]
// Inhalt · 8 Abschnitte
- Ein Eingriff in das Trainingssignal
- Was Multi-Token Prediction verändert
- Die Diagnose: ein nützliches Signal mit störendem Rest
- Soft-MTP gewinnt den KL-Gradienten zurück
- Berichtete Verbesserungen bis 1,2 Milliarden Parameter
- Warum frühere MTP-Ergebnisse zur Einordnung wichtig sind
- Schnellere Dekodierung ist kein automatischer Laufzeitgewinn
- Bedeutung für Modelltraining und offene Evidenzfragen
- Quellen
Ein Eingriff in das Trainingssignal
Eine am 27. Oktober 2026 veröffentlichte Arbeit stellt Soft-MTP als Änderung am Training großer Sprachmodelle vor. Der Ansatz setzt bei Multi-Token Prediction (MTP) an: Statt an jeder Textposition nur das nächste Token vorherzusagen, trainiert ein Modell zusätzlich Vorhersagen für mehrere künftige Tokens. Die Hugging-Face-Seite führt Jayden Teoh als Autor und beschreibt Soft-MTP als Änderung, die einen störenden Anteil des MTP-Gradienten entfernen soll. [1]
Das ist zunächst ein Forschungsergebnis, keine dokumentierte Produkteinführung. Die Seite beschreibt den Ansatz und berichtet über Experimente, nennt aber in dem bereitgestellten Text keine vollständigen Tabellen, Trainingskonfigurationen oder konkreten Einzelwerte. Entsprechend sind die Leistungsangaben im Folgenden den Autoren zuzuschreiben. [1]
- Fragestellung: Lässt sich das zusätzliche Lernsignal von MTP nutzen, ohne dessen nach Darstellung der Autoren störenden Gradientenanteil mitzutraining? [1]
- Vorgeschlagene Antwort: Soft-MTP soll den Gradienten einer KL-Selbst-Destillation isolieren und dafür bestehende Kreuzentropie-Berechnungen wiederverwenden. [1]
Was Multi-Token Prediction verändert
Beim üblichen Next-Token-Training lernt ein Sprachmodell, aus dem bisherigen Kontext das unmittelbar folgende Token vorherzusagen. MTP erweitert dieses Ziel: Mehrere Vorhersageköpfe können von einer gemeinsamen Repräsentation ausgehen und unterschiedliche zukünftige Tokens prognostizieren. Die zugrunde liegende Idee ist, dem Modell während des Trainings zusätzliche Lernsignale für spätere Stellen der Sequenz zu geben. [3]
Die zusätzlichen Vorhersageköpfe müssen nicht zwingend Teil der späteren Textgenerierung sein. In einem früheren MTP-Verfahren konnten sie bei der Inferenz ungenutzt bleiben oder für spekulative Dekodierung eingesetzt werden, bei der ein Modell Kandidaten für folgende Tokens vorschlägt und ein Hauptmodell diese überprüft. [3] Ob die Zusatzköpfe tatsächlich Geschwindigkeit bringen, hängt allerdings auch von der Dekodierungsumgebung und davon ab, wie viele Vorschläge akzeptiert werden. [4]
Die Diagnose: ein nützliches Signal mit störendem Rest
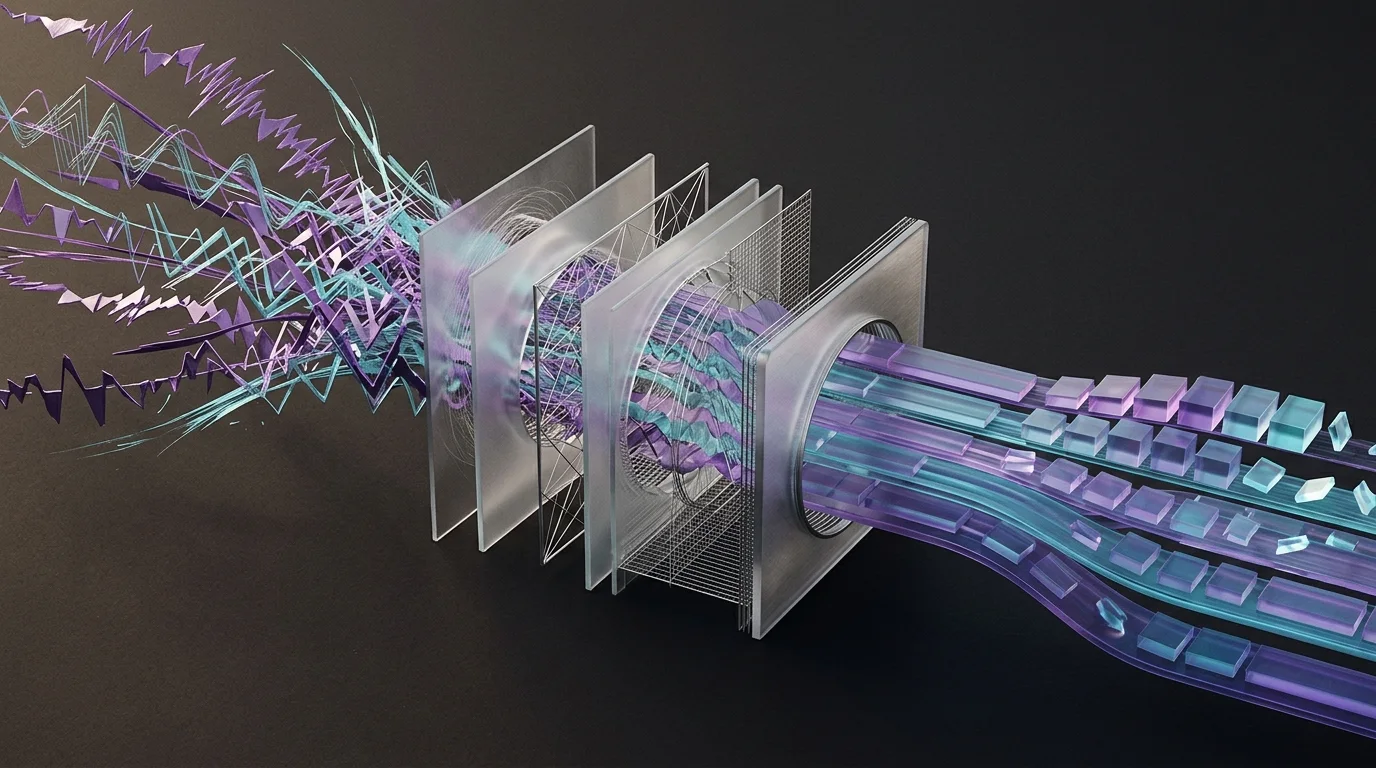
Die Autoren von Soft-MTP zerlegen den Gradienten der MTP-Kreuzentropie nach eigener Darstellung exakt in zwei Bestandteile. Der erste entspricht dem Gradienten einer KL-Selbst-Destillation: Er soll die Verteilung eines MTP-Kopfs an die Next-Token-Verteilung desselben Modells heranführen und damit auch die Eignung für spekulative Dekodierung unterstützen. Der zweite Bestandteil ist laut Arbeit ein verrauschter Rest mit niedrigem Signal-Rausch-Verhältnis, der das nützliche Signal überlagere. [1]
Die Arbeit behauptet zudem, dass diese Beeinträchtigung mit wachsender Modellgröße stärker werde und sowohl das Lernen des nächsten Tokens als auch das Lernen mehrerer Tokens treffen könne. Das ist die zentrale Diagnose der Autoren, nicht ein unabhängig bestätigter allgemeiner Befund: Die zur Verfügung gestellte Papierseite fasst die Argumentation zusammen, enthält aber keine vollständigen Belege oder Detailauswertungen, anhand derer sich ihre Reichweite hier selbst prüfen ließe. [1]
Soft-MTP gewinnt den KL-Gradienten zurück
Soft-MTP soll den störenden Rest umgehen, indem es gezielt den Gradienten der KL-Selbst-Destillation zurückgewinnt. Dafür nutzen die Autoren einen Straight-through-Gradientenpfad: Wenn zwei Verteilungen denselben linearen Ausgabekopf verwenden, lasse sich der KL-Gradient nach ihrer Darstellung exakt durch eine Kombination der zugehörigen Kreuzentropie-Gradienten rekonstruieren. [1]
Der praktische Punkt ist die Berechnung. Eine direkte KL-Optimierung würde nach Darstellung der Arbeit Logit-Matrizen in der Größe des gesamten Wortschatzes erfordern. Die vorgeschlagene Rückgewinnung soll solche Matrizen vermeiden und mit üblichen, fusionierten Kreuzentropie-Kernels kompatibel sein. Soft-MTP verwende dafür die ohnehin vorhandenen Next-Token- und MTP-Kreuzentropie-Berechnungen. [1]
Die Arbeit bezeichnet die Änderung als klein und berichtet, sie lasse sich als Ein-Zeilen-Anpassung integrieren. Sie unterstütze sowohl MTP-Varianten im DeepSeek- als auch im Meta-Stil, füge keine Parameter hinzu und verursache keinen messbaren Mehraufwand. Das sind Angaben der Autoren; der bereitgestellte Text spezifiziert weder die verwendeten Hardwarekonfigurationen noch, wie „messbar“ im jeweiligen Versuch abgegrenzt wurde. [1]
Berichtete Verbesserungen bis 1,2 Milliarden Parameter
Die Zusammenfassung der Arbeit berichtet Ergebnisse für Modelle zwischen 167 Millionen und 1,2 Milliarden Parametern. In diesem Bereich habe Soft-MTP gegenüber herkömmlichem MTP eine niedrigere Next-Token-Perplexität, schnellere spekulative Dekodierung und eine höhere Zero-Shot-Genauigkeit bei jeder getesteten Modellgröße erzielt. Eine niedrigere MTP-Perplexität wird ab 689 Millionen Parametern angegeben. [1]
Nach Fine-Tuning eines 1,2-Milliarden-Parameter-Modells berichten die Autoren außerdem bessere Ergebnisse bei mathematischem und programmierbezogenem Schlussfolgern. Auf den meisten Metriken habe Soft-MTP eine direkte Minimierung der KL-Divergenz erreicht oder übertroffen. Die bereitgestellte Darstellung nennt dafür jedoch weder konkrete Scores noch Benchmarknamen, Konfidenzintervalle oder die genaue Versuchsanordnung. [1]
Diese Lücke begrenzt, was sich aus den Angaben ableiten lässt. Die Ergebnisse sprechen in der Darstellung der Autoren für einen Effekt über mehrere Größenstufen und Aufgabenarten hinweg. Sie belegen anhand des bereitgestellten Materials aber weder die Höhe des Vorteils noch, ob dieser unter anderen Trainingsbudgets, Datenmischungen oder Inferenz-Setups bestehen bleibt. [1]
Warum frühere MTP-Ergebnisse zur Einordnung wichtig sind
MTP ist nicht neu; Soft-MTP setzt auf einer bereits untersuchten Trainingsidee auf. Eine 2024 veröffentlichte Arbeit testete Multi-Token Prediction mit Modellen von 300 Millionen bis 13 Milliarden Parametern. Ihre Ergebnisse fielen nicht bei allen Größen gleich aus: Bei kleineren Modellen lagen die MTP-Varianten in den ausgewerteten Code-Aufgaben teils hinter Next-Token-Modellen, während sie bei größeren Modellen Vorteile zeigten. [3]
Auch die Zahl der vorhergesagten Tokens war nicht für jede Aufgabe gleich günstig. In einem Vergleich von 7-Milliarden-Parameter-Modellen mit 200 Milliarden Trainingstokens erzielte die Vier-Token-Variante auf MBPP bei Pass@1 einen Wert von 33,8 Prozent gegenüber 30,0 Prozent für Next-Token-Training. Auf APPS/Intro lag dagegen die Sechs-Token-Variante vorn. [3]
Das ist für die Einordnung von Soft-MTP relevant: Ein verbessertes Trainingssignal kann eine Schwäche einer MTP-Implementierung adressieren, macht aber nicht automatisch jede MTP-Konfiguration für alle Aufgaben überlegen. Die älteren Resultate zeigen, dass Modellgröße und Aufgabentyp die Bewertung beeinflussen können. Für Soft-MTP wären deshalb detaillierte, aufgeschlüsselte Vergleichswerte entscheidend; sie sind in der vorliegenden Zusammenfassung nicht enthalten. [1][3]
Schnellere Dekodierung ist kein automatischer Laufzeitgewinn
Bei spekulativer Dekodierung erzeugt ein zusätzlicher Pfad mehrere Kandidaten, die das Hauptmodell anschließend prüft. Werden genügend Kandidaten akzeptiert, können mehrere Tokens in einem Verarbeitungsschritt übernommen werden; verworfene Vorschläge müssen dagegen neu berechnet werden. MTP kann so neben einem Trainingsziel auch eine Rolle in der Inferenz spielen. [3][4]
Die Soft-MTP-Seite meldet schnellere spekulative Dekodierung, veröffentlicht in der bereitgestellten Zusammenfassung aber weder einen konkreten Beschleunigungsfaktor noch Angaben zu Hardware, Batchgröße, Dekodierungslänge oder Annahmerate. [1] Ein Überblick zu MTP-Implementierungen betont, dass gemeldete Durchsatzgewinne unter anderem vom Serving-System und vom Verhalten der Vorschläge abhängen; das Laden eines Modells mit MTP aktiviert den schnellen Pfad nicht notwendigerweise von selbst. [4]
Für Unternehmen ist daher zwischen Trainingsnutzen und Laufzeitnutzen zu unterscheiden. Selbst wenn Soft-MTP das Training ohne messbaren Zusatzaufwand verbessert, folgt daraus nicht allein, dass eine bestehende Inferenzplattform dieselbe Beschleunigung erreicht. Das ist eine technische Einordnung der beschriebenen Abhängigkeiten, kein von der Arbeit bezifferter Geschäftseffekt. [1][4]
Bedeutung für Modelltraining und offene Evidenzfragen
Für Teams, die eigene Modelle trainieren oder MTP-Ansätze evaluieren, liegt die mögliche Relevanz von Soft-MTP zunächst in der Effizienz des Lernsignals: Sollte sich die behauptete Gradientenrückgewinnung reproduzieren lassen, könnte sie eine MTP-Variante attraktiver machen, ohne zusätzliche Modellparameter einzuführen. Ob sich daraus ein belastbarer Vorteil für ein konkretes Unternehmensmodell ergibt, hängt jedoch von dessen Architektur, Daten und Zielaufgaben ab. Diese Übertragung ist eine Analyse der beschriebenen Methode, kein nachgewiesenes Produktionsergebnis. [1][3]
Die Quellenlage mahnt zu einer vorsichtigen Bewertung. Die Hugging-Face-Seite kennzeichnet ihre ausführliche Zusammenfassung als von Inkling-Small generiert. Sie nennt einen Link zu einem Code-Repository, liefert im bereitgestellten Text aber keine vollständigen Experimente oder nachvollziehbaren Zahlenreihen. [1] Eine unabhängige Replikation oder ein dokumentierter Einsatz in produktiven Systemen ist in den vorliegenden Quellen nicht belegt. [1]
Die angemessene Schlussfolgerung lautet deshalb nicht, Soft-MTP sei bereits ein universell kostenfreier Gewinn. Die Arbeit formuliert eine konkrete technische Hypothese und berichtet positive Resultate in einem begrenzten Modellgrößenbereich. Für eine belastbare Entscheidung wären die vollständigen Versuchsdetails, Vergleiche unter gleichen Rechenbudgets und Tests mit der vorgesehenen Inferenzumgebung nötig. Die Bezeichnung als „free lunch“ stammt aus der Darstellung der Autoren und sollte nicht mit unabhängig bestätigter Kostenfreiheit verwechselt werden. [1]
Quellen
- [1] Paper page - Multi-Token Prediction Done Right — https://huggingface.co/papers/2610.38331 (abgerufen am 2026-10-30)
- [3] Better & Faster Large Language Models via Multi-token Prediction — https://arxiv.org/pdf/2404.19737 (abgerufen am 2026-10-30)
- [4] Multi-Token Prediction (MTP) | Sebastian Raschka, PhD — https://sebastianraschka.com/llm-architecture-gallery/mtp (abgerufen am 2026-10-30)
//Nächster Artikel
Bild & Video
OpenFlyV2 bündelt Bildverstehen und Flugplanung auf der DrohneOpenFlyV2 bündelt Bild, Sprache und Flugplanung an Bord; die Paper-Seite nennt 10 Hz und 48 Prozent Erfolg in vier realen Umgebungen. [S1]
// Artikel teilen
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
- Eigene Modelle und Assistenten trainierenBilden Sie einen digitalen Marken-Experten auf Ihrem Wissen aus.
- KI-Chat mit allen führenden ModellenGPT, Claude und Gemini in einer Oberfläche — mit Websuche und Quellenangaben.
- Schreiben mit KI-AssistenzTexte entwerfen, umschreiben und verbessern — im Editor statt im Chat.
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
//Chronik