
SO-101-Benchmark: Simulation erhält Rangfolge, überschätzt aber die Erfolgsraten
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 4 Quellen
Das Wichtigste in Kürze
- SO-101 Bench prüft sprachgesteuerte räumliche Manipulation in einer Isaac-Lab-Simulation mit 138 Objekten und 916 Testepisoden.
- In einem Hardwarevergleich mit fünf Systemen blieb die Rangfolge auf dem realen Roboter exakt erhalten; die Simulation überschätzte jedoch die Erfolgsraten.
- Die besten trainierten Vision-Language-Action-Modelle erreichten im Haupttest rund 61 Prozent, ein LLM-Agent mit gelerntem Greifmodul 83,2 Prozent.
- Eine separate Ablation deutet darauf hin, dass sowohl die Agenten-Umgebung als auch das Sprachmodell zum Ergebnis beitragen.
- Der öffentliche Code enthält einen kleinen Validierungssatz; die vollständige zurückgehaltene Auswertung ist nicht enthalten.
// Inhalt · 9 Abschnitte
- Ein Benchmark für räumliche Anweisungen
- Was die Systeme bewältigen müssen
- Gleiche Trainingsbasis, aber unterschiedliche Systemtypen
- Der Abgleich mit realer Hardware
- Ein gutes Ranking ist noch keine breite Transfergarantie
- VLA-Policies bleiben bei räumlicher Präzision zurück
- Der Agenten-Vorsprung hängt auch vom Aufbau ab
- Code ist verfügbar, die vollständige Testmenge nicht
- Bedeutung für die industrielle Robotik
- Quellen
Ein Benchmark für räumliche Anweisungen
Ein Gegenstand soll nicht einfach nur gegriffen, sondern an eine sprachlich beschriebene Position gebracht werden: etwa zwischen zwei anderen Objekten, neben einem Ziel oder in Richtung einer Tischkante. Solche Aufgaben verbinden Sprachverstehen, visuelle Wahrnehmung und präzise Bewegung. Genau diesen Bereich soll SO-101 Bench systematisch prüfen. Die von Truman Hickok vorgestellte Arbeit baut dafür eine Simulation des kostengünstigen SO-101-Roboterarms in Isaac Lab auf. [1][2]
Hintergrund der Arbeit ist laut den Autoren eine Lücke bei verfügbaren Tests: Bestehende SO-101-Benchmarks liefen auf realer Hardware und behandelten eher einfache Aufgaben mit wenigen zurückgehaltenen Objekten. Zugleich gebe es keine veröffentlichte Policy, die solche räumlich anspruchsvollen, sprachgesteuerten Aufgaben auf dem Arm ohne Anpassung bewältige. Das sind Aussagen der Studienautoren, keine unabhängige Bestandsaufnahme des gesamten Robotikfelds. [1][2]
- Die Simulation bildet einen realen SO-101-Aufbau als digitalen Zwilling nach.
- Der Benchmark kombiniert vier Aufgaben mit fünf bewerteten Aufgabenfamilien.
- Für die Auswertung sind 138 Objekte und 916 Episoden vorgesehen.
Benchmark-Vergleich
Erfolgsraten im SO-101-Bench-Haupttest
Die Studie vergleicht die Erfolgsraten benannter Systeme im Haupttest von SO-101 Bench.
SO-101 Bench Skala 0–100 %
- GPT-6.1 Sol + PyRUA-Lean + Galaxea 0.5 83,2 %
- InternW0-Δ 61,4 %
Hinweis: Der Benchmarkwert ist der ungewichtete Mittelwert der Erfolgsraten über 15 Aufgaben- und Objektzellen, nicht die Erfolgsrate über alle Episoden zusammen.
Quelle:[3] alphaxiv.org
Stand 30.10.2026
Daten KI-gestützt aus den Quellen des Artikels übernommen.
Was die Systeme bewältigen müssen
Die vier Aufgabentypen umfassen das Ablegen von Gegenständen in einem Behälter, das Platzieren neben einem anderen Objekt, das Ablegen zwischen zwei Objekten und eine gerichtete Bewegung in Richtung eines Begrenzungsobjekts. Beim Behälter gibt es Varianten mit einem und mit vier Gegenständen. Daraus ergeben sich fünf Aufgabenfamilien für die Bewertung. [3]
Die 138 Objekte sind in drei Gruppen aufgeteilt: 48 bekannte Instanzen, 43 bislang ungesehene Instanzen aus bekannten Objektklassen und 47 Objekte aus ungesehenen Klassen. Damit soll der Test unterscheiden, ob ein System lediglich bereits bekannte Exemplare wiedererkennt oder auch mit neuen Ausprägungen und Kategorien zurechtkommt. Die Hauptauswertung umfasst 916 auf Durchführbarkeit geprüfte Episoden, verteilt auf 15 Kombinationen aus Aufgabenfamilie und Objektsplit. [1][2][3]
Zusätzliche Teilmengen untersuchen visuelle Robustheit bei zurückgehaltenen Erscheinungsbildern, das Planen einer Drehung, damit ein Objekt passend abgelegt werden kann, sowie den Umgang mit zeitweise verdeckten Objekten. Die Tests zielen damit auf konkrete Fehlerquellen in der Manipulation. Sie belegen für sich genommen jedoch nicht, dass ein System eine Anweisung semantisch versteht: Ein erfolgreiches Ergebnis kann auch von visuellen Hinweisen oder anderen Eigenschaften der Testsituation abhängen. [3]
Gleiche Trainingsbasis, aber unterschiedliche Systemtypen
Für das Fine-Tuning gelernter Policies stellen die Autoren 3.629 simulierte Demonstrationen bereit und geben den Modellen ein gleiches Rechenbudget. Damit wird der Vergleich zwischen den trainierten Policies innerhalb des beschriebenen Protokolls besser kontrollierbar. Es handelt sich allerdings nicht um einen Vergleich aller denkbaren Trainingsverfahren oder um einen Nachweis gleicher Entwicklungsaufwände außerhalb dieses Tests. [1][2]
Die Untersuchung umfasst Vision-Language-Action-Modelle (VLA), die Sprach- und Bildinformationen in Roboteraktionen überführen, sowie World-Action-Modelle. Daneben steht ein anderer Ansatz: Ein Sprachmodell erzeugt Code für Lokalisierung, Planung und Platzierung, während eine gelernte Policy das Greifen übernimmt. Diese Aufteilung verbindet flexible, sprachmodellgestützte Planung mit einer trainierten motorischen Teilaufgabe. [1][2][3]
Der Abgleich mit realer Hardware
Der zentrale methodische Prüfstein ist nicht allein, ob die Simulation Aufgaben lösen lässt, sondern ob ihre Ergebnisse Rückschlüsse auf reale Roboter zulassen. Die Arbeit berichtet dazu zwei unterschiedliche Vergleiche. In einem Test mit unabhängig trainierten GR00T-N1.6-Policies für Simulation und reale Hardware ähnelten sich die Schwierigkeitsmuster über die 15 Aufgaben- und Objektzellen hinweg; die Autoren nennen eine Pearson-Korrelation von 0,86. Weil dabei Trainingsdaten und Auswertungsdomäne zugleich variieren, lässt sich aus diesem Vergleich laut der ausführlicheren Darstellung nicht ableiten, wie groß der absolute Simulationsfehler ist. [3]
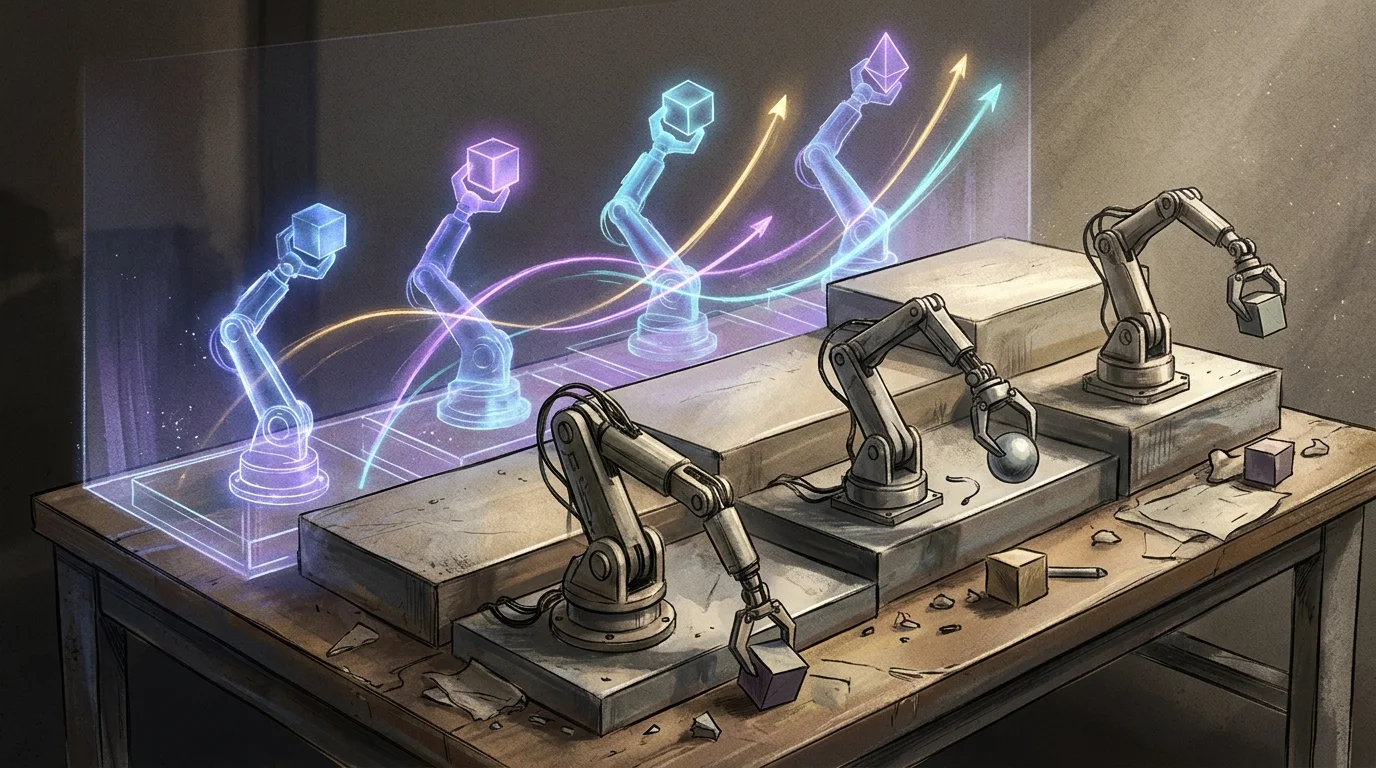
Aussagekräftiger für die Rangfolge ist ein zweiter Test: Vier ausschließlich mit simulierten Demonstrationen trainierte Policies und ein LLM-Agent wurden mit denselben Gewichten in beiden Umgebungen ausgeführt. Die fünf Systeme durchliefen 45 abgeglichene Layouts, die alle fünf Aufgabenfamilien und die drei Objekt-Splits abdecken. Ihre Reihenfolge war auf Simulation und Hardware identisch: Spearman ρ = 1,00, bei einem MMRV-Wert von 0,000. MMRV beschreibt hier die maximale Rangabweichung eines Systems; null bedeutet, dass die Rangfolge im getesteten Vergleich erhalten blieb. [1][2][3]
Das Ergebnis gilt nicht für die absoluten Erfolgsraten. Alle fünf Systeme waren in der Simulation erfolgreicher als auf dem realen Arm; die ausführliche Darstellung beziffert die Überschätzung je nach System auf 9 bis 31 Prozentpunkte. Ein Beispiel: Der GPT-6.1-Sol-Agent mit Galaxea 0.5 erreichte simuliert 84 Prozent, auf der Hardware 64 Prozent. Der Benchmark kann in diesem Versuch also Systeme relativ zueinander ordnen, aber simulierte Prozentwerte nicht als erwartbare Praxisleistung ausgeben. [3]
Ein gutes Ranking ist noch keine breite Transfergarantie
Die Rangtreue ist ein relevantes Signal für die Nutzung von Simulationen in der Entwicklung: Wenn sie sich wiederholt bestätigt, könnten Teams zunächst Policies in einer kontrollierten Umgebung vergleichen und aussichtsreiche Varianten anschließend auf Hardware prüfen. Die vorliegenden Daten stützen diese Lesart jedoch nur für fünf Systeme, 45 Layouts und einen beschriebenen realen Aufbau mit ungesehenen Objekten in einer neuen Umgebung. Sie belegen weder den Transfer auf andere Roboter noch auf beliebige Arbeitsplätze oder Aufgaben. [2][3]
Auch die Konfidenzgrenzen verdienen Beachtung. Für den MMRV-Wert nennt die Studie ein 95-Prozent-Konfidenzintervall von 0,000 bis 0,169. Der beobachtete Wert zeigt somit in der Stichprobe eine vollständige Übereinstimmung der Rangfolge; die Unsicherheit der Schätzung sollte bei der Verallgemeinerung mitberücksichtigt werden. Die Autoren ordnen die Simulation deshalb als hilfreich für Vergleiche ein, nicht als Ersatz für reale Validierung. [3]
VLA-Policies bleiben bei räumlicher Präzision zurück
Im Haupttest über 916 Episoden erreichten die stärksten trainierten Policies laut Studie 61,4 Prozent für InternW0-Δ und 60,8 Prozent für Galaxea 0.5. Die Autoren bewerten diese Ergebnisse als statistisch gleichauf. Die Kennzahl ist dabei nicht einfach der Anteil aller erfolgreich abgeschlossenen Episoden: Für den Gesamtwert wird der ungewichtete Mittelwert der Erfolgsraten über die 15 Aufgaben- und Objektzellen gebildet. Jede Zelle zählt damit gleich stark, auch wenn sie nicht gleich viele Episoden enthält. [1][2][3]
Die Fehler verteilen sich nicht gleichmäßig. Gelernte Policies schneiden bei vertrauten Objekten und Behälteraufgaben besser ab als bei genauer räumlicher Platzierung. Als verbleibende Schwächen nennt die Arbeit ungesehene Objektklassen und die Planung, ein Objekt passend zu drehen. Im PLAN-Teiltest erreichte der Hybrid aus Sprachmodell und gelernter Greifpolicy 75 Prozent; keine der gelernten Policies kam dort über 17 Prozent. Das weist auf eine deutliche Lücke bei dieser spezifischen Kombination aus Erkennen, Ausrichten und Ablegen hin. [1][2][3]
Der Agenten-Vorsprung hängt auch vom Aufbau ab
Der LLM-Agent mit Code-Erzeugung und delegiertem Greifen kam im Haupttest auf 83,2 Prozent und lag damit vor den trainierten VLA- und World-Action-Policies. Das Ergebnis ist nicht als direkter Beleg dafür zu lesen, dass ein Sprachmodell generell bessere Robotersteuerung ermöglicht: Der Agent nutzt eine andere Systemarchitektur und eine eigene Ausführungsumgebung. Für die Planung schreibt das Modell Code; das Greifen übernimmt Galaxea 0.5. [1][2][3]
Eine separate Ablation mit 60 gepaarten Episoden untersucht diesen Vorsprung genauer. GPT-6.1 Sol erzielte mit direkten Tool-Aufrufen 35 Prozent, mit dem PyRUA-Lean-Code-Harness 67 Prozent. Wurde innerhalb dieses Harness zusätzlich das Greifen an Galaxea 0.5 übergeben, stieg der Wert auf 85 Prozent; Galaxea allein kam in diesem Vergleich auf 53 Prozent. Diese Werte stammen aus einem anderen Test als der Hauptwert von 83,2 Prozent und sind deshalb nicht unmittelbar austauschbar. [3]
Die Ablation spricht dafür, dass sowohl die Wahl des Harness als auch die Kombination mit der gelernten Greifpolicy zum Ergebnis beitragen. Sie isoliert aber nicht, welche einzelne Eigenschaft des Harness den Zuwachs verursacht. Außerdem schließt das Zeitprotokoll die Rechenzeit des Modells aus; während das Modell rechnet, wartet der Arm. Aus den Erfolgswerten lässt sich daher keine Aussage über Echtzeitfähigkeit oder den Durchsatz eines produktiven Roboters ableiten. [1][2][3]
Code ist verfügbar, die vollständige Testmenge nicht
Das öffentliche Repository stellt nach eigenen Angaben die Isaac-Lab-Erweiterung, Aufgaben und Bewertungslogik, Baselines, Fine-Tuning-Rezepte sowie Werkzeuge für Teleoperation und reale Roboterläufe bereit. Für die Installation nennt es Isaac Sim 5.1, Isaac Lab, Python 3.11 und eine RTX-GPU als getestete Umgebung; die herunterzuladenden USD-Assets umfassen etwa zwei Gigabyte. Diese Angaben beschreiben die veröffentlichten Anforderungen und sind keine unabhängige Prüfung, wie leicht sich das Setup auf beliebigen Systemen betreiben lässt. [4]
Öffentlich ist zudem ein ausgewogener Validierungssatz mit 45 Episoden: drei pro Aufgabenfamilie- und Objekt-Split-Zelle. Er dient laut Repository der Entwicklung und Auswahl von Modellständen. Die vollständige Hauptauswertung mit 916 Episoden nutzt dagegen zurückgehaltene Objekte, Hintergründe und Roboterfarben; diese Testmenge ist nicht im Repository enthalten. Unternehmen und Forschungsteams können somit den Bewertungsablauf anhand der Validierungsdaten nachvollziehen, aber die publizierte Hauptauswertung nicht allein mit dem öffentlich verfügbaren Testsatz exakt wiederholen. [4]
Bedeutung für die industrielle Robotik
Für Unternehmen, die sprachgesteuerte Manipulation evaluieren, liegt der praktische Wert der Arbeit vor allem in der Trennung zweier Fragen: Welche Systeme schneiden im kontrollierten Test relativ besser ab, und welche Erfolgsrate ist auf realer Hardware zu erwarten? SO-101 Bench liefert für die erste Frage ein positives, aber eng begrenztes Signal. Für die zweite zeigt der Hardwareabgleich gerade, dass Simulationswerte nach unten korrigiert werden müssen und reale Versuche nicht entfallen. [2][3]
Die Ergebnisse machen außerdem deutlich, dass Modellwahl allein den Vergleich nicht bestimmt. Beim Agenten-Ansatz beeinflussen die Ausführungsumgebung und die Aufteilung der Arbeit zwischen Sprachmodell und gelernter Greifpolicy den gemessenen Erfolg. Für belastbare interne Tests sollten Unternehmen daher nicht nur Modellnamen und Gesamtwerte dokumentieren, sondern auch Aufgabenverteilung, Harness und Testbedingungen. Das ist eine aus den berichteten Ablationen abgeleitete methodische Konsequenz, keine im Paper geprüfte Unternehmensregel. [3]
Insgesamt liefert die Studie einen konkreten Weg, räumliche Sprachsteuerung auf einem kostengünstigen Roboterarm unter kontrollierten Bedingungen zu vergleichen. Sie belegt zugleich die Grenze dieses Ansatzes: Die Simulation bewahrte in einer kleinen Hardwareprüfung die Rangfolge, aber nicht das Niveau der Erfolgsraten. Für eine Einsatzentscheidung bleiben deshalb Tests auf der vorgesehenen Hardware, mit repräsentativen Objekten und den tatsächlichen Zeitvorgaben erforderlich. [1][2][3]
Quellen
- [1] Paper page - SO-101 Bench: Accessible Spatial Manipulation — https://huggingface.co/papers/2610.36420 (abgerufen am 2026-10-30)
- [2] [2610.36420] SO-101 Bench: Accessible Spatial Manipulation — https://arxiv.org/abs/2610.36420 (abgerufen am 2026-10-30)
- [3] SO-101 Bench: Accessible Spatial Manipulation | alphaXiv — https://www.alphaxiv.org/abs/2610.36420 (abgerufen am 2026-10-30)
- [4] GitHub - 5hadytru/so101_bench: Official repository for "SO-101 Bench: Accessible Spatial Manipulation" · GitHub — https://github.com/5hadytru/so101_bench (abgerufen am 2026-10-30)
//Nächster Artikel
Modelle & Forschung
A-RSI will multimodales KI-Training über Lernsignale gezielt erneuernA-RSI steuert den Austausch synthetischer multimodaler Trainingsaufgaben anhand von Lernsignalen. Die Benchmark-Angaben sind bislang knapp dokumentiert. [S1]
// Artikel teilen
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
- KI-Chat mit allen führenden ModellenGPT, Claude und Gemini in einer Oberfläche — mit Websuche und Quellenangaben.
- Eigene Modelle und Assistenten trainierenBilden Sie einen digitalen Marken-Experten auf Ihrem Wissen aus.
- Dokumente und Daten analysierenAuswerten, vergleichen und Abweichungen automatisch erkennen.
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
//Chronik