
SIRIS prüft, ob Sprachmodelle die Folgen fehlerhafter Simulationen richtig bewerten
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 3 Quellen
Das Wichtigste in Kürze
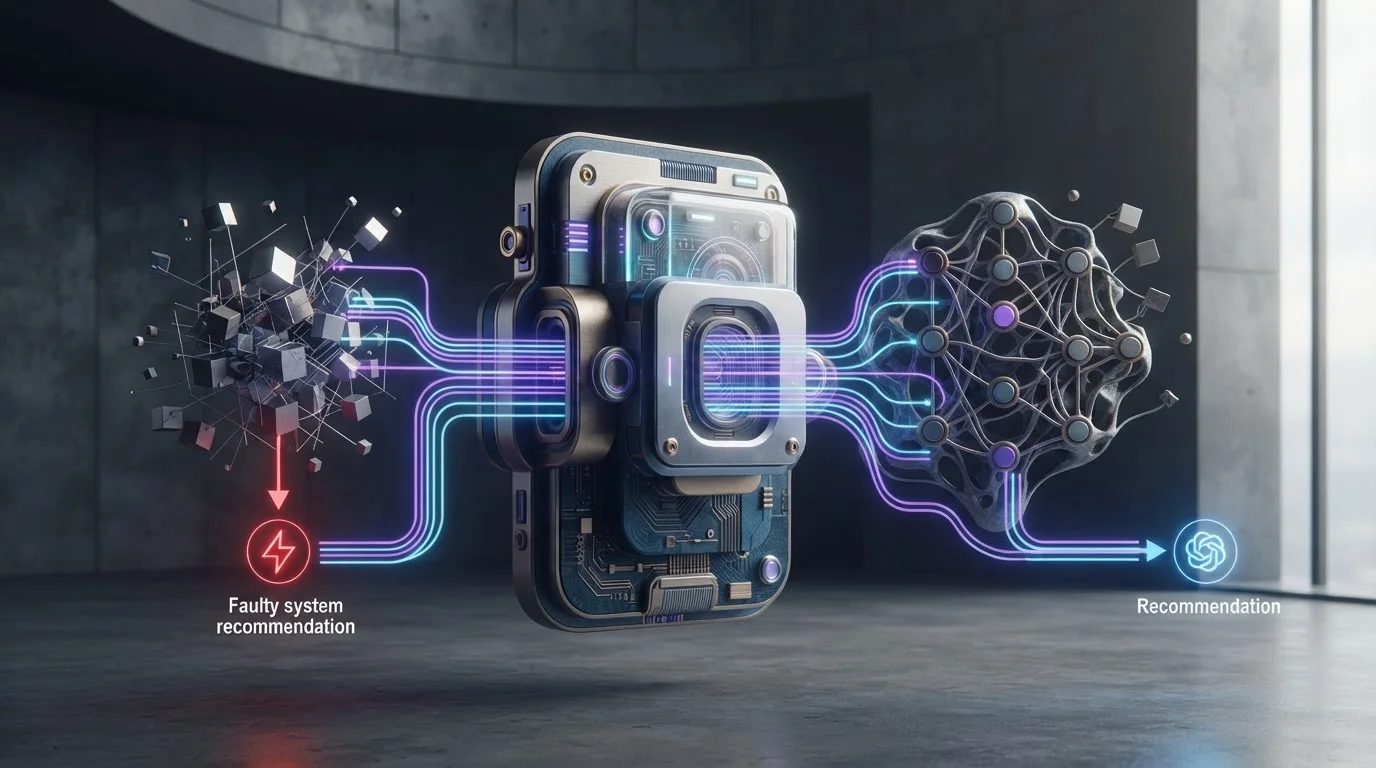
- SIRIS untersucht nicht nur, ob Sprachmodelle Simulationsfehler erkennen, sondern ob sie beurteilen, ob diese Fehler die empfohlene Systemauslegung tatsächlich verändern. [2]
- Der Benchmark vergleicht Aufgabenpaare mit identischen Designkandidaten und Empfehlungen des gestörten Simulators; ein Referenzsimulator stützt die Empfehlung jeweils nur für eine Aufgabe. [2]
- Die Autoren berichten, dass das Erkennen einer Einschränkung keine korrekte Designentscheidung garantiert und selbst starke Modelle gültige Empfehlungen verwerfen. [2]
- Ein zusätzlicher Prüfschritt kann manche Entscheidungen korrigieren, erzeugt laut Kurzbeschreibung aber bei anderen Modellen neue Fehler. [2]
- Für Unternehmen ist deshalb nicht nur die Fehlererkennung relevant, sondern die Robustheit der daraus abgeleiteten Entscheidungen. Das ist eine operative Schlussfolgerung aus dem Benchmark, kein in der Quelle getestetes Unternehmensresultat. [2][3]
Inhalt · 7 Abschnitte
- Der Prüfstein ist die Entscheidung, nicht allein der Simulatorfehler
- Kontrollierte Aufgabenpaare sollen die Relevanz isolieren
- Der Untersuchungsbereich bleibt auf LLM-Serving fokussiert
- Fehlererkennung führt nicht zuverlässig zur richtigen Auswahl
- Ein zusätzlicher Prüfschritt hilft, aber nicht ohne Nebenwirkungen
- Bedeutung für KI-gestützte Systementwicklung
- Was sich aus der verfügbaren Evidenz noch nicht ableiten lässt
- Quellen
Der Prüfstein ist die Entscheidung, nicht allein der Simulatorfehler
Ein am 10. November veröffentlichter X-Beitrag verwies auf SIRIS, eine Forschungsarbeit zur Frage, ob große Sprachmodelle einschätzen können, wann Fehler in Simulationen für die Auswahl eines Systemdesigns entscheidend sind. Der Beitrag selbst nennt keine Versuchsergebnisse; die inhaltlichen Angaben hier stützen sich auf die Paperbeschreibung. [1][2]
Die Autoren setzen bei einem praktischen Spannungsfeld an: Sprachmodelle werden zunehmend in Forschungsabläufe für Computersysteme eingebunden, in denen Simulationen helfen, mehrere Entwürfe schnell zu vergleichen. Solche Modelle bilden reale Systeme jedoch nicht vollständig ab. Eine Abweichung zwischen Simulation und Realität muss die Rangfolge der Entwürfe nicht zwingend verändern – sie kann aber auch dazu führen, dass eine zuvor empfohlene Lösung nicht mehr die richtige ist. [2]
Damit unterscheidet SIRIS zwei Fragen, die in einer einfachen Prüfung leicht zusammenfallen: Kann ein Modell eine Grenze des Simulators benennen? Und kann es beurteilen, ob diese Grenze für die konkrete Entscheidung relevant ist? Die zweite Frage verlangt eine Einschätzung der Folgen für die Auswahl, nicht bloß eine Beschreibung des Modellfehlers. Das ist die zentrale methodische Unterscheidung des Benchmarks. [2]
Kontrollierte Aufgabenpaare sollen die Relevanz isolieren
SIRIS konstruiert Paare von Arbeitslasten, also unterschiedlichen Belastungsprofilen eines Systems. Innerhalb eines Paars bleiben die möglichen Designkandidaten, die betrachtete Simulatorbeschränkung und die Empfehlung des gestörten Simulators gleich. Eine gezielte Veränderung des Simulators verschiebt die vorhergesagten Ergebnisse für beide Arbeitslasten; ein Referenzsimulator stützt die Empfehlung aber nur bei einer der beiden. [2]
Diese Konstruktion macht den Test anspruchsvoller als eine pauschale Frage nach der Genauigkeit eines Simulators. Das Sprachmodell soll unterscheiden, ob eine identische Einschränkung in zwei vergleichbaren Entscheidungssituationen unterschiedliche Konsequenzen hat. Die Versuchsanordnung prüft damit, ob ein Modell eine Abweichung in Beziehung zu den Kandidaten und zur konkreten Arbeitslast setzen kann. Das ist eine Interpretation des beschriebenen Designs, nicht ein zusätzliches Ergebnis der Studie. [2]
Für die Bewertung ist die Referenzsimulation entscheidend: Sie dient im Benchmark als Vergleich dafür, ob die Empfehlung des gestörten Simulators im jeweiligen Fall Bestand hat. Aus der Kurzbeschreibung lässt sich jedoch nicht ableiten, dass ein Referenzsimulator in realen Projekten stets die tatsächliche Systemleistung zuverlässig abbildet. Die Studie testet die Urteilsfähigkeit der Modelle in ihrer Versuchsanordnung, nicht die generelle Verlässlichkeit aller Simulatoren. [2]
Der Untersuchungsbereich bleibt auf LLM-Serving fokussiert
Die Autoren wenden SIRIS auf Designprobleme für das Bereitstellen von Sprachmodellen an und evaluieren nach der verfügbaren Paperbeschreibung 13 als führend bezeichnete Sprachmodelle. Der Benchmark befasst sich damit mit Systementscheidungen in einem klar umrissenen technischen Bereich, nicht mit beliebigen Simulationen in Produktion, Logistik oder industrieller Fertigung. [2]
Die bereitgestellte Kurzbeschreibung nennt weder die Namen der getesteten Modelle noch die Zahl der Aufgabenpaare, konkrete Fehlerquoten oder Leistungswerte einzelner Systeme. Auch Details dazu, wie die Simulatorstörungen im Einzelnen umgesetzt wurden, sind dort nicht ausgeführt. Aussagen über Ranglisten, Modellabstände oder statistische Signifikanz wären auf dieser Quellenbasis daher nicht belastbar. [2]
Die Eingrenzung ist für die Einordnung wichtig: Die Resultate betreffen ein Benchmarkdesign rund um LLM-Serving. Sie belegen nicht automatisch, dass sich die beobachteten Fehlerbilder in gleicher Form auf andere Branchen oder auf reale Entscheidungen übertragen lassen. Eine solche Übertragung wäre eine Hypothese für weitere Tests, kein nachgewiesenes Ergebnis von SIRIS. [2]
Fehlererkennung führt nicht zuverlässig zur richtigen Auswahl
Als Hauptergebnis berichten die Autoren, dass die Modelle eine Simulatorbeschränkung erkennen können, ohne deshalb die richtige Designentscheidung zu treffen. Selbst die stärksten getesteten Modelle verwerfen in manchen Fällen Empfehlungen, die weiterhin gültig sind. Damit kann eine Reaktion auf einen erkannten Fehler selbst zum Problem werden: Ein Modell behandelt die bloße Existenz einer Einschränkung möglicherweise so, als mache sie jede darauf gestützte Empfehlung unbrauchbar. [2]
Für den Betrieb eines KI-gestützten Forschungsablaufs ist das ein anderer Fehlertyp als eine falsche Vorhersage einzelner Messwerte. Entscheidend ist, ob sich der Fehler auf die Rangfolge der Kandidaten auswirkt. Ein System, das zwar auf Unsicherheit hinweist, aber nicht zuverlässig zwischen folgenlosen und entscheidungsrelevanten Abweichungen trennt, kann Empfehlungen unnötig verwerfen oder an einer ungeeigneten Lösung festhalten. Diese betriebliche Einordnung folgt aus dem von SIRIS beschriebenen Unterschied zwischen Simulatorfehler und Designentscheidung. [2]
Die Arbeit leitet daraus ab, das Systemverständnis von Sprachmodellen über Entscheidungen unter unvollkommenen Simulationen zu bewerten. Ein Modell sollte demnach nicht allein danach beurteilt werden, ob es eine Einschränkung korrekt benennt; relevant ist auch, ob seine Auswahl angesichts dieser Einschränkung tragfähig bleibt. [2]
Ein zusätzlicher Prüfschritt hilft, aber nicht ohne Nebenwirkungen
SIRIS untersucht außerdem eine Form der Selbstkorrektur: Nach einer ersten Bewertung erhält das Modell eine weitere Gelegenheit, seine Entscheidung zu überprüfen. Laut Abstract hilft ein solcher Review-Schritt einigen Modellen, gültige Empfehlungen wiederherzustellen. Bei mehreren anderen führt die Überprüfung jedoch zu neuen Fehlern. [2]
Die Ergebnisse sprechen daher nicht für eine pauschale Annahme, dass ein zweiter Durchlauf die Qualität einer Entscheidung automatisch erhöht. Eine Überprüfung kann zwar einen zuvor übersehenen Zusammenhang sichtbar machen; sie kann aber ebenso eine korrekte erste Einschätzung destabilisieren. In Unternehmensprozessen wäre es deshalb sinnvoll, Korrekturschritte an messbaren Kriterien zu prüfen, statt sie allein wegen ihrer zusätzlichen Reflexionsrunde als Sicherheitsgewinn zu behandeln. Das ist eine Analyse der gemischten Befunde, keine in der Studie getestete Prozessvorgabe. [2]
Die Kurzbeschreibung beziffert nicht, bei welchem Anteil der Modelle oder Aufgaben der Review-Schritt nützt oder schadet. Sie erlaubt deshalb keine Aussage über eine allgemeine Nettowirkung der Selbstkorrektur. Belastbar ist nur der qualitative Befund, dass der zusätzliche Schritt Ergebnisse verbessern und zugleich neue Fehler einführen kann. [2]
Bedeutung für KI-gestützte Systementwicklung
Der Kontext ist für Unternehmen relevant, weil Simulationen in der Systemforschung schnelle und vergleichsweise kostengünstige Vergleiche ermöglichen. Eine separate Arbeit zu AI-Driven Research for Systems beschreibt, wie ein KI-gestützter Ablauf Algorithmen erzeugt, in Systemen oder Simulatoren prüft und iterativ überarbeitet; sie betont zugleich, dass Simulatoren reale Systeme nur annähern. [3]
SIRIS verschiebt die Aufmerksamkeit damit von der Qualität eines einzelnen Simulationslaufs auf die Belastbarkeit der darauf aufbauenden Auswahl. Für Unternehmen, die Sprachmodelle in Design- oder Optimierungsabläufe einbinden, ergibt sich daraus als Analyse: Die Evaluation sollte auch Fälle umfassen, in denen der Simulator nachweislich eine Einschränkung hat, die Empfehlung aber trotzdem gültig bleibt – und umgekehrt. Andernfalls lässt sich nicht erkennen, ob ein Modell zwischen einer ungenauen Simulation und einer tatsächlich falschen Entscheidung unterscheidet. [2][3]
Ebenso folgt aus den Befunden, dass eine Modellwarnung allein keine Entscheidungskontrolle ersetzt. Wo Entscheidungen auf Simulationen beruhen, kann eine organisatorische Prüfung danach fragen, welche Kandidaten verglichen wurden, welche Einschränkung relevant war und ob die Empfehlung unter einer unabhängigen Referenz bestehen bleibt. Das ist eine mögliche Governance-Folge aus dem Benchmarkaufbau; die verfügbaren Quellen belegen nicht, dass SIRIS selbst ein solches Unternehmensverfahren implementiert oder validiert hat. [2]
Die Übertragbarkeit hängt zudem davon ab, wie ähnlich ein realer Anwendungsfall den getesteten LLM-Serving-Problemen ist. In anderen Systemen können die Arbeitslasten, Messgrößen und Folgen einer falschen Auswahl anders aussehen. Unternehmen müssten deshalb eigene repräsentative Tests entwickeln, bevor sie aus den SIRIS-Ergebnissen konkrete Aussagen über die Zuverlässigkeit eines internen KI-Agenten ableiten. [2]
Was sich aus der verfügbaren Evidenz noch nicht ableiten lässt
Die bereitgestellte Paperseite fasst die Ergebnisse in einem Abstract zusammen. Sie enthält in dem vorliegenden Text keine ausführliche Beschreibung des Versuchsprotokolls und keine numerischen Resultate. Entsprechend bleiben Fragen offen, etwa zur genauen Zusammensetzung der Aufgaben, zu den Messgrößen für korrekte Entscheidungen und dazu, wie groß die Auswirkungen einzelner Simulatorfehler waren. [2]
Auch die Bezeichnung der untersuchten Modelle als „frontier“ oder führend ist eine Beschreibung der Arbeit, kein unabhängiger Leistungsnachweis. Ohne Modellliste, Einzelwerte und weitere methodische Angaben lässt sich aus der Kurzbeschreibung kein allgemeines Urteil darüber ableiten, welche Modellfamilien bei solchen Entscheidungen überlegen sind. [2]
SIRIS liefert damit einen gezielten Hinweis auf eine Evaluationslücke: Technisches Wissen über den Simulator und die Fähigkeit, eine tragfähige Systementscheidung zu treffen, sind nicht dasselbe. Für belastbare Unternehmensanwendungen muss diese Lücke im jeweiligen Einsatzkontext geprüft werden; die vorliegenden Angaben reichen nicht aus, um eine pauschale Einsatzempfehlung für oder gegen Sprachmodelle auszusprechen. [2]
Quellen
- [1] SIRIS Can LLMs Tell When Simulation Errors Matter in AI-Driven Systems Research paper: — https://x.com/_akhaliq/status/2120216492189122726 (abgerufen am 2026-11-10)
- [2] Paper page - SIRIS: Can LLMs Tell When Simulation Errors Matter in AI-Driven Systems Research — https://huggingface.co/papers/2611.10329 (abgerufen am 2026-11-10)
- [3] Barbarians at the Gate:How AI is Upending Systems Research — https://arxiv.org/html/2510.06189v2 (abgerufen am 2026-11-10)
Nächster Artikel
Audio & Musik
VibeVoice: Langform-Sprachsynthese mit vier Stimmen – und offenen PraxishürdenMicrosofts VibeVoice erzeugt lange Dialoge mit bis zu vier Stimmen. Technischer Anspruch, Evaluation, Datenfragen und eingeschränkte Praxistauglichkeit im Überblick.
Artikel teilen
Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Recherchieren Sie KI-News wie diese selbst – mit Mindverse Studio.
7 Tage kostenlos testen – ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
Chronik