
PREEN übersetzt Bildstile in editierbare Smartphone-Presets
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 4 Quellen
Das Wichtigste in Kürze
- Das Forschungssystem PREEN berechnet aus einem Ausgangsbild und einer Stilreferenz 29 Reglerwerte für einen deterministischen Bildeditor, statt ein fertiges Rasterbild zu erzeugen. [1][2]
- Für das Training dienen Ausgaben eines Stiltransfer-Modells als Pseudo-Ziele; eine zweite Trainingsphase optimiert die Bildwirkung mit einem CIELAB-Verlust. [2][3]
- Auf dem Benchmark PST50 erzielt PREEN laut Paper die besten Werte bei PSNR, SSIM, LPIPS und ΔE*ab, liegt aber bei der Kennzahl HCorr hinter mehreren Baselines. [2][3]
- Eine Messung auf einem Snapdragon-8-Elite-Gen-5-Smartphone weist 283 Millisekunden für die Preset-Vorhersage aus; das ist keine ausgewiesene End-to-End-Zeit für den gesamten Bearbeitungsvorgang. [2][3]
- Ein Stärkeregler erlaubt, den Farbabgleich ohne erneute Modellinferenz zu intensivieren; die Nutzertests zeigen dabei einen Zielkonflikt zwischen Referenzähnlichkeit und eigenständiger Bildwirkung. [1][3]
- Die Ergebnisse beruhen auf einem kleinen Benchmark mit 50 Bildpaaren; die Übertragbarkeit auf andere Referenzen und Bearbeitungsanforderungen wurde laut Paper nicht getestet. [3]
Inhalt · 8 Abschnitte
- Ein Farbtransfer als Satz von Reglerwerten
- Pseudo-Ziele schließen eine Lücke in den Trainingsdaten
- Kompaktes Preset statt großer Farbtransformation
- PST50 zeigt Vorteile bei mehreren Bildmetriken
- Mobile Laufzeit: schnelle Vorhersage, nicht die ganze Pipeline
- Ein Regler macht den Zielkonflikt sichtbar
- Grenzen für den Transfer in reale Anwendungen
- Bedeutung: kontrollierbare Bearbeitung statt bloßer Bildausgabe
- Quellen
Ein Farbtransfer als Satz von Reglerwerten
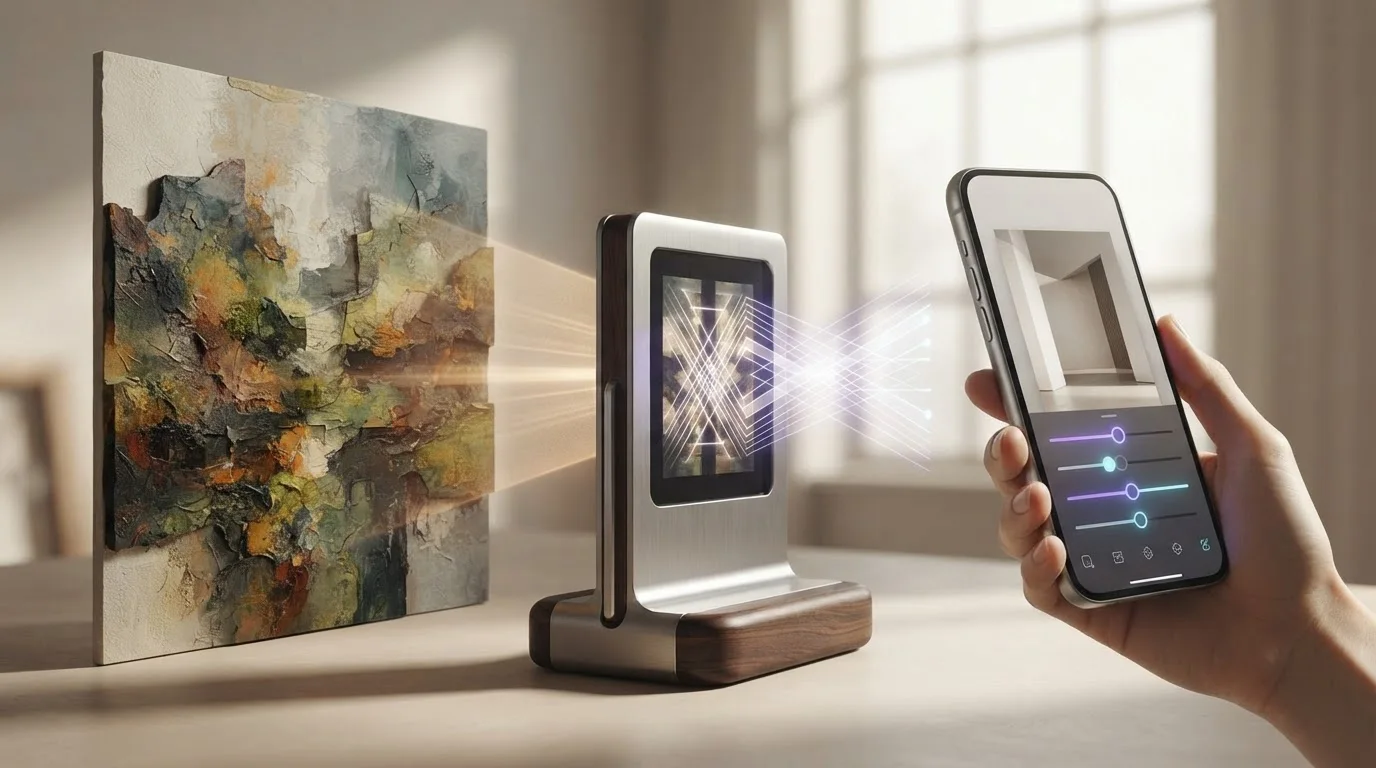
Das Forschungssystem PREEN soll eine vertraute Aufgabe in der Fotobearbeitung anders lösen: Sie geben ein Ausgangsbild und ein Referenzbild mit der gewünschten Farbwirkung vor, das Modell berechnet daraus jedoch kein neues fertiges Bild. Stattdessen sagt es 29 Parameter eines deterministischen Bildeditors voraus. Der Editor wendet diese Werte anschließend auf das Ausgangsbild an. Das Ergebnis ist damit ein editierbares Preset und keine vom Modell direkt erzeugte Rastergrafik. [1][2]
Vorgestellt wird PREEN – ausgeschrieben „Preset Regression via an Exemplar-based Editor Network“ – in einer Arbeit von Beomjin Ahn, der die Paper-Seite Samsung Research zuordnet. Der arXiv-Eintrag führt die Arbeit als für WACV 2027 angenommen. [1][2][4]
Die Datumsangaben der bereitgestellten Seiten sind nicht ganz deckungsgleich: Hugging Face nennt den 26. Oktober als Veröffentlichungsdatum und den 9. November als Einreichungsdatum der Paper-Seite; arXiv verzeichnet eine Einreichung am 27. Oktober 2026. Die Seiten belegen damit unterschiedliche Datumsfelder, nicht aber einen einheitlichen Veröffentlichungstag. [1][4]
- Die 29 Regler umfassen acht globale Einstellungen, darunter Belichtung, Kontrast und Sättigung, sowie 21 HSL-Werte für sieben Farbbereiche. [2][3]
- Zwölf Parameter betreffen Tonwerte, 17 die Farbigkeit; zu Letzteren zählen unter anderem Temperatur, Tönung sowie Farbton und Sättigung einzelner Farbbereiche. [2][3]
Benchmark-Vergleich
PSNR-Ergebnisse auf PST50
Die Autoren vergleichen PREEN mit Deep Preset auf dem PST50-Benchmark.
PSNR Skala 0 bis höchster Wert
- PREEN Im Fokus 24,63
- Deep Preset 23,29
Hinweis: Die Werte messen die Nähe zum Expertenziel, nicht die allgemeine ästhetische Präferenz.
Quelle:[3] alphaxiv.org
Stand 09.11.2026
Daten KI-gestützt aus den Quellen des Artikels übernommen.
Pseudo-Ziele schließen eine Lücke in den Trainingsdaten
Das zentrale Trainingsproblem: Zu einem beliebigen Paar aus Ausgangs- und Referenzbild gibt es normalerweise keinen bekannten Satz von Reglerwerten, der die gewünschte Übertragung exakt beschreibt. Die Arbeit begegnet diesem Mangel mit einem sogenannten Teacher-Modell. Dieses erzeugt zunächst ein stilisiertes Zielbild; anschließend optimieren die Forschenden die Parameter des differentiellen Editors so, dass dessen Ausgabe diesem Ziel möglichst nahekommt. Die optimierten Werte dienen als Pseudo-Labels für das Training. [2][3]
Als Teacher verwenden die Autoren SA-LUT, ein räumlich adaptives Look-up-Table-Verfahren. Seine Ausgabe wird also nicht als PREEN-Endprodukt übernommen, sondern als Ziel in den eingeschränkten Parameterraum des Editors übersetzt. Diese Umkehrung ist wichtig: Das Teacher-Modell kann räumlich unterschiedliche Anpassungen vornehmen, während PREEN ein kompaktes Set globaler und farbbereichsbezogener Regler ausgibt. [2]
Das Training erfolgt in zwei Stufen. Zunächst lernt ein Regressor, aus dem Bildpaar die Pseudo-Presets vorherzusagen. Dafür nutzt er Bildmerkmale aus einem CLIP-Encoder sowie ergänzende Farbstatistiken. In der zweiten Phase werden LoRA-Adapter trainiert; die Optimierung bewertet nun die bearbeiteten Bilder statt allein die Abweichung zwischen Reglervektoren. [2][3]
Der Grund für diese zweite Stufe ist, dass gleich große Änderungen an unterschiedlichen Reglern visuell nicht gleich stark auffallen müssen. Ein Bildverlust im CIELAB-Farbraum soll deshalb stärker an der wahrgenommenen Ausgabe ansetzen. Im Verfahren werden dabei Farbkanäle und Helligkeit getrennt berücksichtigt; laut Paper bleibt der eigentliche Editor während des Trainings differenzierbar und wird für die Ausgabe verwendet. [2]
Kompaktes Preset statt großer Farbtransformation
Die Architektur verknüpft einen CLIP-basierten Bildrepräsentationsschritt mit einem mehrschichtigen Regressor, der getrennte Ausgabepfade für Tonwerte und Farbigkeit besitzt. Die vorhergesagten Werte werden durch den festen Editor in ein Bild umgesetzt. Nach dem Training werden die LoRA-Adapter in die Modellgewichte integriert; die Autoren geben an, dass die zusätzliche Trainingsanpassung daher die Inferenzkosten nicht erhöht. [2]
Für die Anwendung ist die Trennung von Vorhersage und Bearbeitung relevant. Ein Reglervektor lässt sich speichern, prüfen und grundsätzlich nachjustieren; ein Rasterbild dagegen enthält die Bearbeitung bereits in seinen Pixeln. Das Paper beschreibt die Presets als kompakt, editierbar und von einem Editor verwendbar. Es belegt jedoch keine Kompatibilität mit beliebigen kommerziellen Bildbearbeitungsprogrammen: Die 29 Parameter entsprechen einer konkreten, an Smartphone-Editoren angelehnten Implementierung. [1][2]
Damit unterscheidet sich PREEN auch von Verfahren, die eine dichte Look-up-Tabelle oder direkt veränderte Pixel ausgeben. Solche Ausgaben können mehr räumliche Flexibilität bieten, sind aber nicht in derselben Form als benannte Reglerwerte organisiert. Der Ansatz setzt stattdessen auf eine begrenzte, nachvollziehbare Bearbeitungsrepräsentation. [2]
PST50 zeigt Vorteile bei mehreren Bildmetriken
Die Evaluation verwendet PST50, einen von Menschen kuratierten Benchmark mit 50 Fällen. Jeder Fall umfasst laut der Auswertung ein Ausgangsbild, eine Referenz und ein von Experten bearbeitetes Ziel; die Metriken werden auf Bildpaaren mit einer Auflösung von 256 × 256 Pixeln berechnet. Der Test misst somit, wie nahe die Ausgabe dem vorhandenen Expertenziel kommt, nicht unmittelbar, welche Variante Menschen generell am schönsten finden. [2][3]
In der Ergebnistabelle erreicht PREEN bei PSNR 24,63 dB und bei SSIM 0,914; bei LPIPS liegt der Wert bei 0,094. Die Arbeit führt diese Werte als führend unter den verglichenen Baselines auf. Zum Vergleich kommt die Rasterbildausgabe von Deep Preset bei PSNR auf 23,29 dB. Beim ΔE*ab, einem Maß für Farbabweichungen, liegt PREEN mit 9,07 ebenfalls numerisch vor den aufgeführten Baselines, darunter SA-LUT mit 9,63 und NLUT mit 9,81. [2][3]
Das Bild ist allerdings nicht in jeder Kennzahl gleich eindeutig. Bei HCorr erreicht PREEN 0,473; mehrere verglichene Verfahren liegen darüber, darunter NLUT mit 0,545 und SA-LUT mit 0,516. Außerdem weist die ergänzende Auswertung darauf hin, dass PREENs numerischer Vorsprung beim ΔE*ab gegenüber den LUT-Verfahren in den Tests pro Einzelbild nicht statistisch signifikant war. Die Resultate sprechen daher für bestimmte Stärken bei der Übereinstimmung mit den Expertenzielen, nicht für einen pauschalen Sieg in allen Qualitätsdimensionen. [2][3]
Für die Einordnung im Produktkontext ist auch die Benchmarkgröße entscheidend. Die 50 Fälle erlauben einen kontrollierten Vergleich, bilden aber keine breite Vielfalt realer Nutzerbilder, Referenzstile oder Bearbeitungsziele ab. Die Messwerte sind deshalb ein Forschungsresultat auf einem begrenzten Testbestand und kein Nachweis für gleichbleibende Qualität in beliebigen Bildbibliotheken. [2][3]
Mobile Laufzeit: schnelle Vorhersage, nicht die ganze Pipeline
Die Autoren berichten eine Messung mit einem quantisierten Modell auf einem Smartphone mit Snapdragon 8 Elite Gen 5. Für die Vorhersage eines Presets aus einem Bildpaar werden 283 Millisekunden angegeben; gemessen wurde CPU-basiert mit acht Threads, als Median aus 20 aufgewärmten Durchläufen. [3]
Diese Zahl beschreibt die Preset-Vorhersage und sollte nicht mit einer vollständigen End-to-End-Zeit für Laden, Vorverarbeitung, Anwendung aller Editoroperationen und Export gleichgesetzt werden. Auch die ergänzende Tabelle des Papers kennzeichnet ihre Zeitwerte für Preset-Verfahren als Dauer der Preset-Erzeugung, nicht der anschließenden Anwendung. [2][3]
Für Unternehmen und Anbieter von Bildbearbeitung ist die technische Aussage dennoch konkret: Eine kompakte Reglerprognose kann auf einem getesteten Smartphone in deutlich unter einer Sekunde berechnet werden. Das macht eine lokale Integration grundsätzlich plausibel, belegt aber weder die Leistung auf anderen Geräten noch die Qualität einer vollständigen Produktionspipeline. Die vorliegenden Seiten dokumentieren ein Forschungspaper und dessen Experimente, keine allgemeine Produktverfügbarkeit. [1][3][4]
Ein Regler macht den Zielkonflikt sichtbar
PREEN ergänzt die Vorhersage um einen Stärkeregler. Ein Faktor skaliert die 17 Farbparameter, während die zwölf Tonwertparameter unverändert bleiben. Die Arbeit bezeichnet α = 1 als Standardeinstellung und α = 5 als „Vivid“-Variante; der höhere Wert wurde nach visueller Prüfung gewählt und nicht anhand des Benchmarks optimiert. Da die Anpassung auf dem vorhergesagten Preset erfolgt, kann die Stärke nach einer einzigen Modellvorhersage verändert werden. [2][3]
Die menschliche Bewertung macht deutlich, dass stärkerer Referenzabgleich nicht automatisch eine bevorzugte Einzelbildästhetik bedeutet. In den paarweisen Tests wurde die Vivid-Variante bei der Frage nach der Stilähnlichkeit häufiger gegenüber PREENs eigener Standardeinstellung gewählt; gegenüber Deep Preset lag sie ebenfalls vorn. Bei der separaten Frage nach der ästhetischen Wirkung als Einzelbild fiel die Präferenz für Vivid geringer aus, während die Standardvariante Deep Preset übertraf. [3]
Die drei Studien umfassten jeweils 50 Teilnehmende, insgesamt also 150 Rater. Die Autoren berichten für Vivid gegenüber Deep Preset eine Präferenzrate von 61,6 Prozent beim Stilabgleich und für Vivid gegenüber PREENs Standard 73,4 Prozent. Bei der ästhetischen Einzelbildbewertung lag Vivid bei 43,3 Prozent; die Standardeinstellung gewann gegenüber Deep Preset 67,5 Prozent der Urteile. Diese Werte beantworten getrennte Fragen und sollten nicht zu einer einzigen allgemeinen Qualitätsrangfolge zusammengezogen werden. [3]
Für die Gestaltung eines Bearbeitungsprodukts ist das ein relevanter Befund: Eine Option kann die Nähe zur Vorlage erhöhen, ohne dass Nutzer sie zugleich als ansprechendste fertige Bearbeitung bewerten. Der Stärkeregler macht diesen dokumentierten Zielkonflikt zugänglich, statt eine einzige Einstellung als universell optimal auszugeben. Das ist eine Produktanalyse aus den im Paper berichteten Präferenztests, kein Beleg dafür, wie Nutzer in anderen Anwendungen entscheiden würden. [3]
Grenzen für den Transfer in reale Anwendungen
PREEN gibt ein einzelnes Preset für das Bild aus und ist damit weniger ausdrucksstark als räumlich adaptive Verfahren, die unterschiedliche Regionen unterschiedlich bearbeiten können. Die Autoren führen einen Teil der guten Benchmarkwerte auf die vergleichsweise zurückhaltenden Expertenbearbeitungen in PST50 zurück. Zugleich wurde laut der ergänzenden Darstellung nicht geprüft, wie sich das Modell bei Referenzbildern verhält, die von den im Test berücksichtigten Fällen getrennt sind. [3]
Auch der zugrunde liegende Editor setzt Grenzen: Wenn eine gewünschte Bearbeitung lokale Effekte oder eine umfassende Umordnung der Farbpalette erfordert, kann ein begrenzter Satz globaler und HSL-Regler dafür zu wenig Spielraum bieten. Die verfügbaren Quellen benennen solche editorbedingten Beschränkungen, liefern aber keinen umfassenden Katalog der Fälle, in denen die Methode scheitert. [2][3]
Für eine B2B-Einführung wären daher mindestens drei Fragen offen: Wie stabil bleibt die Qualität auf einer größeren und diverseren Referenzsammlung? Wie gut lässt sich das Parametermodell an die Regler und Verarbeitungskette eines konkreten Produkts anpassen? Und welche Laufzeiten ergeben sich für den vollständigen Bearbeitungsablauf auf unterschiedlichen Geräteklassen? Das Paper beantwortet diese Fragen nicht; sie sind Folgerungen aus der begrenzten Benchmarkabdeckung, dem spezifischen Editor und der beschriebenen Laufzeitmessung. [2][3]
Bedeutung: kontrollierbare Bearbeitung statt bloßer Bildausgabe
PREEN adressiert eine praktische Lücke zwischen automatischer Stilübertragung und manueller Nachbearbeitung: Das System soll einen Look aus einer Referenz ableiten, aber das Ergebnis in einer Form bereitstellen, die sich im Editor noch kontrollieren lässt. Für Softwareanbieter kann ein solcher Ansatz interessant sein, wenn Anwender Ergebnisse weiter anpassen, Presets speichern oder eine Farbkorrektur reproduzierbar auf weitere Bilder anwenden sollen. Die Quelle belegt die editierbare Preset-Ausgabe; ob sich daraus im jeweiligen Produkt tatsächlich ein effizienterer Arbeitsablauf ergibt, hängt von der Integration und den Nutzeranforderungen ab. [1][2]
Der Beitrag ist damit weniger ein Nachweis, dass ein Verfahren jede Form der Bildgenerierung ersetzt, als eine Untersuchung der Repräsentation und Bedienbarkeit von Farbtransfer. Die Ergebnisse zeigen, dass ein kompaktes, deterministisch anwendbares Preset auf dem getesteten Mobilgerät mit niedriger Vorhersagezeit erzeugt werden kann und bei mehreren Benchmarkmetriken überzeugt. Die kleine Evaluation, die abweichenden Resultate bei HCorr und die unterschiedlichen Präferenzen für Stilnähe und Einzelbildwirkung begrenzen jedoch die Reichweite dieser Aussage. [2][3]
Für eine belastbare Produktentscheidung ist PREEN deshalb vor allem als Forschungsansatz mit klaren technischen Eigenschaften relevant: begrenzte, lesbare Editorparameter statt direkt erzeugter Pixel, Training mit über einen Teacher gewonnenen Pseudo-Labels und eine veränderbare Stärke nach der Inferenz. Ob daraus eine robuste Funktion für reale Bildbestände wird, lässt sich anhand der vorliegenden Tests noch nicht abschließend beurteilen. [1][2][3]
Quellen
- [1] Paper page - PREEN: Exemplar-Based Color Style Transfer with Smartphone Editor Presets — https://huggingface.co/papers/2610.36896 (abgerufen am 2026-11-09)
- [2] PREEN: Exemplar-Based Color Style Transfer with Smartphone Editor Presets(Supplementary Material) — https://arxiv.org/html/2610.36896v1 (abgerufen am 2026-11-09)
- [3] PREEN: Exemplar-Based Color Style Transfer with Smartphone Editor Presets | alphaXiv — https://www.alphaxiv.org/abs/2610.36896 (abgerufen am 2026-11-09)
- [4] [2610.36896] PREEN: Exemplar-Based Color Style Transfer with Smartphone Editor Presets — https://arxiv.org/abs/2610.36896 (abgerufen am 2026-11-09)
Nächster Artikel
Bild & Video
BYOD macht aus vier Sprachmodellen Diffusionsmodelle – mit klarer QualitätslückeBYOD wandelt vier vortrainierte Sprachmodelle per LoRA in Diffusionsmodelle um. Die Studie berichtet kurze Trainingszeiten, aber Schwächen bei freier Textgenerierung.
Artikel teilen
Mehr zu Bild- & Video-KI
Alle Bild & Video-News- GLOW-FM setzt bei Low-Light-Bildern auf eine einzige latente Modellberechnung
GLOW-FM soll Low-Light-Bilder mit einem einzigen Flow-Schritt verbessern. Was die Methode leistet – und was für den Praxiseinsatz noch offen ist.
- KI-Videos planbarer produzieren: Warum ein Bild als Startpunkt hilft
Warum Text-to-Video oft schwer steuerbar ist und wie ein Image-to-Video-Workflow mit Referenzbild, klarer Regie und Nachbearbeitung mehr Kontrolle schafft.
- Holo4D verbindet 4D-Szenenspuren mit Video-Diffusion für neue Kameraperspektiven
Holo4D verbindet 4D-Punkttrajektorien mit Video-Diffusion, um Kamerafahrten in Einzelkamera-Videos geometrisch zu steuern. Was Tests zeigen – und wo Grenzen liegen.
- AB-Attention zielt auf präzisere Beschleunigung von Video-Diffusion
AB-Attention soll den Rechenaufwand von Video-Diffusion-Transformern durch gewichtete Blockauswahl senken – bei hoher Sparsität und geringerem Qualitätsverlust.
Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
- Dokumente und Daten analysierenAuswerten, vergleichen und Abweichungen automatisch erkennen.
- Eigene Modelle und Assistenten trainierenBilden Sie einen digitalen Marken-Experten auf Ihrem Wissen aus.
- KI-Bilder im eigenen MarkenstilBildgenerierung mit Flux und Imagen, inklusive Brand Kits und eigenen Styles.
Recherchieren Sie KI-News wie diese selbst – mit Mindverse Studio.
7 Tage kostenlos testen – ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.