
OmniShowcase ergänzt Video-KI um rekonstruierte 3D-Geometrie
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 4 Quellen
Das Wichtigste in Kürze
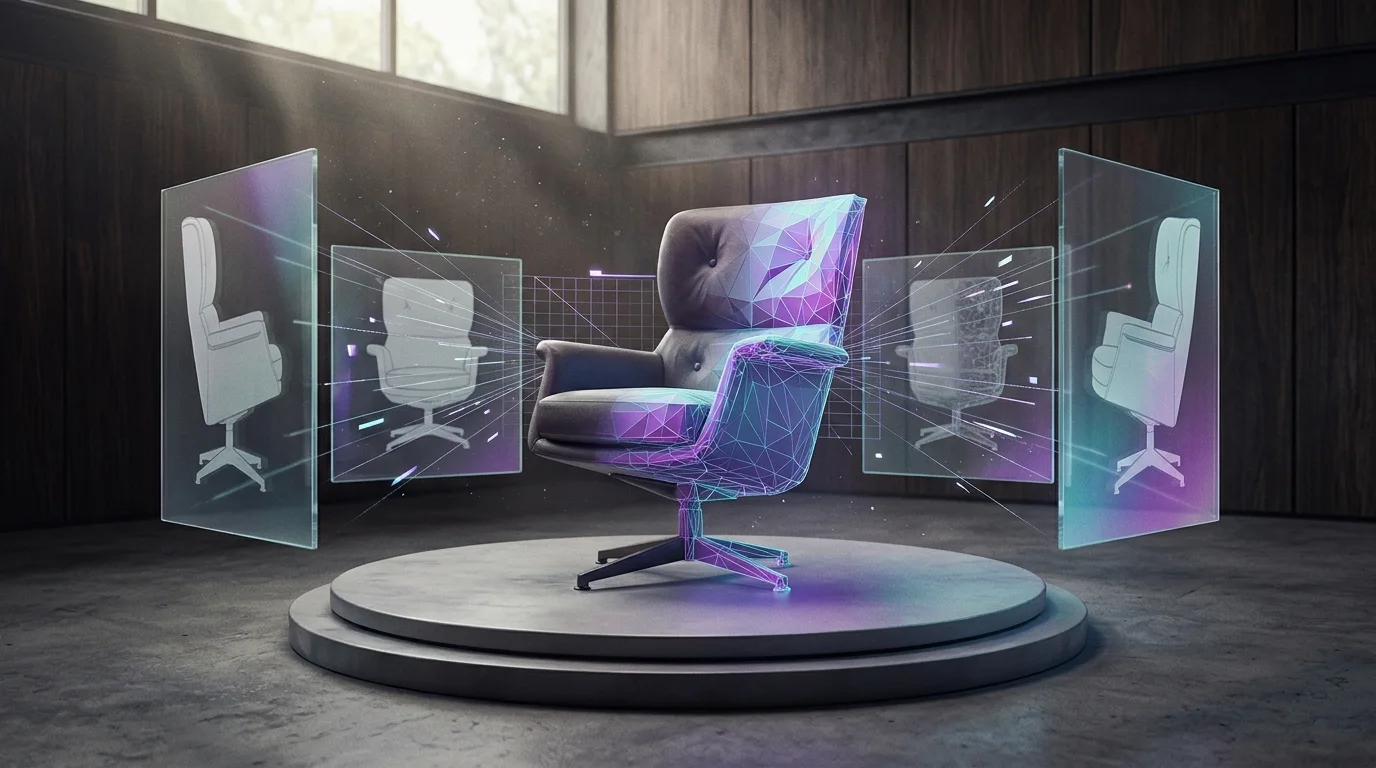
- OmniShowcase soll die Identität eines Motivs bei Kamerabewegungen stabilisieren, indem das Modell neben vier Referenzbildern auch eine rekonstruierte 3D-Geometrie erhält. [1] [2]
- Für das Training rendern die Forschenden Motive aus 3D-Assets und kombinieren sie mit synthetisierten Hintergründen; Showcase-4K umfasst laut Paper 4.000 Videos. [2]
- Die Geometriebedingung besteht aus 25 Oberflächennormalen-Ansichten und wird ohne frameweise Zuordnung mit dem Zielvideo verarbeitet. [2]
- Die Forschenden berichten von hoher Subjektidentität und 3D-Konsistenz bei konkurrenzfähiger Videoqualität; die bereitgestellten Quellen enthalten jedoch keine vollständigen quantitativen Ergebnisdetails. [1] [2]
- Showcase-4K, ShowcaseBench und der zugehörige Synthesecode sollen öffentlich bereitgestellt werden; aus den Quellen lässt sich die tatsächliche Verfügbarkeit nicht bestätigen. [2]
// Inhalt · 8 Abschnitte
- Das Problem: neue Blickwinkel lassen Bildmodelle raten
- Zwei Bausteine: kontrollierte Trainingsdaten und Geometrie als Bedingung
- Showcase-4K: 4.000 Videos aus 3D-Assets
- Warum die Normalenfolge nicht Frame für Frame ausgerichtet wird
- Benchmark und Leistungsangaben
- Einordnung gegenüber Mehrbildverfahren
- Mögliche Bedeutung für Unternehmen
- Vorläufiger Forschungsstand, keine bestätigte Produktverfügbarkeit
- Quellen
Das Problem: neue Blickwinkel lassen Bildmodelle raten
Subject-to-Video-Systeme erzeugen Videos eines vorgegebenen Motivs anhand von Referenzbildern. Eine zentrale Schwierigkeit entsteht, wenn die Kamera im Video Flächen zeigt, die auf diesen Bildern nicht zu sehen sind: Das Modell muss dann Erscheinungsbild und Form der verdeckten Seiten erschließen. Laut den Forschenden können dabei Silhouette, Struktur und Oberflächendetails über den Clip hinweg inkonsistent werden. [2]
Mehrere Referenzansichten liefern zwar zusätzliche visuelle Hinweise, beschreiben aber nicht automatisch die räumliche Struktur, die diese Ansichten miteinander verbindet. OmniShowcase setzt deshalb nicht allein auf mehr Bildinformation, sondern ergänzt sie um eine explizite, aus den Referenzen rekonstruierte Geometrie. Das adressiert nach Darstellung der Autoren ein geometrisches Problem: Das Modell soll Ansichten konsistent erzeugen, auch wenn die Eingabebilder diese Perspektiven nicht direkt zeigen. [1] [2]
Zwei Bausteine: kontrollierte Trainingsdaten und Geometrie als Bedingung
Das Verfahren verbindet eine automatisierte Datensynthese mit einer Geometriebedingung für das Videomodell. In der Trainingspipeline werden Referenzbilder und Zielvideo aus demselben 3D-Asset gerendert. Damit beruhen die unterschiedlichen Perspektiven auf einer gemeinsamen Form und Erscheinung, statt die nicht sichtbaren Seiten jeweils durch ein generatives Videomodell ergänzen zu lassen. [2]
Für die Geometrie verwendet OmniShowcase nicht einfach das bekannte Quellnetz des Trainingsobjekts. Stattdessen rekonstruieren die Autoren sie aus den vier Referenzbildern. Das soll die Trainingsbedingung an die Inferenz angleichen: Bei einem neuen Motiv steht dem System ebenfalls nur eine kleine Zahl von Ansichten zur Verfügung, nicht das zugrunde liegende 3D-Modell. [2]
Aus der Rekonstruktion erzeugt das System eine Abfolge von Oberflächennormalen. Eine Normalenkarte kodiert die lokale Orientierung sichtbarer Oberflächen und vermittelt dem Modell damit einen strukturellen Hinweis auf die Form. Sie liefert nicht dieselbe Art von Erscheinungsinformation wie ein RGB-Bild; die Referenzbilder bleiben deshalb Teil der Eingabe. Die Autoren beschreiben das Zusammenspiel als visuelle Informationen aus den Bildern und 3D-Struktur aus der Normalenfolge. [2]
Showcase-4K: 4.000 Videos aus 3D-Assets
Das Trainingskorpus Showcase-4K umfasst laut Paper 4.000 Videos. Die Pipeline nutzt 3D-Netze aus Sammlungen wie Objaverse sowie – für gescannte Motive – dem Digital Twin Catalog und Google Scanned Objects. Nach einer Vorauswahl werden die Assets aus mehreren Blickrichtungen geprüft. Für jedes ausgewählte Netz rendert das Team vier Referenzansichten und ein Zielvideo, sodass beide auf derselben Geometrie beruhen. [2]
Die Autoren beschreiben zwölf Kamerabewegungen und insgesamt 88 Trajektorienkonfigurationen. Dazu gehören Umlauf- und Helixbewegungen sowie Varianten von Bogen-, Verschiebe-, Dolly- und Zoombewegungen. Diese Bandbreite soll unterschiedliche Bewegungsverläufe abdecken, statt das Training auf einen einfachen Rundgang um das Motiv zu beschränken. [2]
Direkte Renderings ergeben zunächst Motive vor sauberen Hintergründen. Um Szenen mit passender Umgebung einzubeziehen, ergänzt die Pipeline einen Schritt zur Hintergrundgenerierung: Ein Video-Inpainting-Modell soll den Hintergrund um das gerenderte Motiv herum erzeugen, während dessen gerenderte Pixel unverändert bleiben. Eine zusätzliche automatisierte Prüfung verwirft nach Angaben der Autoren Fälle, in denen das Motiv etwa deformiert wirkt oder nicht konsistent zu den Referenzen erscheint. [2]
Die Geometriebedingung wird ebenfalls automatisiert erzeugt. Die vier Ansichten werden zunächst rekonstruiert und zu einer 3D-Darstellung zusammengeführt. Daraus rendert das System 25 Normalenansichten entlang einer Drehung um die Hochachse. Das Zielvideo umfasst im beschriebenen Trainingsaufbau 80 Frames; die Normalenfolge und das Zielvideo werden als getrennte Sequenzen verarbeitet. [2]
Warum die Normalenfolge nicht Frame für Frame ausgerichtet wird
Die Normalenansichten und das zu erzeugende Video bilden nicht dieselbe Kamerabewegung ab. Die Normalenfolge dient als geometrietragende Rundumschau; die Bewegung des Zielvideos wird dagegen über den Textprompt festgelegt. OmniShowcase führt beide Bedingungen deshalb als getrennte Sequenzteile in den Modellkontext ein, anstatt jede Normalenkarte einem bestimmten Zielbild zuzuordnen. [2]
Technisch baut das System auf einem vortrainierten Image-to-Video-Diffusionstransformer auf. Die Forschenden passen ihn mit LoRA an und halten die Gewichte des Basismodells laut Paper eingefroren. Bei der Inferenz werden die Referenzbilder und die aus ihnen rekonstruierte Normalenfolge zusammen mit dem Prompt verarbeitet, ohne das Modell für jedes neue Motiv separat zu optimieren. [2]
Für Unternehmen ist diese Trennung relevant, weil sie eine Geometriebedingung mit unterschiedlichen gewünschten Kamerabewegungen vereinbar machen könnte: Die Normalenfolge soll die Form vermitteln, während der Prompt die Bewegung vorgibt. Das ist eine Aussage über den Aufbau des Verfahrens, nicht der Nachweis, dass es jede Kombination aus Motiv, Szene und Kamerafahrt zuverlässig bewältigt. [2]
Benchmark und Leistungsangaben
Zur Evaluation stellen die Forschenden ShowcaseBench vor. Der Benchmark enthält laut Paper zurückgehaltene Testbeispiele sowie die Quellnetze und Kameraparameter, die zum Rendern der Videos verwendet wurden. Diese Informationen erlauben es, erzeugte Ansichten mit einer bekannten 3D-Grundlage zu vergleichen. Im verfügbaren Paper-Auszug wird ein Teilbenchmark mit 50 Motiven und vier 360-Grad-Kameratrajektorien beschrieben; weiterführende Tabellen und vollständige Messwerte sind im bereitgestellten Text nicht enthalten. [2]
Die Autoren berichten, OmniShowcase erreiche im Vergleich zu Einzel- und Mehrbildverfahren Spitzenwerte bei der Erhaltung der Subjektidentität und der 3D-Konsistenz, während Videoqualität und Bewegung konkurrenzfähig blieben. Das sind Ergebnisse, wie sie die Forschenden selbst zusammenfassen; die vorliegenden Quellen ermöglichen keine unabhängige Prüfung der Rangfolge oder der genauen Testbedingungen. [2]
Ein Community-Beitrag auf der Hugging-Face-Seite nennt zusätzlich eine Verringerung des geometrischen Fehlers um 52 Prozent gegenüber dem besten Mehrbildvergleich auf ShowcaseBench und um 46 Prozent bei realen NAVI-Objekten. Diese Zahlen sind auf der Seite nicht mit Messdefinitionen oder den zugrunde liegenden Ergebnistabellen ausgeführt. Sie sollten daher als dort veröffentlichte Zusatzangabe und nicht als hier unabhängig nachvollzogene Leistungsbewertung gelesen werden. [1]
Einordnung gegenüber Mehrbildverfahren
OmniShowcase steht in einem Forschungsfeld, das mehrere Referenzansichten für die subjektgesteuerte Videogenerierung nutzt. Das Paper vergleicht den Ansatz unter anderem mit MV-S2V: Dieses Verfahren verarbeitet ebenfalls mehrere Ansichten, verwendet laut seiner Projektbeschreibung aber einen eigenen Mechanismus, um unterschiedliche Subjekte und verschiedene Ansichten desselben Subjekts in der Referenzkonditionierung auseinanderzuhalten. [2] [5]
Der von OmniShowcase hervorgehobene Unterschied liegt in der expliziten Geometriebedingung. Die Autoren argumentieren, dass Referenzbilder zwar Erscheinungsinformationen aus mehreren Blickwinkeln liefern, aber die verbindende 3D-Oberfläche nicht direkt kodieren. Die Normalenfolge soll diese Lücke schließen. Das ist eine plausible technische Abgrenzung des Ansatzes, sagt für sich genommen aber noch nichts darüber aus, welches Verfahren in einer konkreten betrieblichen Anwendung besser abschneidet. [2]
Auch bei der Datenbasis unterscheidet sich die Methode von Ansätzen, die überwiegend reale Videos oder statische Mehrbildaufnahmen nutzen: Showcase-4K wird aus 3D-Asset-Renderings erzeugt. Das gibt den Autoren eine bekannte Geometrie und Kameraführung für die Trainingsbeispiele, begrenzt die Aussagekraft aber nicht automatisch auf reale Aufnahmen oder beliebige Objektkategorien. [2] [5]
Mögliche Bedeutung für Unternehmen
Für Teams, die wiederholt Videoansichten eines bestimmten Produkts, Objekts oder digitalen Assets benötigen, ist der Ansatz konzeptionell interessant: Vier Referenzbilder sollen genügen, um Erscheinungsinformationen bereitzustellen, während eine rekonstruierte Geometrie die Konsistenz bei neuen Blickwinkeln unterstützt. Die Quellen belegen jedoch keine produktive Integration in bestehende Content-Pipelines und weisen auch keine kommerziellen Kennzahlen oder Laufzeitangaben aus. [1] [2]
Als Analyse lässt sich daraus ableiten, dass die Qualität einer solchen Pipeline von mehreren vorgelagerten Schritten abhängen dürfte: Die Referenzbilder müssen die relevanten Seiten erfassen, die 3D-Rekonstruktion muss brauchbare Normalen liefern, und die gewünschte Kamerabewegung muss vom Modell umgesetzt werden. Die Autoren beschreiben die Rekonstruktion aus wenigen Ansichten als Teil des Verfahrens, liefern im verfügbaren Material aber keine umfassende Fehleranalyse für schwierige Materialien, feine Details oder stark verdeckte Geometrie. [2]
Ebenso bleibt offen, wie zuverlässig das Verfahren bei dynamischen Motiven, stark wechselnder Beleuchtung oder komplexen Interaktionen funktioniert. Die beschriebenen Trainingsvideos basieren auf 3D-Assets, während die Hintergründe separat erzeugt werden. Für eine Beschaffungs- oder Entwicklungsentscheidung sollten Sie deshalb zwischen der technischen Demonstration eines konsistenten Rundgangs und einer belastbaren Validierung im eigenen Produktionskontext unterscheiden. [2]
Vorläufiger Forschungsstand, keine bestätigte Produktverfügbarkeit
OmniShowcase ist als arXiv-Preprint veröffentlicht; die ResearchGate-Seite weist allgemein darauf hin, dass Preprints und frühe Forschung noch nicht zwingend peer-reviewed sind. Die vorliegenden Quellen belegen daher eine Forschungsarbeit und die von den Autoren berichteten Resultate, nicht eine unabhängige wissenschaftliche Bestätigung. [2] [3]
Die Forschenden kündigen an, Showcase-4K, ShowcaseBench und den Synthesecode öffentlich bereitzustellen. Die Hugging-Face-Seite verlinkt zwar Projekt- und GitHub-Seiten, doch aus den gelieferten Texten geht nicht hervor, ob Datensatz und Code zum Veröffentlichungszeitpunkt vollständig verfügbar sind. Für Unternehmen ist diese Unterscheidung wichtig: Eine angekündigte Ressource ist nicht gleichbedeutend mit einem bereits zugänglichen oder produktionsreifen System. [1] [2]
Quellen
- [1] Paper page - OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images — https://huggingface.co/papers/2610.35684 (abgerufen am 2026-10-29)
- [2] OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images — https://arxiv.org/html/2610.35684v1 (abgerufen am 2026-10-29)
- [3] (PDF) OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images — https://www.researchgate.net/publication/416921337_OmniShowcase_Omnidirectional_Subject-Consistent_Video_Generation_from_Multi-View_Images (abgerufen am 2026-10-29)
- [5] MV-S2V: Multi-View Subject-Consistent Video Generation — https://szy-young.github.io/mv-s2v (abgerufen am 2026-10-29)
//Nächster Artikel
Bild & Video
DTCA verfeinert das Reinforcement Learning für Diffusions-SprachmodelleDTCA verteilt RL-Lernsignale in Diffusions-Sprachmodellen auf einzelne Tokens. Ein Preprint meldet Zugewinne bei Mathe-Benchmarks, lässt aber Fragen offen.
// Artikel teilen
Mehr zu Bild- & Video-KI
Alle Bild & Video-News- ThinkWorld nutzt Weltvorhersagen, um Roboterlernen mit menschlichen Videos zu verbinden
ThinkWorld nutzt Dynamik-Ketten und menschliche Videos fürs Roboterlernen. Die Autoren berichten über Benchmarks und Tests an realen Robotern. [S2][S5]
- Hy-Nomas verbindet Videogenerierung mit mehrstufiger Text- und Kamerasteuerung
Tencent stellt Hy-Nomas als offenes interaktives Videomodell vor. Architektur, Hardwareanforderungen und Grenzen für Unternehmensanwendungen im Überblick.
- RynnWorld-Latent verbindet Robotervideos über gemeinsame latente Aktionen
RynnWorld-Latent nutzt gemeinsame latente Aktionen, um Videos von Menschen, Robotern und Simulationen für Weltmodelle und Robotiktraining zu verbinden.
- Tencent stellt Hy-Nomas für interaktive Videowelten vor
Tencent Hunyuan veröffentlicht Hy-Nomas für mehrstufige Text- und Kamerasteuerung. Die offene Implementierung bringt klare Hardwareanforderungen und offene Bewertungsfragen mit.
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
- KI-Chat mit allen führenden ModellenGPT, Claude und Gemini in einer Oberfläche — mit Websuche und Quellenangaben.
- KI-Bilder im eigenen MarkenstilBildgenerierung mit Flux und Imagen, inklusive Brand Kits und eigenen Styles.
- Prozesse mit KI-Workflows automatisierenVisuelle Automatisierung wiederkehrender Abläufe — mit Freigabeschritten.
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
//Chronik