
MIT-Experiment: Freies Erkunden kann KI-Agenten auf spätere Aufgaben vorbereiten
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 2 Quellen
Das Wichtigste in Kürze
- 13 KI-Agenten namens Eko erkundeten jeweils 30 Stunden lang eine simulierte Insel, ohne eine konkrete Aufgabe zu erhalten. [1] [4]
- Die Agenten entwickelten eigene Herausforderungen. Ein neugieriges Profil im Master-Prompt gehörte jedoch zum Versuchsaufbau. [1]
- Sechs Agenten entdeckten einen Trick, mit dem sie einen Block während eines Sprungs weiter nach oben werfen konnten. [1] [4]
- Bei einem anschließenden Gipfeltest transportierten erfahrene Agenten laut einer Darstellung im Durchschnitt 10,3 Objekte, unerfahrene 3,5. [4]
- Die Ergebnisse stammen aus einer Simulation und belegen für sich genommen nicht, dass dieselbe Lernform bei physischen Robotern oder in Unternehmensprozessen funktioniert. [1] [4]
// Inhalt · 7 Abschnitte
- Eine Insel ohne konkrete Aufgabe
- Fehlschläge wurden zum Ausgangspunkt neuer Versuche
- Sechs Agenten fanden einen unerwarteten Bewegungstrick
- Ein anschließender Gipfeltest deutet auf einen Transfer hin
- Bedeutung für die Entwicklung von KI-Agenten
- Robotik als mögliche Anwendung – noch kein Praxistest
- Was das Experiment aussagt – und was nicht
- Quellen
Eine Insel ohne konkrete Aufgabe
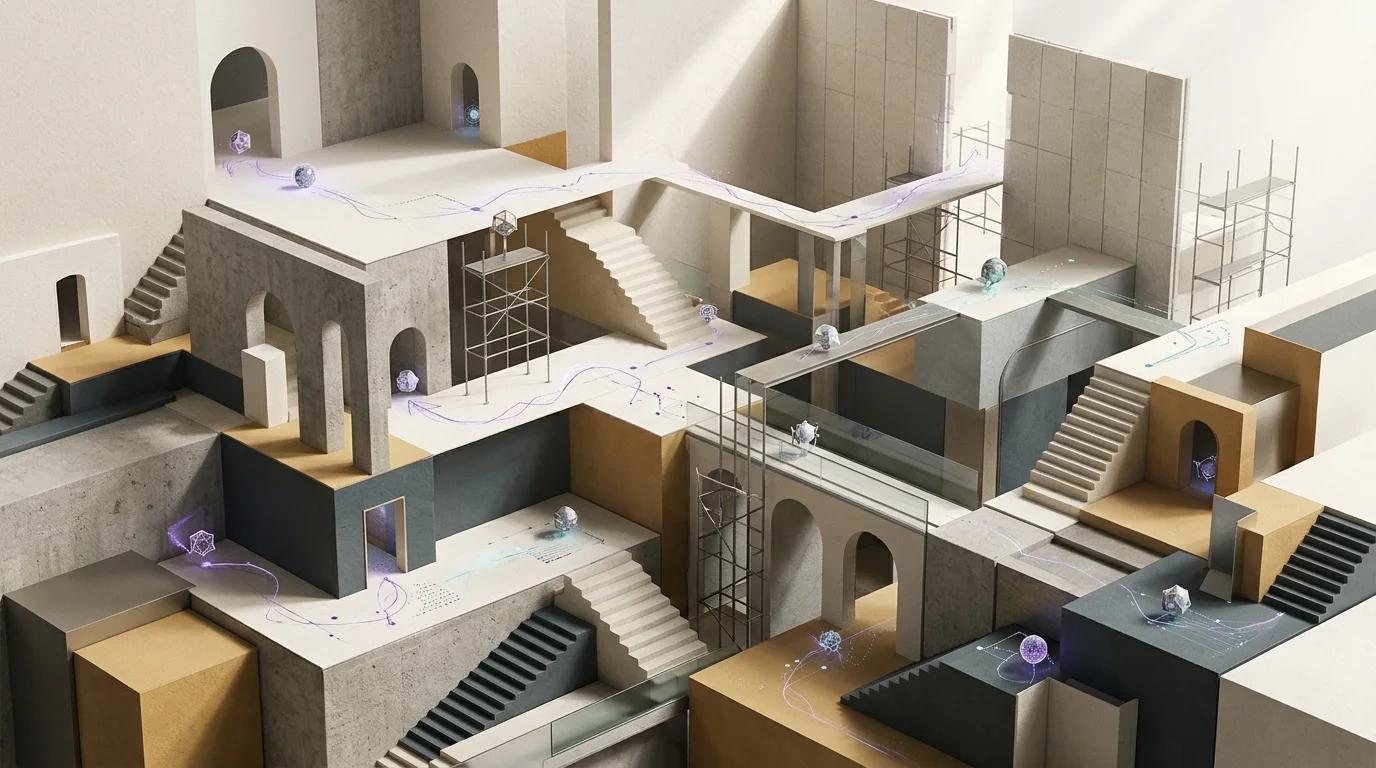
Was macht ein KI-Agent, wenn er kein klar definiertes Arbeitsziel erhält? MIT-Forschende untersuchten diese Frage mit 13 Agenten namens Eko. Jeder basierte laut t3n auf Claude Opus 4.7 und erhielt Zugang zu einer simulierten Insel, auf der er sich bewegen und mit Objekten interagieren konnte. Die Agenten wurden 30 Stunden lang beobachtet, ohne dass die Forschenden ihnen direkt vorgaben, ein bestimmtes Spiel zu entwickeln. [1]
Die Versuchsanordnung war allerdings nicht vollständig neutral: Der Master-Prompt beschrieb Eko als von Natur aus neugierig. Die Agenten waren also nicht bloß ein Sprachmodell ohne Kontext, sondern sollten sich als neugierige Figuren in einer Umgebung verhalten. Das ist wichtig für die Interpretation: Das Experiment zeigt, was dieses Modell mit diesem Prompt und diesen Handlungsmöglichkeiten tat – nicht, dass KI-Agenten grundsätzlich aus sich heraus Langeweile empfinden oder spielen wollen. [1]
- Die Insel war virtuell, keine reale Umgebung. [1] [4]
- Die Agenten konnten unter anderem erkunden, springen und Objekte bewegen. [4]
- Es gab zunächst kein vorgegebenes Leistungsziel, aber einen Prompt, der Neugier als Eigenschaft vorgab. [1]
Erkundung statt vorab definierter Übung
Der Versuchsansatz unterscheidet sich von Training, bei dem ein konkretes Ziel und ein messbarer Fortschritt von Anfang an feststehen. Hier sollten die Agenten zunächst selbst entscheiden, was sie in der Umgebung ausprobieren. Die Forschenden werteten die daraus entstehenden Aktivitäten als spielerisches Erkunden. Diese Einordnung beschreibt ihr Verhalten im Versuchsrahmen; sie ist kein Nachweis für menschliche Motivation oder ein subjektives Erleben der Systeme. [1]
Fehlschläge wurden zum Ausgangspunkt neuer Versuche
Ein Beispiel aus dem Experiment ist Ekos Versuch, einen hohen Turm zu erreichen. Der erste direkte Anlauf scheiterte. Bei einem späteren Versuch legte der Agent nach einer Darstellung von all-ai.de einen Felsen auf einem benachbarten Gipfel ab, stapelte weitere Blöcke darauf und nutzte die erhöhte Position, um auf den Turm zu springen. [1] [4]
Die Inselumgebung wurde stündlich neu gestartet, während Ekos Erinnerung erhalten blieb, berichtet all-ai.de. Dadurch konnte der Agent auf frühere Versuche zurückgreifen und seinen Plan ändern. Das Beispiel verbindet drei Komponenten: eine selbst gewählte Herausforderung, wiederholte Handlung in der Simulation und gespeicherte Information über vorherige Erfahrungen. [4]
Auch ein goldener Ring wurde zum Anlass für weitere Aktivitäten. Nachdem Eko ihn beim Werfen ins Meer verloren hatte, baute er aus Steinen ein herzförmiges Denkmal. Als der Ring nach einem Neustart wieder verfügbar war, verwendete der Agent ihn laut t3n unter anderem als Basketballkorb, Zielobjekt und Accessoire. Das sind beobachtete Handlungen in der Simulation; die Beschreibung als Spiel stammt von den Forschenden beziehungsweise der Berichterstattung. [1]
- Der Turmversuch zeigt, wie ein Agent nach einem Fehlschlag eine alternative Vorgehensweise entwickelte. [1] [4]
- Die erhaltene Erinnerung erlaubte es Eko, bei späteren Versuchen an frühere Erfahrungen anzuknüpfen. [4]
- Die wechselnde Nutzung des Rings illustriert, dass Objekte in der Simulation für unterschiedliche selbst gewählte Aktivitäten eingesetzt wurden. [1]
Was hier mit Lernen gemeint ist
In der Berichterstattung wird Lernen nicht als Veränderung der Modellparameter beschrieben. Vielmehr seien die zugrunde liegenden KI-Modelle unverändert geblieben; entscheidend seien die gespeicherten Erinnerungen der Agenten gewesen. Das legt eine engere Lesart nahe: Die Agenten nutzten Erfahrungen aus der Erkundungsphase später bei Aufgaben, ohne dass in diesem Versuch ein neues Modell trainiert wurde. [4]
Sechs Agenten fanden einen unerwarteten Bewegungstrick
Eine der Entdeckungen betraf die Physik der virtuellen Umgebung. Sechs der 13 Agenten lernten, einen Block weiter nach oben zu werfen, indem sie ihn während eines Sprungs losließen. Laut den Berichten war dieser Effekt auch den Entwicklern der Simulation nicht bekannt. Die Aussage betrifft die simulierte Bewegungsmechanik und sollte nicht mit einer neuen Fähigkeit in der physischen Welt gleichgesetzt werden. [1] [4]
Der Befund ist für die Forschenden deshalb interessant, weil die Agenten nicht nur eine von Menschen vorgegebene Lösung wiederholten. Sie erkundeten Handlungsoptionen und fanden dabei einen nützlichen Effekt, der für spätere Aufgaben relevant sein könnte. Zugleich zeigt die Zahl sechs, dass diese Entdeckung nicht bei allen Agenten auftrat. Aus dem berichteten Ergebnis lässt sich daher weder ableiten, dass alle Agenten dieselbe Erkenntnis gewinnen, noch dass die Methode zuverlässig zu solchen Entdeckungen führt. [1] [4]
- Den Trick entwickelten sechs der 13 Agenten. [1] [4]
- Der Effekt wurde in der Simulation beobachtet; die Berichte beschreiben ihn nicht als Ergebnis eines Tests mit einem physischen Roboter. [1] [4]
Ein anschließender Gipfeltest deutet auf einen Transfer hin
Nach der freien Erkundungsphase erhielten erfahrene und unerfahrene Agenten konkrete Aufgaben. Ein Beispiel war, möglichst viele Objekte auf den höchsten Gipfel der Insel zu bringen. Laut all-ai.de transportierten die Agenten mit 30 Stunden Inselerfahrung dabei durchschnittlich 10,3 Objekte; die Vergleichsgruppe ohne diese Erfahrung erreichte im Mittel 3,5. [4]
t3n berichtet ebenfalls, dass die zuvor erkundenden Eko-Agenten konkrete Aufgaben in der Regel besser bewältigten als identische Agenten ohne Inselerfahrung. Das Ergebnis spricht dafür, dass Erfahrungen aus einer offenen Phase bei mindestens einem späteren Aufgabentyp nützlich waren. Es belegt jedoch nicht, dass jede Form freier Erkundung zu besseren Resultaten führt oder dass der Vorteil auf andere Aufgaben übertragen wird. [1] [4]
Die Darstellung von all-ai.de nennt vier nachfolgende konkrete Aufgaben, beschreibt aber im bereitgestellten Text nur den Gipfeltest mit Zahlen. Für die übrigen Aufgaben liegen hier keine entsprechenden Einzelwerte vor. Auch Angaben zur Streuung der Ergebnisse oder dazu, wie oft die Versuche wiederholt wurden, sind in den verfügbaren Berichten nicht enthalten. Deshalb sollte der Unterschied von 10,3 zu 3,5 als berichteter Mittelwert eines Tests gelesen werden, nicht als umfassender Leistungsnachweis. [4]
- Berichteter Mittelwert im Gipfeltest: 10,3 transportierte Objekte bei Agenten mit Inselerfahrung gegenüber 3,5 bei der Vergleichsgruppe. [4]
- Laut all-ai.de blieben die Modelle unverändert; die gespeicherten Erinnerungen waren für den Leistungsvorteil entscheidend. [4]
- Die verfügbaren Texte liefern keine Einzelresultate für alle vier Aufgaben. [4]
Bedeutung für die Entwicklung von KI-Agenten
Für Unternehmen ist die Studie vor allem als Hinweis auf einen möglichen Entwicklungsansatz relevant. Viele Agentensysteme werden auf klar abgegrenzte Aufgaben ausgerichtet. Die Forschenden stellen dem ein Modell gegenüber, bei dem ein Agent zunächst in einer vielfältigen und sicheren Umgebung selbst Erfahrungen sammelt und das daraus gewonnene Wissen später nutzt. Die Studie zeigt einen solchen Ablauf in einer Simulation; sie begründet noch keine allgemeine Empfehlung, Agenten in produktiven Systemen ohne klare Ziele handeln zu lassen. [1]
Als Analyse lässt sich daraus eine mögliche Trennung von Lern- und Ausführungsphase ableiten: Ein System könnte in einer kontrollierten Umgebung unterschiedliche Handlungen ausprobieren und anschließend mit gespeicherten Erfahrungen konkrete Aufgaben bearbeiten. Für den Unternehmenseinsatz wären jedoch zusätzliche Nachweise erforderlich, etwa ob solche Erfahrungen bei wechselnden Aufgaben tatsächlich nützen und ob sie zuverlässig genug sind. Die berichteten Zahlen aus einem Gipfeltest beantworten diese Fragen nicht. [1] [4]
Gerade die Differenz zwischen Simulation und Betrieb ist praktisch bedeutsam. Die Insel erlaubte Interaktionen mit virtuellen Objekten und eine wiederholte Erkundung. Ein Agent, der in Unternehmenssystemen auf Dateien, Postfächer oder andere Werkzeuge zugreift, kann dagegen reale Daten verändern oder externe Aktionen auslösen. Die vorliegenden Berichte untersuchen solche Einsatzrisiken nicht. Daher wäre es eine weitergehende Schlussfolgerung – nicht ein Ergebnis des Experiments –, aus freiem Erkunden unmittelbar ein geeignetes Betriebsmodell abzuleiten. [1] [4]
Robotik als mögliche Anwendung – noch kein Praxistest
Die MIT-Forschenden sehen laut t3n einen möglichen Bezug zur Robotik: Auch Roboter könnten von Erfahrungen profitieren, die sie nicht ausschließlich durch vorab definierte Übungen sammeln. Das ist eine Perspektive der Forschungsgruppe, kein im Experiment nachgewiesener Effekt an realer Hardware. Die getesteten Agenten agierten auf einer simulierten Insel. [1]
Eine Übertragung auf Roboter müsste unter anderem zeigen, dass Erkundung in einer realen Umgebung sicher und kontrollierbar bleibt und die dabei gewonnenen Erfahrungen bei späteren Aufgaben helfen. Die vorliegenden Texte berichten nicht über solche Tests. Der Übergang von virtueller Bewegung zu physischer Handlung ist deshalb eine offene Forschungsfrage, nicht eine bereits belegte Folge des Inselversuchs. [1] [4]
Was das Experiment aussagt – und was nicht
Der zentrale Befund ist begrenzt, aber konkret: Unter den beschriebenen Bedingungen entwickelten Agenten eigene Aktivitäten, einige fanden neue Wege durch die Simulation, und die Gruppe mit Erkundungserfahrung schnitt bei einem späteren Gipfeltest besser ab als eine unerfahrene Vergleichsgruppe. Die Berichte führen die Leistung nicht auf eine Veränderung des Modells, sondern auf gespeicherte Erinnerungen zurück. [1] [4]
Nicht belegt sind damit ein allgemeines Bedürfnis von KI-Systemen nach einer „Kindheit“, ein zuverlässiger Lernvorteil bei beliebigen Aufgaben oder eine direkte Übertragbarkeit auf Roboter und betriebliche Agenten. Die Forschenden verwenden die Kindheit als Analogie für einen Lernweg, bei dem nicht jede Übung vorab festgelegt wird. Ob und wann dieser Ansatz gegenüber zielgerichtetem Training Vorteile bietet, muss für andere Umgebungen und Aufgaben gesondert geprüft werden. [1] [4]
Quellen
- [1] MIT-Experiment zeigt, was passiert, wenn man KI-Agenten sich selbst überlässt — https://t3n.de/news/mit-experiment-ki-einsame-insel-1769624 (abgerufen am 2026-10-31)
- [4] MIT Studie: Das tun KI-Agenten ohne Anweisungen auf einer einsamen Insel — https://www.all-ai.de/news/news26/mit-studie-ki-angenten-einsame-insel (abgerufen am 2026-10-31)
//Nächster Artikel
Anthropic
Claude-Agent steuert Genbehandlung im Mausversuch – unter menschlicher AufsichtEin Claude-Agent soll Therapie und Zielregion für einen Mausversuch gewählt und die Injektion gesteuert haben. Wirksamkeit und unabhängige Prüfung fehlen.
// Artikel teilen
Mehr zu KI-Agenten
Alle KI-Agenten-News- OpenAI schärft Verhaltensregeln für Modelle und autonome Agenten
OpenAI ergänzt den Model Spec um fünf Verhaltenswerte und Regeln für autonome Agenten. Die Vorgaben sind ein Ziel, kein Nachweis verlässlicher Umsetzung.
- Microsoft zugeschriebenes 4B-Agentenmodell: Leistungsangaben bleiben vorläufig
Ein Social-Media-Post nennt 66 Prozent auf OSWorld-Verified für Mage-VL-Cowork. Benchmarkdetails und unabhängige Bestätigung fehlen.
- DynaFlow lässt KI-Agenten ihre Zusammenarbeit selbst planen
DynaFlow trainiert einen Hauptagenten zur flexiblen Orchestrierung fester KI-Agenten. Die Studie meldet 88,08 Prozent Genauigkeit auf sechs Benchmarks.
- Oracle will Fusion-Prozesse über ChatGPT und Agenten ausführen lassen
Oracle plant, Fusion-Aufgaben über ChatGPT und eine eigene KI-Oberfläche zu steuern. Was zu Agenten, Freigaben, Verfügbarkeit und Kosten bekannt ist. [S1][S4]
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.