
HybridAgents verbinden latentes Schlussfolgern mit textbasierter Tool-Nutzung
Mindverse News
KI-gestützt erstellt 2 Quellen Originalmeldung: arxiv.org Arbeitsweise
Das Wichtigste in Kürze
- Ein am 13. Oktober 2026 eingereichtes arXiv-Preprint beschreibt HybridAgents, die zwischen latenter Verarbeitung und textbasierter Interaktion wechseln. [1][2]
- Das System nutzt einen Adapter namens HybridLink für den Übergang zwischen kontinuierlichen Zuständen und Texteingaben; Werkzeugaufrufe bleiben textbasiert. [2]
- Die Autoren berichten Tests mit drei Modellgrößen auf elf Benchmarks sowie durchschnittlich 10,4 Prozent mehr Leistung und geringeren Tokenverbrauch. [1][2]
- Die Zahlen sind Ergebnisse der Studienautoren, keine unabhängige Bestätigung; die vorliegenden Quellen dokumentieren weder externe Replikationen noch einen Produktivbetrieb. [1][2]
// Inhalt · 7 Abschnitte
- Ein Agent soll intern anders arbeiten als er nach außen kommuniziert
- HybridLink vermittelt zwischen Modellzustand und Texteingabe
- Ein gemeinsamer Speicher soll den Kontext über mehrere Schritte erhalten
- HybridSFT und HybridRL sollen die Moduswahl trainieren
- Die Autoren berichten Effizienzgewinne auf elf Benchmarks
- Lesbare latente Zustände sind nicht automatisch ein vollständiges Auditprotokoll
- Der Forschungsbefund bleibt vor einer Übertragung in den Betrieb zu prüfen
- Quellen
Ein Agent soll intern anders arbeiten als er nach außen kommuniziert
Viele Sprachmodell-Agenten verwenden Text sowohl für ihre internen Zwischenschritte als auch für die Kommunikation mit Werkzeugen. Das erleichtert die Interaktion mit Suchsystemen, Programmierumgebungen oder anderen externen Diensten, bedeutet aber auch, dass jeder ausgegebene Zwischenschritt zunächst in einzelne Texttokens übersetzt wird. Latente Verfahren verfolgen den Gegenweg: Sie führen Berechnungen direkt in den kontinuierlichen Repräsentationen eines Modells aus, ohne jede interne Operation als Text auszugeben. Nach Darstellung der Autoren fehlt solchen Verfahren bislang jedoch häufig ein direkter Weg zu Werkzeugen, und ihre internen Zustände lassen sich schwerer nachvollziehen. [2]
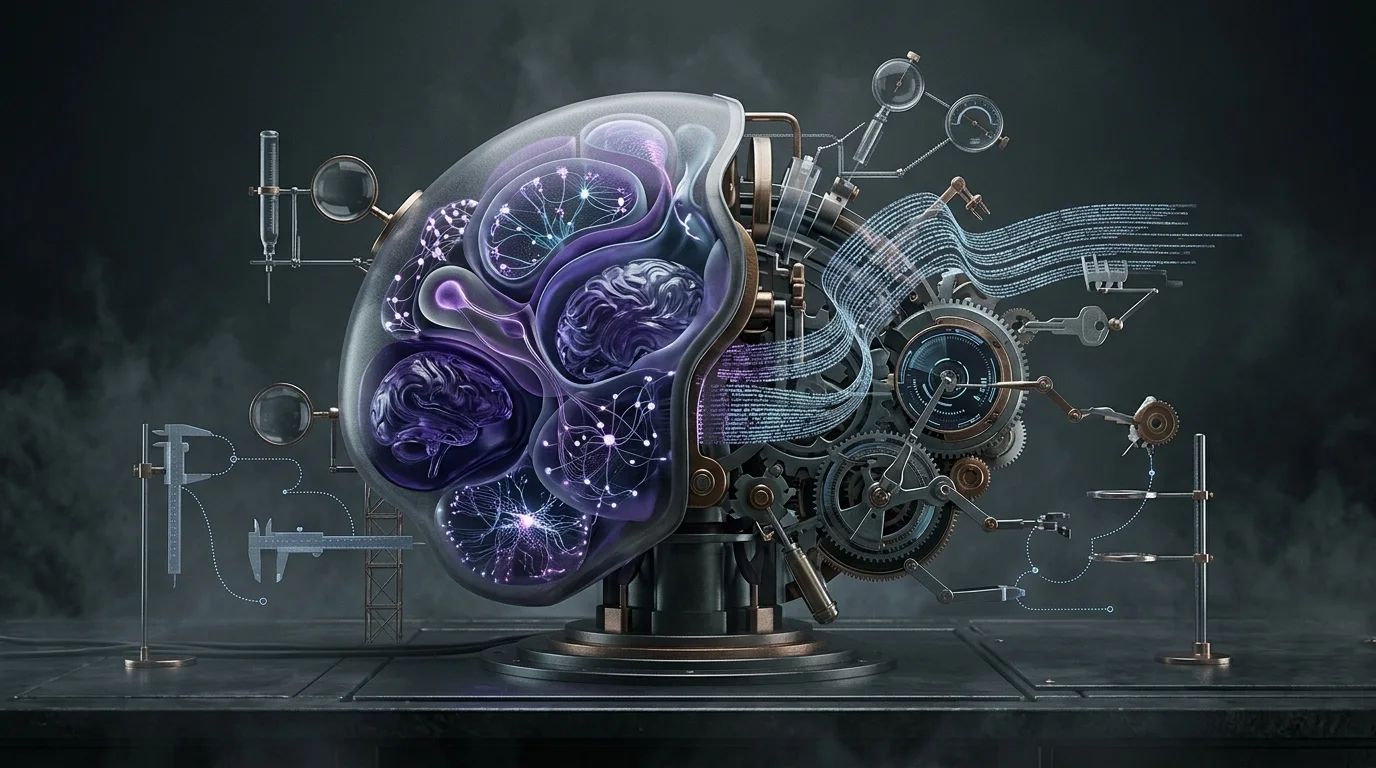
Ein am 13. Oktober 2026 bei arXiv eingereichtes Preprint von Jiaru Zou und sieben Mitautoren schlägt dafür Hybrid Reasoning Agents, kurz HybridAgents, vor. Der Agent soll während einer zusammenhängenden Generierung zwischen latentem Schlussfolgern und Text wechseln: Er verarbeitet Teile einer Aufgabe intern in kontinuierlichen Repräsentationen und kehrt für Werkzeugaufrufe sowie die Kommunikation mit der Umgebung zum Textmodus zurück. Die Arbeit beschreibt damit einen Forschungsansatz, nicht den Nachweis eines verfügbaren Unternehmensprodukts. [1][2]
Die zentrale Designfrage lautet, wie beide Modi innerhalb eines Agenten zusammenarbeiten können, ohne den Anschluss an bestehende textbasierte Werkzeug-Schnittstellen zu verlieren. Die Autoren untersuchen dafür sowohl die Modellarchitektur als auch Verfahren zum nachträglichen Training. Ihre Ergebnisse sind als Aussagen des Preprints zu lesen; die bereitgestellten Quellen enthalten keine unabhängige Replikation. [1][2]
HybridLink vermittelt zwischen Modellzustand und Texteingabe
Im Zentrum steht HybridLink, ein leichter Adapter, der den letzten verborgenen Zustand eines Sprachmodells in eine Repräsentation für den nächsten Verarbeitungsschritt überführt. Im Textmodus erzeugt das System wie ein gewöhnliches Sprachmodell ein Token aus seinem Vokabular. Ein besonderes Starttoken signalisiert den Wechsel in den latenten Modus. Dort wird der Modellzustand über HybridLink weitergereicht, anstatt zunächst in ein Texttoken umgewandelt und danach wieder eingebettet zu werden. [2]
Der Übergang zurück zum Textmodus wird laut Arbeit ebenfalls über das Vokabular gesteuert: Das System vergleicht die veränderte latente Repräsentation mit den Einbettungen möglicher Tokens. Passt das nächstliegende Token zum vorgesehenen Endanker, endet die latente Phase und die Generierung läuft textbasiert weiter. Wie lange und wie oft der Agent latent arbeitet, soll sich dynamisch aus der Generierung ergeben, statt durch festgelegte Abschnitte vorgegeben zu sein. [2]
Der Adapter verwendet eine Residualstruktur, die einen Teil des vorhandenen Modellzustands erhält und ihn mit einer gelernten Projektion ergänzt. Die Autoren beziffern seinen Umfang auf ungefähr das Doppelte des Quadrats der verborgenen Dimension; für ein Modell mit vier Milliarden Parametern nennen sie rund zehn Millionen zusätzliche Parameter. Das ist eine Größenangabe für den Adapter und kein Maß für den gesamten zusätzlichen Rechenaufwand eines Systems. [2]
Latente Verarbeitung bedeutet in diesem Aufbau nicht, dass der Agent grundsätzlich ohne Sprache mit seiner Umgebung kommuniziert. Text bleibt die Schnittstelle für externe Aktionen; der Unterschied betrifft vor allem die internen Zwischenschritte. Das erhält konzeptionell den Anschluss an textbasierte Werkzeuge, während die interne Berechnung nicht in jedem Schritt als regulärer Text ausgegeben werden muss. [2]
Ein gemeinsamer Speicher soll den Kontext über mehrere Schritte erhalten
Für mehrstufige Aufgaben reicht es nicht, zwischen Text und latenten Zuständen zu wechseln. Ein Agent muss nach einem Werkzeugaufruf auch die vorherigen Eingaben, internen Verarbeitungsschritte und zurückgegebenen Beobachtungen berücksichtigen können. HybridAgents verwenden dafür nach Darstellung der Autoren einen kontinuierlichen Arbeitsspeicher, der die Key- und Value-Einträge des Transformer-Modells aus Text, latenten Zuständen und Werkzeugbeobachtungen zusammenführt. Bei späteren Generierungsschritten wird dieser Speicher fortgeschrieben. [2]
Der Ansatz soll vermeiden, eine gemischte Verarbeitungshistorie für jeden neuen Schritt vollständig in Text zurückübersetzen zu müssen. Die Autoren beschreiben, dass der Arbeitsspeicher den hybriden Kontext über mehrere Gesprächs- beziehungsweise Aktionsrunden hinweg vollständig erhält. Das ist eine Eigenschaft der vorgeschlagenen Architektur und der formalen Analyse im Preprint, nicht bereits ein Nachweis, dass lange oder besonders komplexe Abläufe in jeder Einsatzumgebung zuverlässig funktionieren. [2]
Für Unternehmen wäre diese Unterscheidung relevant, weil mehrstufige Agenten nicht nur Antworten formulieren, sondern wiederholt externe Systeme abfragen und deren Rückmeldungen verarbeiten. Der vorgeschlagene Speicher soll die interne Kontinuität dieser Abläufe sichern, während die Werkzeuginteraktion in Textform bleibt. Wie sich Speicherbedarf, Antwortlatenz und Betriebskosten bei konkreten Unternehmenslasten entwickeln, lässt sich aus den zusammenfassenden Angaben jedoch nicht allgemein ableiten. [2]
HybridSFT und HybridRL sollen die Moduswahl trainieren
Die Autoren belassen die Architektur des zugrunde liegenden Sprachmodells grundsätzlich bestehen und passen das nachgelagerte Training an. In einer überwachten Trainingsphase namens HybridSFT soll das Modell zunächst lernen, die besonderen Start- und Endmarker für latente Abschnitte zuverlässig zu verwenden und mit HybridLink zu koordinieren. Laut Arbeit werden dafür textbasierte Agentendaten in hybride Verläufe überführt; ausgewählte Schritte sollen latent verarbeitet werden, während wichtige Stellen für Werkzeuginteraktionen und externe Prüfung im Textmodus verbleiben. [2]
Ein Problem dabei ist die Abweichung zwischen Trainings- und Einsatzbedingungen: Im Betrieb verarbeitet das Modell seine eigenen vorherigen Zustände, die nicht zwingend den idealisierten Zielzuständen aus den Trainingsdaten entsprechen. Das Preprint beschreibt deshalb zusätzlich selbstkonditioniertes Training, bei dem das Modell auch mit eigenen Vorhersagen arbeitet. Die Autoren ordnen HybridSFT die Stabilisierung der hybriden Generierung zu. [2]
Darauf baut HybridRL auf. In dieser Phase soll der Agent lernen, wann er intern latent weiterarbeitet und wann er für eine Aktion oder Interaktion in den Textmodus wechselt. Die Arbeit nennt dafür eine Zerlegung der hybriden Policy und eine exakte Wiedergabe des während eines Durchlaufs entstandenen Kontexts. Der bereitgestellte Abstract beschreibt die Funktion des Verfahrens, aber nicht genügend Einzelheiten, um seine Implementierung oder den Trainingsaufwand unabhängig zu beurteilen. [1][2]
Für die praktische Einordnung ist wichtig, dass eine angepasste Trainingspipeline vorausgesetzt wird. Der Vorschlag ist daher nicht gleichbedeutend mit einem Schalter, den ein Unternehmen ohne weitere technische Arbeit an ein beliebiges Sprachmodell anlegt. Die Autoren schreiben zwar, dass kein erneutes Vortraining des Backbones von Grund auf erforderlich sei; das Preprint beschreibt aber weiterhin zusätzliche Datenaufbereitung und zwei spezialisierte Trainingsphasen. [2]
Die Autoren berichten Effizienzgewinne auf elf Benchmarks
Für die Evaluation trainierten die Forschenden HybridAgent-Varianten mit Qwen3-Base-Modellen in drei Größen: vier, acht und 14 Milliarden Parametern. Die elf Benchmarks deckten Mathematik, Naturwissenschaften, Medizin, wissensintensive Suche und agentisches Schlussfolgern ab. Als Vergleich nennt das Preprint sowohl leistungsfähige Sprachmodell-Agenten als auch agentische Ansätze mit textbasierter oder latenter Verarbeitung. [2]
Über diese Tests hinweg berichten die Autoren eine durchschnittliche Leistungsverbesserung von 10,4 Prozent. Zudem soll HybridAgent den Tokenverbrauch um 35,5 bis 54,7 Prozent senken, die Inferenz um den Faktor 1,8 bis 2,6 beschleunigen und die Rechenkosten um den Faktor 2,7 bis 3,7 reduzieren. Diese Werte stammen aus dem Abstract und der Darstellung der Studienautoren; sie sind keine Garantie für vergleichbare Verbesserungen bei anderen Modellen, Aufgaben oder Infrastrukturen. [1][2]
Die Ergebnisse deuten nach Interpretation der Autoren darauf hin, dass sich ein Teil der internen Verarbeitung in den latenten Modus verlagern lässt, während Text für die Interaktion nach außen reserviert bleibt. Weniger ausgegebene Tokens allein belegen allerdings nicht, dass ein produktives System stets weniger Rechenressourcen oder Gesamtkosten benötigt. Dafür müssten Unternehmen unter anderem Modell, Hardware, Lastprofil, Werkzeugnutzung und die jeweilige Kostenrechnung berücksichtigen. Die bereitgestellten Zusammenfassungen erlauben keine allgemeingültige Übertragung der berichteten Faktoren auf solche Einsatzbedingungen. [1][2]
Lesbare latente Zustände sind nicht automatisch ein vollständiges Auditprotokoll
Ein besonderes Versprechen des Ansatzes betrifft die Nachvollziehbarkeit. Die Autoren schreiben, dass latente Schritte über die jeweils nächstliegende Token-Einbettung in pseudo-textuelle Form gebracht werden können. Sie bezeichnen diese Darstellungen als lesbar und kontextbezogen. Damit soll ein interner Zustand prüfbar werden, ohne dass das Modell ihn während der Berechnung regulär als Text erzeugen muss. [2]
Für die Bewertung dieses Anspruchs ist die Einschränkung entscheidend: Eine nachträgliche Darstellung anhand nächstliegender Token ist nicht automatisch identisch mit einer vollständigen oder verlässlichen Erklärung dafür, warum das Modell eine Entscheidung getroffen hat. Das Preprint beschreibt einen Weg, latente Zustände zu inspizieren; aus den bereitgestellten Texten folgt nicht, dass diese Darstellung für jeden Fehlerfall vollständig ist oder sich als Prüfprotokoll für regulatorische Anforderungen eignet. [2]
Die externe Interaktion bleibt nach der beschriebenen Architektur textbasiert. Werkzeugaufrufe und Werkzeugantworten lassen sich dadurch grundsätzlich in einem Textverlauf erfassen, während interne latente Schritte separat behandelt werden. Für ein Unternehmen könnte das die Trennung zwischen interner Modellverarbeitung und sichtbaren Aktionen erleichtern. Ob diese Trennung die Anforderungen an Protokollierung, Datenschutz und Kontrolle erfüllt, hängt jedoch von der konkreten Implementierung und dem jeweiligen Einsatzfall ab. Das ist eine betriebliche Analyse der beschriebenen Architektur, keine im Preprint nachgewiesene Compliance-Eigenschaft. [2]
Der Forschungsbefund bleibt vor einer Übertragung in den Betrieb zu prüfen
Für eine B2B-Einordnung sind die Effizienzzahlen interessant, aber nicht isoliert zu betrachten. Ein Unternehmen müsste die Lösung mit den eigenen Aufgaben und Vergleichssystemen testen: etwa mit denselben Werkzeugen, Sicherheitsvorgaben und Anforderungen an Antwortqualität. Besonders relevant wäre, ob der geringere Tokenverbrauch tatsächlich zu geringeren Gesamtkosten führt, wie die Leistung auf unternehmensspezifischen Daten ausfällt und ob die latenten Zustände ausreichend kontrollierbar sind. Diese Prüfungen folgen aus den beschriebenen Eigenschaften; die Quellen berichten keine Ergebnisse für konkrete Unternehmensdeployments. [1][2]
Auch der Evidenzstatus begrenzt die Aussagekraft. Der arXiv-Eintrag führt die Arbeit als Version 1, eingereicht am 13. Oktober 2026. Die vorliegenden Quellen weisen keine unabhängige Replikation der Resultate aus. Das macht die berichteten Messwerte nicht bedeutungslos, ordnet sie aber als Ergebnisse eines einzelnen Forschungsbeitrags ein und nicht als bereits breit bestätigte Leistungsmerkmale. [1][2]
HybridAgents verbinden damit zwei bislang oft getrennt behandelte Ansätze: kontinuierliche interne Verarbeitung und textbasierte Aktionen nach außen. Der Beitrag liegt in einer Architektur, die diese Modi innerhalb eines Agenten zusammenführt, einem fortgeschriebenen Speicher für mehrstufige Abläufe und speziell angepasstem Training. Ob die berichteten Vorteile in Produktionsumgebungen Bestand haben, muss sich in unabhängigen Tests und unter realistischen Betriebsbedingungen zeigen. [1][2]
Quellen
- [1] [2610.18861v1] Hybrid Reasoning Agents — https://arxiv.org/abs/2610.18861v1 (abgerufen am 2026-10-19)
- [2] Hybrid Reasoning Agents — https://arxiv.org/html/2610.18861v1 (abgerufen am 2026-10-19)
//Nächster Artikel
KI-Agenten
Dream2Discern sucht gezielt nach Schwächen in der Fehlerprognose von Multi-AgentenDream2Discern prognostiziert Ausfälle in Multi-Agenten-Systemen aus laufenden Interaktionen. Der Preprint trainiert Auditoren mit verlustgesteuerten Varianten.
// Artikel teilen
Mehr zu KI-Agenten
Alle KI-Agenten-News- OfficeTown simuliert Organisationen als Trainingsumgebungen für KI-Agenten
OfficeTown bündelt simulierte Organisationen zu einem Benchmark mit 406 Aufgaben. Die Autoren berichten Trainingsgewinne, nennen im Abstract aber keine Zahlen.
- Benchmark zeigt Schwächen von KI-Agenten bei wissenschaftlichen Schlüsselentscheidungen
Ein Benchmark aus 248 Forschungsentscheidungen zeigt Schwächen von KI-Agenten bei wissenschaftlicher Planung – und Grenzen der Aussagekraft.
- Studie: Coding-Agenten profitieren stärker von vollständigen Quelldateien als von Textkompression
Eine Studie vergleicht Kontextmethoden für Coding-Agenten: Die Auswahl vollständiger Dateien erzielt auf 300 SWE-rebench-Aufgaben höhere Erfolgsquoten.
- OS-Helix trainiert Desktop-Agenten für den Wechsel zwischen Oberfläche und Code
OS-Helix verbindet GUI-Aktionen und Codeausführung. Die Autoren berichten 66,44 Prozent Erfolg auf OSWorld-Verified; Einordnung und Grenzen im Überblick.
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
- Die KI-Plattform für UnternehmenRollen, Freigaben und Abrechnung für den KI-Einsatz im ganzen Unternehmen.
- KI-Chat mit allen führenden ModellenGPT, Claude und Gemini in einer Oberfläche — mit Websuche und Quellenangaben.
- Eigene Modelle und Assistenten trainierenBilden Sie einen digitalen Marken-Experten auf Ihrem Wissen aus.
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
//Chronik