
Continual-ARC: Notizen helfen KI-Agenten wenig, Gewichtsupdates eher
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 5 Quellen
Das Wichtigste in Kürze
- Der von Unify entwickelte Benchmark lässt ARC-Aufgaben mit neuen Eingaben wiederkehren und misst getrennt, ob Systeme Bekanntes behalten und auf ungesehene Aufgaben übertragen.
- Die meisten getesteten Agenten-Harnesses verbesserten ihre Leistung durch gespeicherte Notizen kaum; einfaches Zwischenspeichern von Demonstrationen war oft wirksamer.
- Ein Qwen-Modell, das mit DAgger das Verhalten von GLM-5.3 Flash imitierte, benötigte laut den Autoren bei 100 ungesehenen Aufgaben 29 Prozent weniger Feedbackbudget als seine untrainierte Variante.
- In einem Mehrnutzer-Experiment erzielten trainierte Gewichte auch bei zwei und vier gleichzeitig versorgten Nutzern Einsparungen auf ungesehenen Aufgaben.
- Die Ergebnisse stammen überwiegend aus abstrakten ARC-Puzzles und sind keine Messung von Produktivität oder Kosten in realen Unternehmensabläufen.
Inhalt · 7 Abschnitte
- Ein Benchmark für Lernen über mehrere Einsätze
- Wie der Test Lernen von bloßem Erinnern trennt
- Der Vergleich setzt externe Notizen gegen trainierte Gewichte
- Persistenz allein bringt in den Tests wenig
- Mehr Nutzer vergrößern den Trainingsstrom
- Was die Ergebnisse für Unternehmen aussagen – und was nicht
- Reichweite und Nachprüfbarkeit bleiben begrenzt
- Quellen
Ein Benchmark für Lernen über mehrere Einsätze
Agenten können zwischen Aufgaben externe Notizen, Dateien oder Werkzeuge nutzen. Ob sie damit tatsächlich Fähigkeiten aus früheren Einsätzen behalten, ist jedoch eine andere Frage als die, ob ein Modell eine einzelne Aufgabe lösen kann. Das von Unify entwickelte Continual-ARC soll diesen Unterschied messbar machen: Es lässt Aufgaben wiederkehren, verändert dabei aber die konkreten Eingaben. Zusätzlich vergleicht es Systeme, die Informationen in einem Agenten-Harness speichern, mit einem Ansatz, der Modellgewichte trainiert. [1][3][4]
Das Papier von Daniel Lenton, Yusha Arif und Haris Mahmood wurde am 10. November 2026 bei arXiv eingereicht und am Folgetag überarbeitet. Die Ergebnisse sind damit ein aktueller Forschungsbeitrag, keine unabhängige Bestätigung der Leistungsfähigkeit eines Produkts. Die auf Hugging Face veröffentlichte Paper-Seite fasst die zentralen Befunde zusammen; die ausführlichere Fassung beschreibt außerdem eine Mehrnutzer-Auswertung. [1][3][4]
Wie der Test Lernen von bloßem Erinnern trennt
Continual-ARC verwendet Aufgaben aus den drei Ausgaben des Abstraction and Reasoning Corpus (ARC-AGI). Dabei muss ein System die Regel hinter einem Rasterrätsel anhand von Beispielen erschließen und auf ein neues Raster anwenden. Im hauptsächlich ausgewerteten ARC-AGI-1-Durchlauf wählt der Benchmark 25 Aufgaben aus dem Trainingsbestand aus und stellt insgesamt 200 neue Instanzen bereit. Eine Aufgabe kann nach einer Pause zurückkehren; ihre Eingabe ist dann frisch erzeugt, sodass eine zuvor gespeicherte Musterlösung nicht einfach wiederverwendet werden kann. [4][7]
Für jede Instanz kann das System zusätzliche Beispiele anfordern oder eine Antwort einreichen. Eine Demonstration und ein falscher Versuch kosten jeweils eine Budgeteinheit; pro Instanz sind höchstens acht Demonstrationen und acht Fehlversuche möglich. Wird eine Aufgabe nicht gelöst, wird das gesamte Budget von 16 Einheiten angesetzt. Der Benchmark misst den Anteil dieses Feedbackbudgets, den ein System verbraucht, und berichtet daneben die Lösungsquote. Das Budget ist eine experimentelle Kennzahl, kein Geldbetrag und keine direkte Schätzung betrieblicher Kosten. [4][7]
Nach dem Aufgabenstrom wird der Lernzustand eingefroren. Ein Test mit neuen Instanzen der zuvor gesehenen Aufgaben soll zeigen, ob das System deren Regeln behalten hat. Ein zweiter Test verwendet 100 Aufgaben, die im Strom nicht vorkamen, und prüft den Transfer auf Neues. Für die Einordnung vergleichen die Autoren die Ergebnisse mit einem Reset-Lauf desselben Systems, dessen Zustand vor jeder Instanz gelöscht wird. So soll der bereits vorhandene Leistungsstand von dem getrennt werden, was während des Aufgabenstroms dazukommt. [4]
Der Vergleich setzt externe Notizen gegen trainierte Gewichte
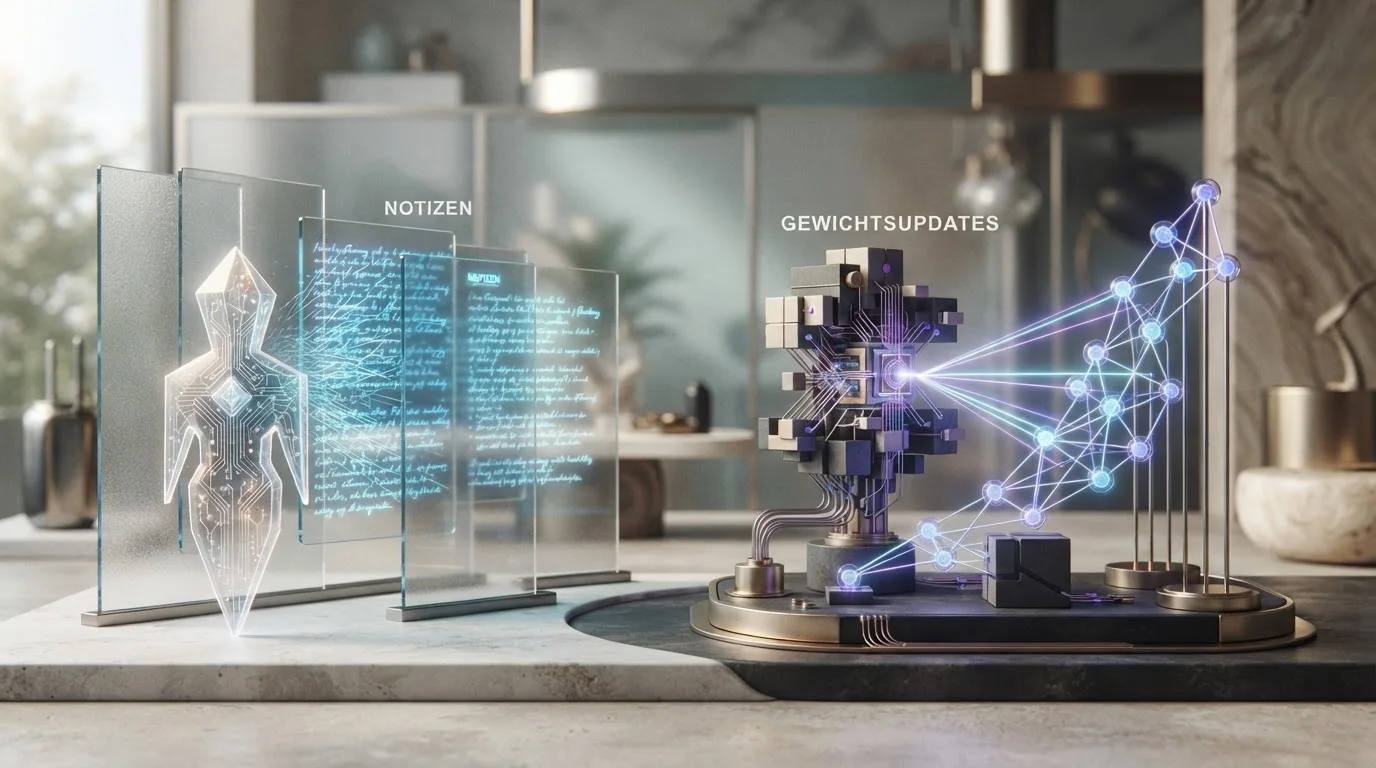
Ein Agenten-Harness ist die Softwareumgebung, die ein Modell etwa mit Werkzeugen und einem persistenten Speicher verbindet. In einem solchen Aufbau bleiben die Gewichte des getesteten Modells unverändert; das System kann jedoch Informationen außerhalb des Modells festhalten und bei späteren Aufgaben wieder nutzen. Beim alternativen Ansatz werden die Modellgewichte angepasst. Continual-ARC stellt beide Varianten denselben Aufgaben und Bewertungsregeln gegenüber. [1][4][7]
In den zentralen Versuchen liefen Harness-Ansätze mit eingefrorenen Gewichten unter anderem mit Qwen3.5-9B und GLM-5.3 Flash. Verglichen wurden sie mit einfachen Referenzen, darunter ein Ansatz, der Demonstrationen zwischenspeichert, sowie mit einer Methode zur Programmsynthese. Daneben trainierten die Autoren Qwen3.5-9B darauf, das Verhalten von GLM-5.3 Flash nachzuahmen. Die Studie untersucht damit nicht nur, ob ein Agent etwas speichert, sondern auch, wo das Gelernte abgelegt wird und ob es bei einer anderen Aufgabe hilft. [1][4]
Persistenz allein bringt in den Tests wenig
Der zentrale Befund der Autoren: Ein persistenter Harness verbesserte das Behalten bekannter Aufgaben im Allgemeinen nicht verlässlich. Die Ergebnisse änderten sich, wenn das System ausdrücklich angeleitet wurde, welche Informationen es speichern sollte. Zugleich schnitten die meisten getesteten Harness-Methoden beim Lernen über wiederkehrende Aufgaben hinweg schlechter ab als eine einfache Referenz, die lediglich Demonstrationen je Aufgabe ablegt. [1][3][4]
Das ist kein Nachweis, dass externe Speicher grundsätzlich nutzlos sind. Die Studie zeigt vielmehr eine Lücke zwischen vorhandener Speicherfunktion und wirksamer Nutzung: Ein System muss relevante Informationen auswählen, passend ablegen und später im richtigen Kontext heranziehen. In den Experimenten half gezielte Anleitung beim Memorieren; daraus folgt aber noch nicht, dass ein solcher Ablauf auf andere Aufgaben oder Produktionsumgebungen übertragbar ist. [1][4]
Für ungesehene Aufgaben berichten die Autoren keinen messbaren Vorteil der Harness-basierten Verfahren. Anders fiel das Ergebnis für das trainierte Modell aus: Qwen3.5-9B, das mit DAgger das Verhalten von GLM-5.3 Flash imitierte, verbrauchte laut einem Kommentar des Erstautors 29 Prozent weniger Budget als seine untrainierte Variante bei 100 zuvor nicht gesehenen Aufgaben. Der Wert ist ein Studienergebnis für diesen Versuchsaufbau, keine allgemeine Prognose für andere Modelle oder Arbeitsaufgaben. [1][4]
Mehr Nutzer vergrößern den Trainingsstrom
Die ausführliche Arbeit ergänzt einen kollektiven Versuchsmodus: Ein System lernt aus Aufgaben mehrerer Nutzer, die jeweils eigene, nicht überlappende Aufgaben erhalten. Die Nutzer teilen dabei einen gemeinsamen Zustand, sowohl bei gespeicherten Harness-Informationen als auch bei trainierten Modellgewichten. Die Autoren untersuchen Konfigurationen mit bis zu vier Nutzern. [4][7]
Auf der Projektseite berichten sie für ein Qwen-Modell, das mit DAgger und Expertenhinweisen trainiert wurde, auch bei ungesehenen Aufgaben Verbesserungen gegenüber dem zurückgesetzten Modell. Bei zwei Nutzern stieg die Lösungsquote im Held-out-Test von 18,4 auf 62,3 Prozent; der ausgewiesene Anteil des eingesparten Budgets lag bei 0,40. Bei vier Nutzern stieg die Lösungsquote von 17,8 auf 62,5 Prozent, bei einem ausgewiesenen Budgetanteil von 0,39. Die Projektseite nennt dazu Unsicherheitsintervalle; diese Messwerte beziehen sich auf die konkrete Kombination aus Modell, Lernverfahren und Benchmark. [7]
Die Auswertung macht eine mögliche Dynamik sichtbar: Mehr getrennte Aufgaben können dem trainierten Modell ein breiteres Erfahrungsspektrum liefern. Sie belegt jedoch nicht, dass der Nutzen in einem Unternehmen mit unterschiedlichen Nutzern automatisch ähnlich ausfällt. Im ARC-Test teilen alle Beteiligten einen kontrollierten Benchmark-Zustand; reale Systeme müssen zusätzlich mit abweichenden Daten, Zugriffsrechten und Arbeitsabläufen umgehen. Letzteres ist eine Einordnung der Übertragbarkeit, kein Ergebnis des Experiments. [4][7]
Was die Ergebnisse für Unternehmen aussagen – und was nicht
Für Unternehmen ist der Befund vor allem als Unterscheidung zwischen Speicher und Lernen relevant. Dass ein Agent frühere Interaktionen in Dateien oder Notizen ablegt, belegt für sich genommen nicht, dass seine Leistung bei der nächsten passenden Aufgabe steigt. Continual-ARC verlangt dafür einen Vergleich mit einem zurückgesetzten System und prüft sowohl erneute Aufgaben als auch ungesehene Fälle. [4][7]
Die Kostenkennzahl darf dabei nicht mit einer betriebswirtschaftlichen Kennzahl verwechselt werden. Der Benchmark zählt angeforderte Beispiele und falsche Antworten in einem künstlichen Feedbackbudget; er misst weder Personalzeit noch Rechenkosten, Fehlerfolgen oder Produktivität in einem Geschäftsprozess. Auch die Aufgaben selbst sind abstrakte Rasterrätsel und keine Tests in Softwareentwicklung, Kundenservice oder Wissensarbeit. Entsprechende Aussagen über Produktivsysteme lassen sich aus den vorliegenden Resultaten deshalb nicht ableiten. [4][7]
Für die technische Bewertung spricht die Studie dafür, Speicherqualität und Speicherabruf getrennt von einer Anpassung der Modellparameter zu messen. Sie liefert aber keinen Nachweis, dass Gewichtsupdates für jedes Unternehmen überlegen sind: Das berichtete Transferergebnis beruht auf einem spezifischen Schüler-Lehrer-Aufbau mit Qwen3.5-9B und GLM-5.3 Flash. Die Autoren selbst benennen die Beschränkung auf einen Aufgabenbereich und relativ kleine Modelle als offene Grenze. [1][4]
Reichweite und Nachprüfbarkeit bleiben begrenzt
Der größte Teil der detaillierten Ergebnisse bezieht sich auf ARC-AGI-1. Continual-ARC sieht zwar auch eigene Teststrecken für ARC-AGI-2 und ARC-AGI-3 vor, doch die Projektseite kennzeichnet die dort verfügbaren ersten Läufe als begrenzte beziehungsweise frühe Ergebnisse. Die Autoren weisen außerdem darauf hin, dass die drei ARC-Ausgaben unterschiedliche Schwierigkeitsgrade haben. Die zentralen Schlussfolgerungen sollten daher nicht als gleichmäßig für alle drei Strecken belegt gelesen werden. [4][7]
Unify stellt den Benchmark und Code öffentlich bereit; das Repository dokumentiert außerdem zahlreiche Laufprotokolle. Es weist zugleich darauf hin, dass für bestimmte Auswertungen nicht alle Gesprächs- und Testprotokolle vorliegen. Die Materialien erhöhen damit die Möglichkeit zur technischen Prüfung, ersetzen aber keine unabhängige Replikation. In den vorliegenden Quellen ist eine solche unabhängige Wiederholung nicht dokumentiert. [3][7][8]
Continual-ARC verschiebt die Bewertungsfrage damit von der einmaligen Lösungsquote hin zu einer längeren Lernstrecke: Was bleibt nach einer Pause erhalten, und was verbessert sich bei einer neuen Aufgabe? Die bisherigen Resultate sprechen dafür, diese beiden Fähigkeiten getrennt zu prüfen. Sie zeigen zugleich, dass ein vorhandener Langzeitspeicher noch kein Beleg für wirksames Lernen ist – und dass die beobachteten Vorteile trainierter Gewichte zunächst innerhalb des eng umrissenen Versuchsrahmens gelten. [1][4][7]
Quellen
- [1] Paper page - Continual-ARC: Measuring Skill Acquisition over a Working Lifetime — https://huggingface.co/papers/2611.14505 (abgerufen am 2026-11-16)
- [3] [2611.14505] Continual-ARC: Measuring Skill Acquisition over a Working Lifetime — https://unify.ai/papers/continual-arc.pdf (abgerufen am 2026-11-16)
- [4] Continual-ARC: Measuring Skill Acquisition over a Working Lifetime — https://arxiv.org/html/2611.14505v2 (abgerufen am 2026-11-16)
- [7] Continual-ARC — https://continual-arc.unify.ai/ (abgerufen am 2026-11-16)
- [8] continual-arc/runs/README.md at main · unifyai/continual-arc · GitHub — https://github.com/unifyai/continual-arc/blob/main/runs/README.md (abgerufen am 2026-11-16)
Nächster Artikel
KI-Agenten
Spielagent Gamer: Hohe Erfolgsquote in Honkai: Star Rail bleibt unbelegtEin Post schreibt miHoYos Spielagent Gamer über 95 Prozent Erfolg in Honkai: Star Rail zu. Testdaten und Methodik fehlen in den vorliegenden Belegen.
Artikel teilen
Mehr zu KI-Agenten
Alle KI-Agenten-News- ScrapeBench prüft, ob KI-Agenten Website-Sperren beim Abruf beachten
ScrapeBench misst, ob KI-Agenten beim Website-Scraping Nutzungsbedingungen und robots.txt beachten – und zeigt niedrige Compliance sowie Überverweigerung.
- OpenHands verbindet Coding-Agenten mit Browser, Laufzeitumgebung und Evaluation
OpenHands bündelt Codeausführung, Terminal, Browser und Agenten-Evaluation. Was die ICLR-Arbeit belegt – und wo Sicherheits- und Benchmarkfragen offenbleiben.
- AutoVend testet KI-Agenten im langfristigen Automatenbetrieb
Der Benchmark AutoVend prüft LLM-Agenten im Betrieb von 20 Automaten. Vier von fünf getesteten Systemen blieben hinter einer regelbasierten Kontrolle.
- Meta positioniert Muse Ember als Ausführungsmodell für agentische Arbeitsabläufe
Meta meldet Muse Ember für Muse Code und die Meta Model API. Welche Aufgaben das Modell übernehmen soll und was Unternehmen vor dem Einsatz prüfen müssen.
Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
- Dokumente und Daten analysierenAuswerten, vergleichen und Abweichungen automatisch erkennen.
- Eigene Modelle und Assistenten trainierenBilden Sie einen digitalen Marken-Experten auf Ihrem Wissen aus.
- Die KI-Plattform für UnternehmenRollen, Freigaben und Abrechnung für den KI-Einsatz im ganzen Unternehmen.
Recherchieren Sie KI-News wie diese selbst – mit Mindverse Studio.
7 Tage kostenlos testen – ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.