
AgentBaton untersucht den Modellwechsel in langen KI-Agenten-Aufgaben
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 4 Quellen
Das Wichtigste in Kürze
- Die Studie untersucht, ob ein effizienteres Modell eine laufende Agenten-Aufgabe übernehmen kann, ohne dass die Erfolgsquote deutlich sinkt.
- Laut den Autoren funktioniert ein einmaliger Wechsel vom leistungsfähigeren zum effizienteren Modell meist besser als die umgekehrte Reihenfolge. [2]
- Über elf Modellpaare und zwei Benchmarks hinweg berichtet das Team von durchschnittlich 65,9 Prozent niedrigeren API-Kosten. [2][4]
- AgentBaton erkennt mögliche Übergabepunkte anhand des bisherigen Aufgabenverlaufs; die Auswertung erfolgte unter anderem mit Terminal-Bench 2.1 und DeepSWE v1.1. [2][4]
- Die Ergebnisse betreffen API-Ausgaben, nicht automatisch die Gesamtkosten eines produktiven Systems: Lokale Rechenkosten und der Aufwand für den Detektor sind in der Kostenrechnung nicht vollständig enthalten. [2][4]
Inhalt · 7 Abschnitte
- Modellwechsel während einer Aufgabe statt Routing pro Anfrage
- Ein einmaliger Übergang in eine Richtung
- Arbeitsstand und Verlauf müssen gemeinsam übergeben werden
- AgentBaton soll den geeigneten Zeitpunkt erkennen
- Berichtete Kostensenkung in zwei Benchmarks
- Was die Kostenwerte für Unternehmen aussagen – und was nicht
- Ergebnisse bleiben an den Versuchsaufbau gebunden
- Quellen
Modellwechsel während einer Aufgabe statt Routing pro Anfrage
Lange KI-Agenten-Aufgaben bestehen aus wiederholten Schritten: Ein Agent plant, nutzt Werkzeuge, verarbeitet deren Rückmeldungen und passt sein Vorgehen an. Die dafür eingesetzten leistungsfähigeren Modelle können bei häufigen Aufrufen hohe API-Kosten verursachen. Zugleich sind kleinere oder günstigere Modelle nicht notwendigerweise stark genug, um eine solche Aufgabe von Anfang bis Ende zuverlässig zu erledigen. [2][5]
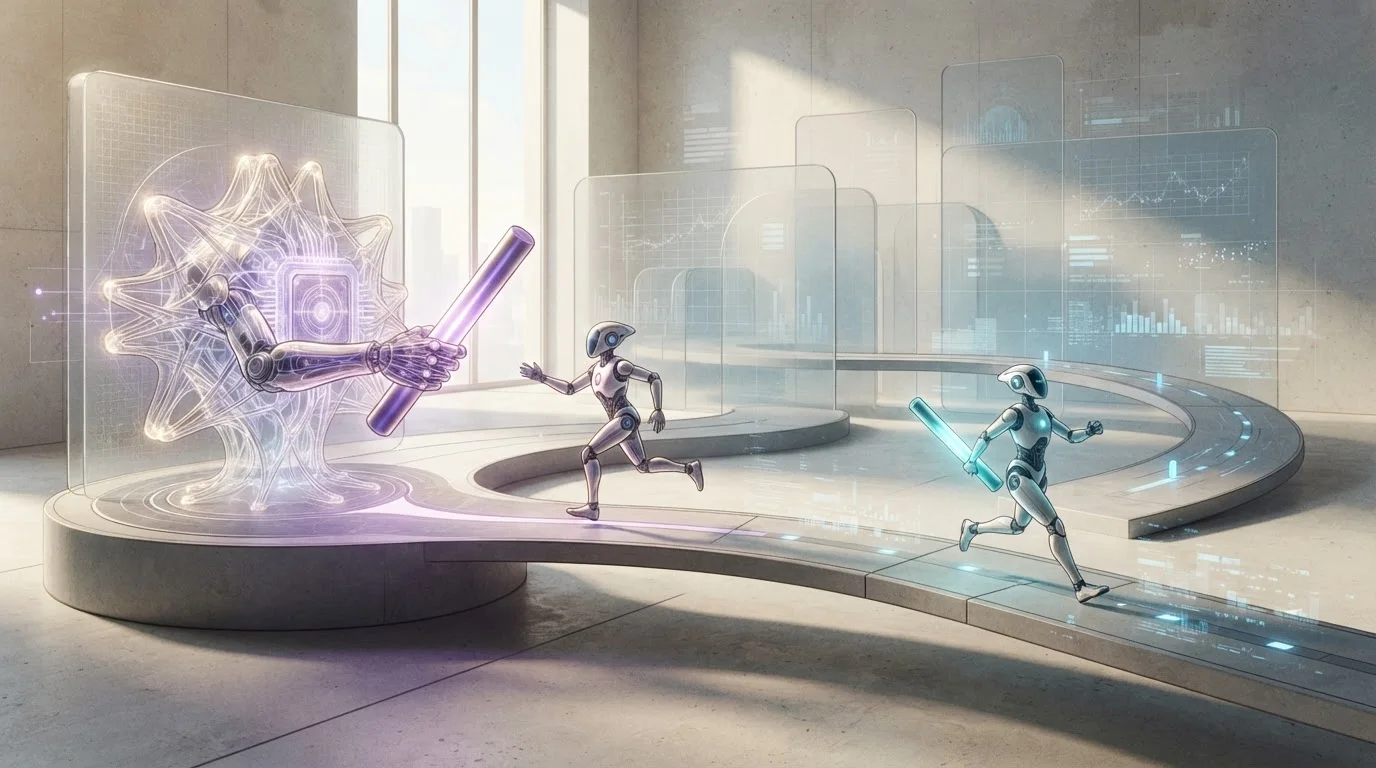
Eine am 25. Oktober 2026 bei arXiv eingereichte Arbeit untersucht deshalb eine andere Form der Modellkombination: Ein leistungsfähigeres Modell beginnt die Aufgabe und gibt sie zu einem geeigneten Zeitpunkt an ein effizienteres Modell ab. Das zweite Modell übernimmt den bestehenden Arbeitsstand und führt die Aufgabe fort. [2][5]
Das Verfahren unterscheidet sich von Routing, das vor einer einzelnen Anfrage auswählt, welches Modell antworten soll. Bei einem langen Agentenlauf verändert sich der Zustand der Aufgabe durch Werkzeugaufrufe und Zwischenergebnisse; welche Fähigkeiten benötigt werden, kann sich daher im Verlauf verschieben. Das Forschungsteam untersucht, ob sich daraus ein günstiger Zeitpunkt für einen Modellwechsel ableiten lässt. [2]
- Die Arbeit ist als arXiv-Preprint veröffentlicht; die hier vorliegenden Quellen belegen keine unabhängige Replikation der Ergebnisse. [5]
Ein einmaliger Übergang in eine Richtung
Die Autoren vergleichen zwei Übergaberichtungen: vom effizienteren zum leistungsfähigeren Modell und umgekehrt. In den beschriebenen Versuchen beginnt ein Modell die Aufgabe; nach der Übergabe setzt das andere sie bis zum Ende fort. Ein Wechsel zurück zum ersten Modell ist in diesem Versuchsaufbau nicht vorgesehen. [2]
Die Ergebnisse fallen laut Arbeit asymmetrisch aus. Beginnt das effizientere Modell und kommt später ein leistungsfähigeres hinzu, bleibt die Qualität häufig hinter dem alleinigen Einsatz des leistungsfähigeren Modells zurück. Zugleich kann der Kostenvorteil begrenzt sein oder ganz entfallen. Der umgekehrte Ablauf – zunächst das leistungsfähigere Modell, dann das effizientere – kann bei einem geeigneten Übergabezeitpunkt die Genauigkeit weitgehend erhalten und die Kosten reduzieren. [2]
Ein plausibler Grund für diesen Unterschied liegt im Zustand, den das erste Modell hinterlässt: In den Fallanalysen beschreibt das Team Aufgaben, bei denen das leistungsfähigere Modell bereits eine substanzielle Umsetzung oder ein benötigtes Artefakt erstellt und Rückmeldungen aus Tests oder Werkzeugen erhalten hat. Das Folgemodell muss dann eher gezielte Fehler beheben, prüfen oder abschließen, statt die gesamte Aufgabe neu zu erschließen. [2]
Die Autoren leiten daraus eine praktische Einschränkung für häufige Wechsel ab: Wenn ein effizienteres Modell einen ungünstigen Zwischenstand erzeugt, könnte ein leistungsfähigeres Modell zusätzliche Arbeit in die Korrektur investieren müssen. Die Studie prüft jedoch nicht sämtliche denkbaren Routing- oder Kooperationsstrategien, sondern konzentriert sich auf einen einmaligen Übergang. [2]
Arbeitsstand und Verlauf müssen gemeinsam übergeben werden
Bei einem Modellwechsel wird nicht nur die Kontrolle weitergegeben. Das empfangende Modell übernimmt auch den Arbeitsbereich, etwa bereits bearbeitete Dateien, und benötigt Informationen darüber, was zuvor geschehen ist. Die Arbeit vergleicht zwei Wege für diesen Verlauf: Die bisherige Interaktion kann direkt in den Gesprächskontext des neuen Modells aufgenommen oder als Protokolldatei im Aufgabenverzeichnis abgelegt werden. [2]
Eine vollständige Gesprächsübergabe gibt dem Folgemodell den bisherigen Dialog einschließlich Werkzeugaufrufen und deren Ausgaben mit. Das kann Verständnis erleichtern, erhöht aber die Länge des bereitgestellten Kontexts. Bei der Protokollvariante erhält das Modell stattdessen eine Datei mit chronologisch geordneten Aktionen und Werkzeugrückmeldungen, die es bei Bedarf mit üblichen Befehlen durchsuchen kann. [2]
Die Untersuchung findet keinen für alle Fälle überlegenen Übertragungsweg. Bei Übergaben vom effizienten zum leistungsfähigeren Modell war die Protokollvariante in den betrachteten Vergleichen häufig kostengünstiger und erreichte meist mindestens eine vergleichbare Genauigkeit. Beim Wechsel vom leistungsfähigeren zum effizienteren Modell hing die bessere Wahl stärker vom Ausgangsmodell und vom Zeitpunkt ab. [2]
Für GPT-5.6 Sol diskutieren die Autoren eine mögliche Erklärung: Das Modell stellt seine vollständigen Reasoning-Spuren nicht bereit. Dadurch könnte bei einer direkten Gesprächsübergabe weniger Begründungskontext für das Folgemodell verfügbar sein. Die Arbeit kennzeichnet dies als Hypothese, nicht als abschließend nachgewiesene Ursache. [2]
AgentBaton soll den geeigneten Zeitpunkt erkennen
Auf Basis wiederkehrender Muster in Aufgabenverläufen führen die Autoren AgentBaton ein, einen Detektor für mögliche Übergabepunkte. Das leistungsfähigere Modell bearbeitet die Aufgabe zunächst. Nach jedem Arbeitsschritt bewertet der Detektor den bisherigen Verlauf und entscheidet, ob dieses Modell weitermachen oder die Kontrolle an das effizientere Modell abgeben soll. [2][4]
Die NVIDIA-Projektseite beschreibt einen Detektor mit zwei Milliarden Parametern, der mit 4.000 Aufgabenverläufen trainiert wurde. Auf einer H100-GPU betrug die angegebene mediane Erkennungszeit 338 Millisekunden. Diese Kennzahl beschreibt die Detektor-Inferenz in der dort dargestellten Konfiguration; sie sagt für sich genommen nichts über die Gesamtdauer der Agenten-Aufgabe aus. [4]
Als Hinweise auf einen sinnvollen Übergabezeitpunkt nennt die Arbeit drei wiederkehrende Merkmale: Es gibt bereits eine relevante Umsetzung oder ein benötigtes Ergebnis, die Ausführung oder Prüfung hat aufgabenbezogene Rückmeldungen geliefert, und die verbleibende Arbeit ist stärker eingegrenzt. Auch ein fehlgeschlagener Test kann demnach nützlich sein, wenn er die offene Fehlerursache eingrenzt. [2]
Der Detektor ersetzt damit nicht die laufende Aufgabenausführung. Er beurteilt den bisherigen Verlauf und trifft eine Entscheidung über die weitere Modellzuweisung; anschließend arbeitet das effizientere Modell im übernommenen Arbeitsbereich weiter. [2][4]
Berichtete Kostensenkung in zwei Benchmarks
Das Forschungsteam evaluiert AgentBaton über elf Modellpaare hinweg auf Terminal-Bench 2.1 und DeepSWE v1.1. Terminal-Bench umfasst unter anderem terminalbasierte Aufgaben aus Softwareentwicklung, wissenschaftlichem Rechnen und Systemadministration. DeepSWE konzentriert sich auf anspruchsvolle Softwareentwicklungsaufgaben in bestehenden Open-Source-Repositories, deren Ergebnisse programmatisch geprüft werden. [2]
Über die untersuchten Kombinationen und Benchmarks hinweg beziffern die Autoren die durchschnittliche Verringerung der API-Kosten auf 65,9 Prozent. Die Genauigkeit blieb nach ihrer Zusammenfassung weitgehend erhalten; in einzelnen Konfigurationen lag sie bis zu 8,8 Prozentpunkte über dem alleinigen Einsatz des leistungsfähigeren Ausgangsmodells. Die Ergebnisse variieren jedoch nach Modellpaar und Konfiguration. [2][4][5]
Ein konkretes Beispiel auf DeepSWE v1.1 betrifft Kimi K3 als Ausgangsmodell und Qwen 3.8 27B als Folgemodell: Bei einer Übergabe nach 45 Prozent des vom Ausgangsmodell absolvierten Verlaufs erreichte die Kombination laut Arbeit 72,57 Prozent Genauigkeit. Der alleinige Kimi-K3-Lauf kam auf 73,45 Prozent; die Kosten lagen bei der Übergabe um 61,5 Prozent niedriger. [2]
Die NVIDIA-Projektseite nennt außerdem eine Kombination aus Claude Opus 5 und GPT-5.6 Luna: Für DeepSWE wird dort eine Genauigkeit von 76,1 Prozent bei 70,5 Prozent niedrigeren API-Kosten angegeben, verglichen mit 67,3 Prozent Genauigkeit beim alleinigen Einsatz des leistungsfähigeren Modells. Das ist ein Ergebnis aus der Projektdarstellung und kein unabhängiger Vergleich. [4]
In einem dort gezeigten Terminal-Bench-Beispiel kostet ein Durchlauf mit Opus allein nach der verwendeten Abrechnung 7,02 US-Dollar; AgentBaton erreicht laut Darstellung ein bestandenes Ergebnis bei 1,13 US-Dollar, während Qwen allein scheitert. Die Seite weist ausdrücklich darauf hin, dass es sich um die Wiederholung einer aufgezeichneten Testem-Trajektorie und nicht um eine Live-Inferenz handelt; lokale Modellkosten und Detektorkosten sind ausgeschlossen. [4]
Was die Kostenwerte für Unternehmen aussagen – und was nicht
Die Kostenrechnung der Arbeit bezieht sich auf API-Ausgaben: Für Cloud-Modelle werden gemeldeter Tokenverbrauch und die offiziellen Tokenpreise der Anbieter herangezogen. Lokal ausführbaren Modellen ordnet das Team in seiner Rechnung Kosten von null zu. [2]
Analyse: Die ausgewiesene Ersparnis ist deshalb nicht automatisch eine Senkung der Gesamtbetriebskosten. Unternehmen, die ein lokales Modell einsetzen, müssten zusätzlich die Kosten für Hardware, Betrieb und Bereitstellung berücksichtigen; auch für den Detektor selbst können Aufwände anfallen. Die Projektseite weist bei ihrem Beispiel gesondert darauf hin, dass lokale Rechen- und Detektorkosten nicht eingerechnet sind. [2][4]
Für einen betrieblichen Einsatz ist zudem relevant, dass der Übergabepunkt von der Qualität des bisherigen Arbeitsstands abhängt. Analyse: Unternehmen könnten den Ansatz daher nicht allein mit einem festen Anteil erledigter Schritte bewerten, sondern müssten testen, ob ihre eigenen Aufgaben tatsächlich ein brauchbares Zwischenergebnis und informative Rückmeldungen erzeugen. Die Arbeit selbst beschreibt den Fortschritt und die Art der verbleibenden Arbeit als wichtige Hinweise auf die Übergabereife. [2]
Die Benchmarks setzen außerdem einen konkreten technischen Rahmen: Verwendet wird mini-SWE-agent mit einer shellbasierten Werkzeug-Schnittstelle und einem linearen Interaktionsverlauf. Für Aufgaben gelten ein Zeitlimit von zwei Stunden und eine Obergrenze von 16.000 neu erzeugten Tokens je Arbeitsschritt. Die Messwerte lassen sich daher nicht ohne Weiteres auf andere Agenten-Architekturen, Aufgabenprofile oder Abrechnungsmodelle übertragen. [2]
Ergebnisse bleiben an den Versuchsaufbau gebunden
Die Kernaussagen beruhen auf einem arXiv-Preprint und den dort beschriebenen Experimenten. Die verfügbare Quellenlage enthält keine unabhängige Wiederholung der Versuche. Die berichteten Durchschnittswerte sind deshalb als Ergebnisse der Autoren unter den gewählten Bedingungen zu lesen, nicht als bereits allgemein bestätigte Einspargarantie. [2][5]
Auch die Aussage, dass eine einmalige Übergabe genügt, ist auf die untersuchte Strategie begrenzt. Die Arbeit vergleicht Übergaben zu ausgewählten Zeitpunkten und betrachtet einen Ablauf ohne Rückwechsel; häufiges Umschalten und andere Koordinationsmechanismen sind damit nicht umfassend bewertet. [2]
Die Autoren berichten zudem, dass AgentBaton in den geprüften Konfigurationen die empirische Genauigkeits-Kosten-Pareto-Grenze erweitert. Das bedeutet, dass unter den getesteten Einstellungen Kombinationen gefunden wurden, die im betrachteten Vergleich ein günstigeres Verhältnis aus Genauigkeit und Kosten erreichen. Es belegt nicht, dass jede Modellauswahl oder jeder produktive Agenten-Workflow davon profitiert. [2][4]
Ein X-Beitrag vom 9. November 2026 verwies auf die Arbeit, enthält selbst aber keine experimentellen Resultate. Die Aussagen zu Methode und Messergebnissen in diesem Artikel stützen sich daher auf den Preprint und die ergänzende Projektseite, nicht auf die knappe Erwähnung in sozialen Medien. [1][2][4]
Quellen
- [1] AgentBaton Efficient Model Collaboration in Agentic Tasks paper: — https://x.com/_akhaliq/status/2119858032888991775 (abgerufen am 2026-11-09)
- [2] AgentBaton: Efficient Model Collaboration in Agentic Tasks — https://arxiv.org/html/2610.35959v1 (abgerufen am 2026-11-09)
- [4] AgentBaton: Efficient Model Collaboration in Agentic Tasks | NVIDIA Learning and Perception Research — https://research.nvidia.com/labs/lpr/agentbaton (abgerufen am 2026-11-09)
- [5] [2610.35959] AgentBaton: Efficient Model Collaboration in Agentic Tasks — https://arxiv.org/abs/2610.35959 (abgerufen am 2026-11-09)
Nächster Artikel
Meta
Meta positioniert Muse Ember als Ausführungsmodell für agentische ArbeitsabläufeMeta meldet Muse Ember für Muse Code und die Meta Model API. Welche Aufgaben das Modell übernehmen soll und was Unternehmen vor dem Einsatz prüfen müssen.
Artikel teilen
Mehr zu KI-Agenten
Alle KI-Agenten-News- Latente Vektoren sollen den Kontextbedarf von KI-Agenten senken
Ein Tsinghua-Team komprimiert Tool-Ausgaben für LLM-Agenten in latente Vektoren und berichtet über weniger Tokenverbrauch und kürzere Laufzeiten.
- EvoMemState soll Widersprüche im Langzeitgedächtnis von KI-Agenten sichtbar machen
EvoMemState verbindet gespeicherte Fakten mit Beziehungen und einer anfragebezogenen Reasoning-Komponente. Die bisherige Evidenz stammt aus einem Preprint.
- Multi-Turn-RL für LLM-Agenten: Der Nutzen hängt vom Interaktionsbudget ab
Eine Studie zu Multi-Turn-RL zeigt: LLM-Agenten gewinnen vor allem bei Fehlerkorrektur und langen Abläufen; knappe Turn-Budgets schwächen den Effekt. [S1]
- CloudOpsBench zeigt Schwächen von KI-Agenten bei Cloud-Aufgaben
CloudOpsBench prüft KI-Agenten bei AWS-Aufgaben. Die Ergebnisse deuten auf Probleme beim Planen, Prüfen und sicheren Ausführen von Cloud-Operationen hin.
Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
Recherchieren Sie KI-News wie diese selbst – mit Mindverse Studio.
7 Tage kostenlos testen – ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.