
Statista+ verkürzt Interviewauswertung – Analysten bleiben für die Prüfung zuständig
Mindverse News
KI-gestützt erstellt, vor Veröffentlichung redaktionell geprüft 3 Quellen
Das Wichtigste in Kürze
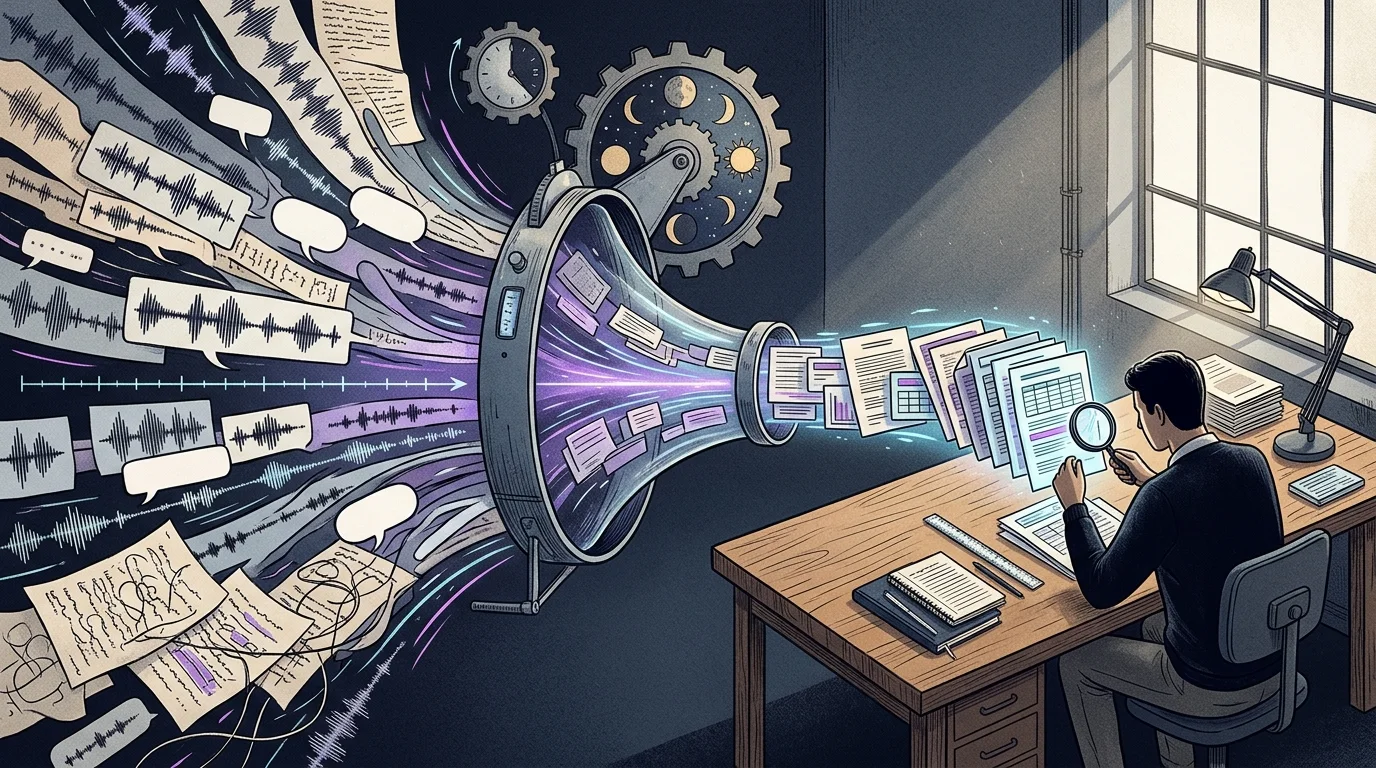
- Statista+ gibt an, die Auswertung eines typischen Projekts mit 30 bis 40 Experteninterviews von rund sechs Wochen auf zwei Tage zu verkürzen. [1]
- Die Pipeline benötigt laut dem t3n-Bericht etwa 30 Minuten Rechenzeit; der übrige Aufwand umfasst unter anderem menschliche Validierung. [1]
- Regelbasierte Aufgaben erledigt das Team nach eigener Darstellung ohne KI; Analystinnen und Analysten kontrollieren Stichproben und Grenzfälle. [1]
- Eine fachwissenschaftliche Untersuchung zu ChatGPT fand bei qualitativen Inhaltsanalysen grobe Annäherungen, Fehlkategorisierungen und wechselnde Ergebnisse bei wiederholten Eingaben. Sie prüfte jedoch nicht das Statista+-System. [3]
- Für Unternehmen ist die Zeitersparnis daher als berichteter Anwendungsfall zu verstehen, nicht als unabhängig bestätigter Qualitätsnachweis oder allgemeiner Leistungswert. [1][3]
// Inhalt · 6 Abschnitte
- Der Zeitgewinn entsteht nicht allein durch ein Sprachmodell
- Ein Baukasten statt eines einzigen Prompts
- Vom Präsentationsbericht zur durchsuchbaren Zitatbasis
- Die heikle Stelle: Zitate und Interpretation
- Fachliche Ergebnisse zu ChatGPT mahnen zur Methodenkontrolle
- Was Unternehmen vor einer Übertragung prüfen sollten
- Quellen
Der Zeitgewinn entsteht nicht allein durch ein Sprachmodell
Ein typisches Projekt mit 30 bis 40 Experteninterviews konnte bei Statista+ nach Darstellung des t3n-Berichts früher rund sechs Wochen beanspruchen. Für die Auswertung eines einzelnen Gesprächs fielen demnach acht bis zwölf Stunden an. Der Bericht führt den Aufwand auf das Lesen umfangreicher Transkripte, das Ordnen der Aussagen und deren Übertragung in Tabellen zurück. [1]
Die neue Pipeline soll ein Projekt in etwa 30 Minuten Rechenzeit verarbeiten. Zusammen mit menschlicher Validierung veranschlagt Statista+ laut t3n rund zwei Tage. Die oft zitierte Verkürzung auf rund 95 Prozent ist damit eine Angabe des Use Cases; der Text liefert keine unabhängige Messung oder detaillierte Vergleichsrechnung, anhand derer sich diese Quote nachprüfen ließe. [1]
Wichtig ist die Unterscheidung zwischen Rechenzeit und Projektlaufzeit: Die rund 30 Minuten beschreiben die Verarbeitung durch die Pipeline, die zwei Tage schließen menschliche Prüfung ein. Die KI übernimmt folglich nicht den gesamten Analyseprozess. Der berichtete Zeitgewinn entsteht aus automatisierten Arbeitsschritten, einer vorab festgelegten Verarbeitung und einer verbleibenden Kontrolle durch Analystinnen und Analysten. [1]
- Projektumfang laut Bericht: typischerweise 30 bis 40 Interviews. [1]
- Früherer Aufwand laut Statista+: acht bis zwölf Stunden pro Gespräch. [1]
- Angegebene Pipeline-Rechenzeit: rund 30 Minuten pro Projekt; mit Validierung rund zwei Tage. [1]
Die Ausgangsdaten bleiben anspruchsvoll
Eine Stunde Audio entspricht dem Bericht zufolge nach automatischer Transkription ungefähr 80.000 Zeichen. Diese Texte enthalten Füllwörter und abgebrochene Sätze; sie müssen für die Auswertung strukturiert und in den Zusammenhang der jeweiligen Fragestellung eingeordnet werden. Die Automatisierung setzt also nicht bei einem bereits fertigen Ergebnis an, sondern bei umfangreichem, oft unübersichtlichem Ausgangsmaterial. [1]
Der t3n-Text beziffert den früheren Aufwand pro Interview, beschreibt aber nicht im Detail, wie sich dieser auf Transkription, Codierung, Interpretation und Berichtserstellung verteilt. Die Zahlen sind deshalb als Angaben zum Statista+-Ablauf zu lesen, nicht als allgemeingültige Kalkulation qualitativer Forschung. [1]
Ein Baukasten statt eines einzigen Prompts
Statista+ habe zunächst versucht, einer KI alle Anforderungen in einem einzigen Prompt zu übergeben. Laut dem Bericht führte das zu komplexen und fehleranfälligen Anweisungen. Das Team setzte anschließend auf eine Kombination aus Skripten und KI-Modulen. Welche Verarbeitung ein Projekt benötigt, werde vorab anhand eines Varianz-Modells entschieden: Je offener die Fragen und je unterschiedlicher die Antworten, desto leistungsfähiger müsse das eingesetzte Werkzeug sein. [1]
Ein Teil der Aufgaben werde regelbasiert und ohne KI erledigt. Statista+ begründet das damit, Kosten zu vermeiden und Halluzinationen zu verringern. Für Unternehmen ist diese Aufgabenteilung analytisch relevant: Nicht jeder Prozessschritt muss an ein generatives Modell übergeben werden. Wo ein Schritt mit festen Regeln abbildbar ist, kann eine deterministische Verarbeitung die Zahl der Stellen begrenzen, an denen ein Modell Inhalte interpretieren oder erzeugen muss. Diese Einordnung ist eine Schlussfolgerung aus dem beschriebenen Vorgehen, kein unabhängig gemessener Effekt. [1]
Der Bericht kündigt eine Pipeline mit vier Schritten an, legt sie im frei zugänglichen Text aber nicht vollständig offen. Konkrete Prompts, Codeausschnitte und eine ausführliche Einstiegsanleitung seien Teil des kostenpflichtigen Use Cases. Aus dem vorliegenden Material lässt sich deshalb weder die genaue technische Architektur noch die Übertragbarkeit auf andere Datensätze beurteilen. [1]
- Aufgaben mit festen Regeln werden nach Darstellung des Teams ohne KI bearbeitet. [1]
- Für variablere, offenere Antworten kommen KI-Module hinzu; die Auswahl richte sich nach dem Varianz-Modell. [1]
- Die öffentlich verfügbare Beschreibung nennt weder eine vollständige Architektur noch Kennzahlen für einzelne Verarbeitungsschritte. [1]
Vom Präsentationsbericht zur durchsuchbaren Zitatbasis
Vor der Umstellung habe ein Projekt nach Angaben des Teams typischerweise in einer PowerPoint-Präsentation mit verdichteten Erkenntnissen geendet. Wenn Kunden eine einzelne Aussage hinterfragen wollten, sei das mit zusätzlichem Aufwand verbunden gewesen. Die automatisierte Analyse liefere nun eine durchsuchbare Datenbank mit validierten Originalzitaten, über die sich Kunden von einer Übersicht bis zu einzelnen Aussagen bewegen könnten. [1]
Das verändert nicht nur die Geschwindigkeit, sondern auch die Form des Ergebnisses: Statt ausschließlich eine zusammengefasste Interpretation zu erhalten, sollen Nutzerinnen und Nutzer Belege im Ausgangsmaterial wiederfinden können. Der Bericht hebt außerdem hervor, dass sich Widersprüche zwischen Gesprächspartnern dadurch eher sichtbar machen ließen, während sie in einer verdichteten Zusammenfassung untergehen könnten. [1]
Für B2B-Teams kann eine solche Nachvollziehbarkeit die Rückfrage zu einem Befund erleichtern: Eine Aussage lässt sich mit dem zugehörigen Zitat abgleichen, statt nur in einer Präsentationsfolie zu erscheinen. Das ist eine plausible betriebliche Wirkung der beschriebenen Datenbank, aber keine im Text quantifizierte Verbesserung der Analysequalität. Der Bericht nennt weder eine unabhängige Prüfung der Zitatdatenbank noch Messwerte zu Fehlerquoten oder zur Vollständigkeit der erfassten Aussagen. [1]
Die heikle Stelle: Zitate und Interpretation
Bei Experteninterviews sind Originalzitate besonders sensibel: Eine Formulierung kann als Beleg für eine Position dienen und muss tatsächlich im Gespräch gefallen sein. Der t3n-Bericht räumt ein, dass das Modell in einem frühen Versuch auf die Frage nach direkten Zitaten zu einem Thema teils Formulierungen erfunden habe. Das Team habe den Prozess daraufhin angepasst, sodass Zitate konkreten Aussagen zugeordnet würden. Stichproben begleiteten weiterhin die Verarbeitung; erfahrene Analystinnen und Analysten prüften vor der Freigabe Grenzfälle. [1]
Diese Beschreibung macht deutlich, dass die Kontrolle nicht bloß ein nachträglicher Qualitätsschritt ist. Sie schützt eine Funktion, bei der eine sprachlich passende, aber nicht belegte Formulierung den Befund verfälschen könnte. Der Bericht erläutert jedoch nicht, wie groß die Stichproben sind, welche Fehlerklassen geprüft werden oder wie häufig Grenzfälle auftreten. Die Aussage, der Prozess fange erfundene Zitate ab, bleibt damit eine Beschreibung des Anbieters beziehungsweise des Use Cases und ist kein veröffentlichter unabhängiger Test. [1]
Auch die Bezeichnung „validierte Originalzitate“ sollte vor diesem Hintergrund eng verstanden werden: Laut Bericht gibt es Stichproben und eine Prüfung bestimmter Fälle. Ein statistischer Nachweis, dass alle Zitate korrekt und vollständig sind, wird im verfügbaren Text nicht vorgelegt. [1]
Fachliche Ergebnisse zu ChatGPT mahnen zur Methodenkontrolle
Ein fachwissenschaftlicher Erfahrungsbericht von Philipp Mayring bietet einen wichtigen, aber nicht direkt vergleichbaren Gegenpunkt. Mayring testete ChatGPT 3.5 und 4 anhand von Interviewmaterial und einer eigenen Musterlösung für qualitative Inhaltsanalyse. Bei den untersuchten Aufgaben fand er nach eigener Auswertung teilweise grobe Annäherungen, Fehlkategorisierungen und Probleme, die jeweiligen methodischen Vorgaben zuverlässig umzusetzen. [3]
Besonders relevant für den Unternehmenseinsatz ist sein Bericht über Wiederholungen: Bei identischer Eingabe habe ChatGPT zu unterschiedlichen Zeitpunkten unterschiedliche Kategorien und Auswertungen geliefert. Mayring wertete den Test der Kodierübereinstimmung als gescheitert. Er beschreibt außerdem Fälle, in denen die KI indirekte Bedeutungen oder ironische Äußerungen nicht erkannte. [3]
Diese Ergebnisse sind kein Beleg dafür, dass die Statista+-Pipeline dieselben Fehler macht. Mayrings Untersuchung betrachtete bestimmte ChatGPT-Versionen und qualitative Verfahren, nicht das von Statista+ beschriebene Zusammenspiel aus Skripten, KI-Modulen und menschlicher Validierung. Sie zeigt aber, warum die Leistung eines Modells nicht allein an einer plausibel klingenden Zusammenfassung gemessen werden sollte: Kategorien müssen zur Forschungsfrage passen, Textstellen müssen überprüfbar sein und wiederholte Analysen sollten auf Konsistenz geprüft werden. [1][3]
Die methodische Einordnung ist auch deshalb wichtig, weil qualitative Inhaltsanalyse nicht bloß das Zusammenfassen von Text ist. Ein Leitfaden der Technischen Hochschule Köln beschreibt sie als regelgeleitetes Verfahren, bei dem Kategorien entwickelt, Interviews codiert und Ergebnisse kategorienbasiert ausgewertet werden. Qualitative Forschung kann außerdem subjektive Sichtweisen und latente Bedeutungen untersuchen; die passende Methode hängt von Forschungsgegenstand und Fragestellung ab. [4]
Daraus folgt für die Praxis: Ein schnellerer Durchlauf beantwortet noch nicht die Frage, ob das Verfahren für eine bestimmte Untersuchung geeignet ist. Eine strukturierte Kategorisierung wiederkehrender Antworten kann andere Anforderungen haben als die Interpretation von Mehrdeutigkeiten, impliziten Motiven oder widersprüchlichen Erzählungen. Diese Abgrenzung ist eine methodische Schlussfolgerung aus den beschriebenen Anforderungen qualitativer Forschung und den von Mayring dokumentierten Grenzen seiner ChatGPT-Tests. [3][4]
Was Unternehmen vor einer Übertragung prüfen sollten
Der Statista+-Fall belegt zunächst einen konkreten, vom Anbieter geschilderten Arbeitsablauf: Ein Team verbindet regelbasierte Verarbeitung und KI-Module, passt den Werkzeugeinsatz an die Variabilität der Interviews an und lässt Ergebnisse durch Menschen prüfen. Er belegt nicht, dass sich die genannte Laufzeit oder Qualität auf andere Organisationen, Fragestellungen und Datenbestände übertragen lässt. [1]
Für eine interne Bewertung wäre daher nicht nur die End-to-End-Zeit relevant. Unternehmen könnten zusätzlich erfassen, wie viele Aussagen manuell nachkorrigiert werden, ob dieselben Daten bei wiederholten Durchläufen vergleichbar codiert werden und ob Zitate zuverlässig auf die zugrunde liegenden Transkriptstellen zurückführen. Das sind aus den im Fallbericht beschriebenen Risiken abgeleitete Prüffragen, keine dort bereits beantworteten Kennzahlen. [1][3]
Ebenso sollte die Forschungsfrage vor der Automatisierung feststehen. Die fachliche Quelle zur qualitativen Forschung betont, dass die Methode zum Gegenstand und zur Fragestellung passen muss; Mayrings Tests zeigen zugleich, dass präzise Anweisungen allein nicht automatisch eine methodisch korrekte Analyse garantieren. Für die Beschaffung oder den Pilotbetrieb spricht das dafür, ein System an echten, fachlich geprüften Fällen zu testen und nicht allein anhand der Geschwindigkeit oder einer überzeugenden Demo zu beurteilen. [3][4]
Der praktische Kern des Use Cases ist damit weniger „KI ersetzt sechs Wochen Analyse“ als „ein Teil der Verarbeitung wird automatisiert, während Analyseaufbau und Qualitätssicherung beim Team bleiben“. Genau diese Aufteilung dürfte für Unternehmen entscheidend sein: Der Zeitgewinn ist dann belastbar, wenn auch bei kürzerer Bearbeitung nachvollziehbar bleibt, wie aus Interviewaussagen Kategorien, Befunde und zitierte Belege entstehen. Die verfügbare Beschreibung liefert dafür ein plausibles Prozessmodell, aber noch keinen unabhängigen Nachweis der Ergebnisqualität. [1][3]
Quellen
- [1] Interviews mit KI auswerten: Statista+ spart rund 95 % Zeit — https://t3n.de/news/interviews-mit-ki-auswerten-statista-plus-1731559 (abgerufen am 2026-10-29)
- [3] Qualitative Inhaltsanalyse mit ChatGPT — https://www.qualitative-research.net/index.php/fqs/article/download/4252/5162/19735 (abgerufen am 2026-10-29)
- [4] 1 Einleitung — https://www.th-koeln.de/mam/bilder/hochschule/fakultaeten/f01/skript_interviewsqualinhaltsanalyse-fertig-05-08-2014.pdf (abgerufen am 2026-10-29)
//Nächster Artikel
OpenAI
OpenAI stellt Model Spec für autonomere Aufgaben neu aufOpenAI kündigt laut X-Thread eine überarbeitete Model Spec für autonomere Modelle an. Die vorliegenden Quellen bestätigen den neuen Wortlaut nur teilweise.
// Artikel teilen
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
- KI-Chat mit allen führenden ModellenGPT, Claude und Gemini in einer Oberfläche — mit Websuche und Quellenangaben.
- Dokumente und Daten analysierenAuswerten, vergleichen und Abweichungen automatisch erkennen.
- Transkription und Meeting-Protokolle60 Minuten Meeting, 2 Minuten Protokoll — mit Sprechererkennung.
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.