
OfficeTown simuliert Organisationen als Trainingsumgebungen für KI-Agenten
Mindverse News
KI-gestützt erstellt 3 Quellen Originalmeldung: huggingface.co Arbeitsweise
Das Wichtigste in Kürze
- OfficeTown erzeugt simulierte professionelle Organisationen, in denen Arbeit, Entscheidungen, Dokumente und Feedback über mehrere Aufgaben hinweg bestehen bleiben. [1]
- Der Benchmark umfasst 406 Aufgaben und 4.836 Bewertungskriterien aus 23 simulierten Organisationen in acht Berufsfeldern; laut Abstract floss Feedback von Fachexperten ein. [1]
- Die Autoren berichten, dass über OfficeTown-Daten trainiertes Qwen3.5-9B bei externen Benchmarks für professionelle Arbeit, darunter GDPval, deutlich besser abschnitt. Konkrete Punktwerte nennt das Abstract nicht. [1]
- In ergänzenden Tests erzielte das untersuchte Principal-Assistant-System höhere Werte als die getesteten Einzel- und Multi-Agenten-Baselines. Die Aussage ist auf diese Vergleichssysteme begrenzt. [1]
- Für Unternehmen ist OfficeTown vorerst vor allem als Forschungsansatz zur Erzeugung und Prüfung arbeitsbezogener Agentendaten relevant; das Abstract belegt keine produktive Einsatzreife. [1]
// Inhalt · 8 Abschnitte
- Eine Organisation statt isolierter Aufgaben
- Rollen, Berechtigungen und dauerhafter Kontext
- Ein Benchmark mit 406 Aufgaben
- Trainingsgewinne laut Abstract
- Der Vergleich mit Einzel- und Multi-Agenten-Systemen
- Warum persistente Arbeitskontexte für Unternehmen relevant sind
- Einordnung in die Debatte um agentische Organisationen
- Welche Evidenz für eine Bewertung noch fehlt
- Quellen
Eine Organisation statt isolierter Aufgaben
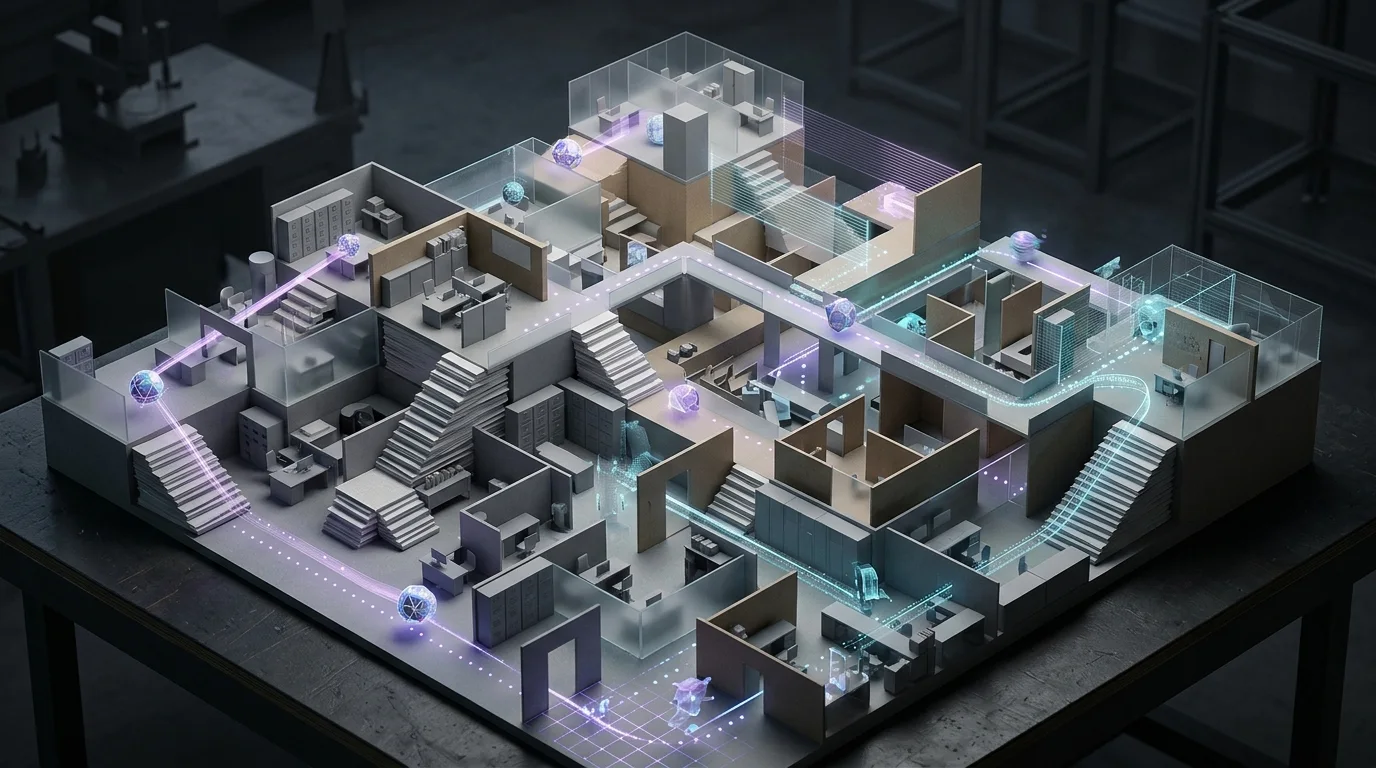
Viele Tests für KI-Agenten bilden Arbeit als einzelne, klar abgegrenzte Aufgabe ab. OfficeTown setzt an einer anderen Stelle an: Das von den Autoren vorgestellte Simulationsframework soll fortbestehende professionelle Organisationen erzeugen, in denen neue Aufgaben aus der laufenden Arbeit und ihrem Kontext hervorgehen. Damit rückt nicht nur das Ergebnis einer einzelnen Anfrage in den Blick, sondern auch, ob ein Agent mit Informationen umgehen kann, die sich über mehrere Arbeitsaufträge hinweg ansammeln. [1]
Die Paperseite beschreibt OfficeTown als Rahmen zur Erzeugung arbeitsbezogener Trainingsdaten und Evaluationsbenchmarks. Die simulierten Organisationen sind dabei keine realen Unternehmen: Laut Abstract werden sie anhand einer natürlichsprachlichen Beschreibung ihres Zwecks und ihrer Tätigkeiten initialisiert. Aussagen über die Übertragbarkeit der Simulation auf konkrete Betriebsabläufe sind im bereitgestellten Abstract nicht enthalten. [1]
Rollen, Berechtigungen und dauerhafter Kontext
Innerhalb einer simulierten Organisation koordinieren Mitglieder Arbeit, teilen begrenzte Aufgaben an Assistenzagenten aus und prüfen deren Ergebnisse. Dokumente, getroffene Entscheidungen und noch offene Punkte bleiben laut Beschreibung erhalten und beeinflussen spätere Arbeiten. Verantwortlichkeiten und Berechtigungen legen zudem fest, welche Informationen ein Mitglied sehen und welche Handlungen es ausführen kann. [1]
Diese Architektur unterscheidet sich von einem Test, bei dem ein Agent nur einen Prompt erhält und anschließend eine Antwort erzeugt. OfficeTown bindet Aufgaben an einen Verlauf: Ein späterer Arbeitsschritt kann von früheren Entscheidungen oder noch ungeklärten Fragen abhängen. Als Analyse lässt sich daraus ableiten, dass der Benchmark Fähigkeiten wie Kontextnutzung, Übergaben und die Einhaltung rollenbezogener Zugriffsgrenzen gemeinsam untersuchen könnte. Das Abstract erläutert jedoch nicht, wie diese Fähigkeiten im Einzelnen gemessen oder voneinander getrennt werden. [1]
Ein Benchmark mit 406 Aufgaben
Aus den simulierten Arbeitsabläufen kuratieren die Forschenden Arbeitsanfragen, den jeweils relevanten Kontext und Rückmeldungen aus der Prüfung der Ergebnisse. Diese Materialien werden laut Paperseite als ausführbare Ressourcen für Evaluation und Lernen aufbereitet. OfficeTown Bench umfasst 406 Aufgaben und 4.836 Bewertungskriterien, verteilt auf 23 simulierte Organisationen aus acht professionellen Domänen. Die Autoren geben außerdem an, Feedback von Fachexperten einbezogen zu haben. [1]
Die Zahl der Kriterien deutet darauf hin, dass eine Aufgabe nicht notwendigerweise mit einem einzigen binären Urteil bewertet wird. Das ist eine vorsichtige Einordnung der angegebenen Größenordnung, keine im Abstract beschriebene Auswertungsmethode: Welche Kriterien für welche Aufgaben gelten, wie sie gewichtet werden und wie das Expertenfeedback in die Bewertung eingeflossen ist, führt die Paperseite nicht aus. Auch eine Aufschlüsselung der acht Domänen oder konkrete Aufgabenbeispiele enthält der bereitgestellte Text nicht. [1]
Trainingsgewinne laut Abstract
Die Autoren berichten, dass Frontier-Modelle bei den OfficeTown-Aufgaben noch erheblichen Verbesserungsspielraum hätten. Zahlen zu den einzelnen Modellen oder ihren Ausgangswerten nennt das Abstract nicht. Eine genauere Einordnung dieser Aussage – etwa nach Domäne, Aufgabentyp oder Leistungsmaß – ist auf Grundlage der bereitgestellten Angaben daher nicht möglich. [1]
Für das Training setzen die Forschenden OfficeTown-Daten mit Supervised Fine-Tuning und On-Policy Distillation ein. Bei Qwen3.5-9B hätten beide Ansätze die Leistung auf externen Benchmarks für professionelle Arbeit deutlich verbessert; GDPval wird als Beispiel genannt. Das ist ein von den Autoren berichtetes Ergebnis. Das Abstract enthält weder konkrete Punktwerte noch Angaben zu den jeweiligen Vergleichswerten, zur Größe der Trainingsdaten oder dazu, wie stabil der Gewinn über unterschiedliche Testbedingungen hinweg ausfiel. [1]
Die externe Evaluation ist relevant, weil eine Verbesserung auf den erzeugten OfficeTown-Aufgaben allein noch nicht zeigen würde, dass das Training auch bei anderen Aufgaben hilft. Dass die Autoren zusätzlich externe Benchmarks heranziehen, erweitert den berichteten Nachweis. Wie weit sich daraus ein allgemeiner Leistungsgewinn für produktive Wissensarbeit ableiten lässt, bleibt ohne detaillierte Resultate und Angaben zu den Testbedingungen offen. [1]
Der Vergleich mit Einzel- und Multi-Agenten-Systemen
Ergänzende Evaluationen vergleichen laut Abstract einen Principal-Assistant-Harness mit Einzelagenten- und Multi-Agenten-Baselines. Das untersuchte Harness erzielt demnach höhere Werte als die getesteten Vergleichssysteme. Die Paperseite beschreibt außerdem ein Arbeitsprinzip, bei dem Organisationsmitglieder begrenzte Aufgaben delegieren und die Ergebnisse prüfen. Damit ist eine mögliche Erklärung für den Vergleich angelegt: Leistung kann nicht nur vom zugrunde liegenden Modell abhängen, sondern auch davon, wie Aufgaben verteilt und Ergebnisse kontrolliert werden. [1]
Der Befund ist ausdrücklich auf die getesteten Baselines begrenzt. Aus dem Abstract geht nicht hervor, welche Modelle, Werkzeuge, Prompts oder Ressourcen in den Vergleich eingingen und wie groß der Leistungsabstand war. Er belegt deshalb weder, dass ein bestimmtes Organisationsmuster grundsätzlich allen Multi-Agenten-Ansätzen überlegen ist, noch dass es in betrieblichen Abläufen zuverlässig bessere Ergebnisse liefert. [1]
Warum persistente Arbeitskontexte für Unternehmen relevant sind
Für Unternehmen liegt der mögliche Nutzen des Ansatzes weniger in einer unmittelbar einsetzbaren Bürosoftware als in der Prüf- und Trainingsumgebung. Wenn Arbeitsaufträge von früheren Entscheidungen, Dokumenten und offenem Klärungsbedarf abhängen, können Unternehmen Agenten näher an den Bedingungen wiederkehrender Arbeit testen als mit vollständig isolierten Aufgaben. Das ist eine Analyse der beschriebenen Simulationslogik, keine Aussage über bereits nachgewiesene Produktivität in realen Organisationen. [1]
Auch die Rolle und Berechtigung eines Agenten lässt sich in diesem Rahmen als Teil des Arbeitskontexts behandeln. Das ist für Unternehmen potenziell relevant, weil ein korrektes Arbeitsergebnis allein nicht genügt, wenn ein System auf unzulässige Informationen zugreift oder außerhalb seines Auftrags handelt. OfficeTown führt Verantwortlichkeiten und Zugriffsrechte als Bestandteile der Simulation auf; konkrete Sicherheitsprüfungen oder ein Nachweis für die Durchsetzung realer Unternehmensrichtlinien werden im Abstract jedoch nicht beschrieben. [1]
Einordnung in die Debatte um agentische Organisationen
Der Forschungsansatz passt zu einer breiteren Diskussion darüber, wie KI-Agenten in arbeitsteilige Organisationen eingebunden werden können. Ein Beitrag der California Management Review beschreibt Agenten als Systeme, die Aufgaben selbstständig oder in Zusammenarbeit bearbeiten können, weist zugleich aber auf frühe Entwicklungsstadien, Halluzinationen und fehlerhafte Entscheidungen hin. Er plädiert unter anderem für Risikosteuerung und Eingriffsmöglichkeiten für Menschen. [2]
McKinsey beschreibt ein mögliches Organisationsmodell, in dem Menschen und virtuelle oder physische Agenten zusammenarbeiten. Der Beitrag skizziert eine Entwicklung von unterstützenden Werkzeugen bis zur Automatisierung ganzer Arbeitsabläufe und betont, dass menschliche Verantwortlichkeit und Aufsicht erhalten bleiben sollen. Das sind Einschätzungen und Erfahrungen aus einem Beratungsbeitrag, keine unabhängige Validierung der OfficeTown-Ergebnisse. [5]
Vor diesem Hintergrund ist die Trennung zwischen simuliertem Test und betrieblicher Einführung zentral. OfficeTown macht Organisationen, Rollen und Arbeitshistorien zum Gegenstand von Evaluation und Training. Die vorliegenden Angaben zeigen aber nicht, dass ein mit diesen Daten trainierter Agent reale Unternehmensprozesse bereits sicher, regelkonform oder wirtschaftlicher ausführt. [1][2][5]
Welche Evidenz für eine Bewertung noch fehlt
Die bereitgestellte Paperseite enthält ein Abstract, nicht die vollständige Darstellung der Versuchsaufbauten. Offen bleiben damit unter anderem die genaue Zusammensetzung der Domänen, die Bewertungsregeln, die konkreten Ergebnisse pro Benchmark sowie die Vergleichsbedingungen für Training und Harness. Die gemeldeten Verbesserungen sind daher als Zusammenfassung der Autoren zu lesen, nicht als unabhängig bestätigte Leistungswerte. [1]
Für eine belastbare Bewertung durch Unternehmen wären insbesondere nachvollziehbare Aufgabenbeispiele, Angaben zur Reproduzierbarkeit und Ergebnisse nach Aufgabentyp hilfreich. Ebenso müsste geklärt werden, wie die simulierten Regeln und Berechtigungen mit den Vorgaben eines konkreten Betriebs abgeglichen werden. Diese Punkte sind Fragen, die sich aus dem beschriebenen Ansatz ergeben; das Abstract beantwortet sie nicht. [1]
OfficeTown liefert damit einen Forschungsbeitrag zur Generierung arbeitsbezogener Agentendaten und zur Evaluation von Systemen in anhaltenden organisatorischen Kontexten. Die berichteten Trainingsgewinne und der Vergleich mit ausgewählten Baselines sind ein erster Hinweis auf den möglichen Nutzen dieses Ansatzes. Für Investitions- oder Einsatzentscheidungen reichen die Angaben allein jedoch nicht aus: Dafür wären detaillierte Versuchsergebnisse und ein Nachweis unter den jeweiligen betrieblichen Bedingungen nötig. [1]
Quellen
- [1] Paper page - OfficeTown: Generative Organizations for Evolving Agent Intelligence — https://huggingface.co/papers/2610.23194 (abgerufen am 2026-10-19)
- [2] The Non-Human Enterprise: How AI Agents Reshape Organizations | California Management Review — https://cmr.berkeley.edu/2025/10/the-non-human-enterprise-how-ai-agents-reshape-organizations (abgerufen am 2026-10-19)
- [5] The agentic organization: A new operating model for AI | McKinsey — https://www.mckinsey.com/capabilities/people-and-organization/our-insights/the-agentic-organization-contours-of-the-next-paradigm-for-the-ai-era (abgerufen am 2026-10-19)
//Nächster Artikel
KI-Agenten
Dream2Discern sucht gezielt nach Schwächen in der Fehlerprognose von Multi-AgentenDream2Discern prognostiziert Ausfälle in Multi-Agenten-Systemen aus laufenden Interaktionen. Der Preprint trainiert Auditoren mit verlustgesteuerten Varianten.
// Artikel teilen
Mehr zu KI-Agenten
Alle KI-Agenten-News- Benchmark zeigt Schwächen von KI-Agenten bei wissenschaftlichen Schlüsselentscheidungen
Ein Benchmark aus 248 Forschungsentscheidungen zeigt Schwächen von KI-Agenten bei wissenschaftlicher Planung – und Grenzen der Aussagekraft.
- Studie: Coding-Agenten profitieren stärker von vollständigen Quelldateien als von Textkompression
Eine Studie vergleicht Kontextmethoden für Coding-Agenten: Die Auswahl vollständiger Dateien erzielt auf 300 SWE-rebench-Aufgaben höhere Erfolgsquoten.
- OS-Helix trainiert Desktop-Agenten für den Wechsel zwischen Oberfläche und Code
OS-Helix verbindet GUI-Aktionen und Codeausführung. Die Autoren berichten 66,44 Prozent Erfolg auf OSWorld-Verified; Einordnung und Grenzen im Überblick.
- KI-Agenten sollen Fortschritt statt Gesprächsverlauf speichern
CarryOn bündelt Fortschritt lang laufender KI-Agenten in wiederverwendbaren Aufgabenobjekten. Die Studie berichtet weniger Tokens und bessere Benchmarkwerte.
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Passend dazu in Mindverse Studio
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.