
InteractiveWorld testet multimodale Assistenten in simulierten Alltagssituationen
Mindverse News
KI-gestützt erstellt 4 Quellen Arbeitsweise
Das Wichtigste in Kürze
- InteractiveWorld kombiniert eine 3D-Simulation mit InteractiveBench, einem Katalog aus 120 mehrteiligen Aufgaben in sechs Kategorien. [2][3]
- Anders als bei statischen Bildtests soll das System eine Folge aus Beobachten, Anleiten, menschlichem Handeln und aktualisierter Szene abbilden. [2][3]
- Erfolge werden laut Projektbeschreibung anhand des Zustands der simulierten Welt überprüft, nicht allein anhand der sprachlichen Antwort. [2][3]
- Im Abstract berichten die Autoren von Tests mit zwölf multimodalen Modellen; das stärkste Modell erreichte bei langfristigen Guidance- und Planning-Aufgaben höchstens 20 beziehungsweise 25 Prozent. [2]
- Ein Kommentar unter dem X-Beitrag nennt abweichend 41,7 Prozent, erläutert aber weder die Metrik noch den Aufgabenbereich; die Angabe ist daher nicht direkt mit den Abstract-Werten vergleichbar. [1][2]
// Inhalt · 8 Abschnitte
- Ein Prüfstand für Assistenten, die Menschen durch Aufgaben führen
- Vom Bildverständnis zur geschlossenen Interaktionsschleife
- Eine simulierte Person statt eines Roboters als Handlungsträger
- 120 Aufgaben in sechs Kategorien
- Zustandsprüfung macht Erfolge nachvollziehbarer
- Die berichteten Modellwerte und eine nicht aufgelöste Abweichung
- Hohe technische Einstiegshürden für eine eigene Auswertung
- Was der Ansatz für B2B-Teams leisten kann – und was nicht
- Quellen
Ein Prüfstand für Assistenten, die Menschen durch Aufgaben führen
Ein kurzer X-Beitrag vom 27. Oktober verweist auf InteractiveWorld, eine Arbeit über eine überprüfbare, menschenzentrierte Umgebung für interaktive multimodale Sprachmodelle. Das Paper war laut der Hugging-Face-Seite am 24. Oktober veröffentlicht und wurde dort am 27. Oktober eingereicht. [1][2]
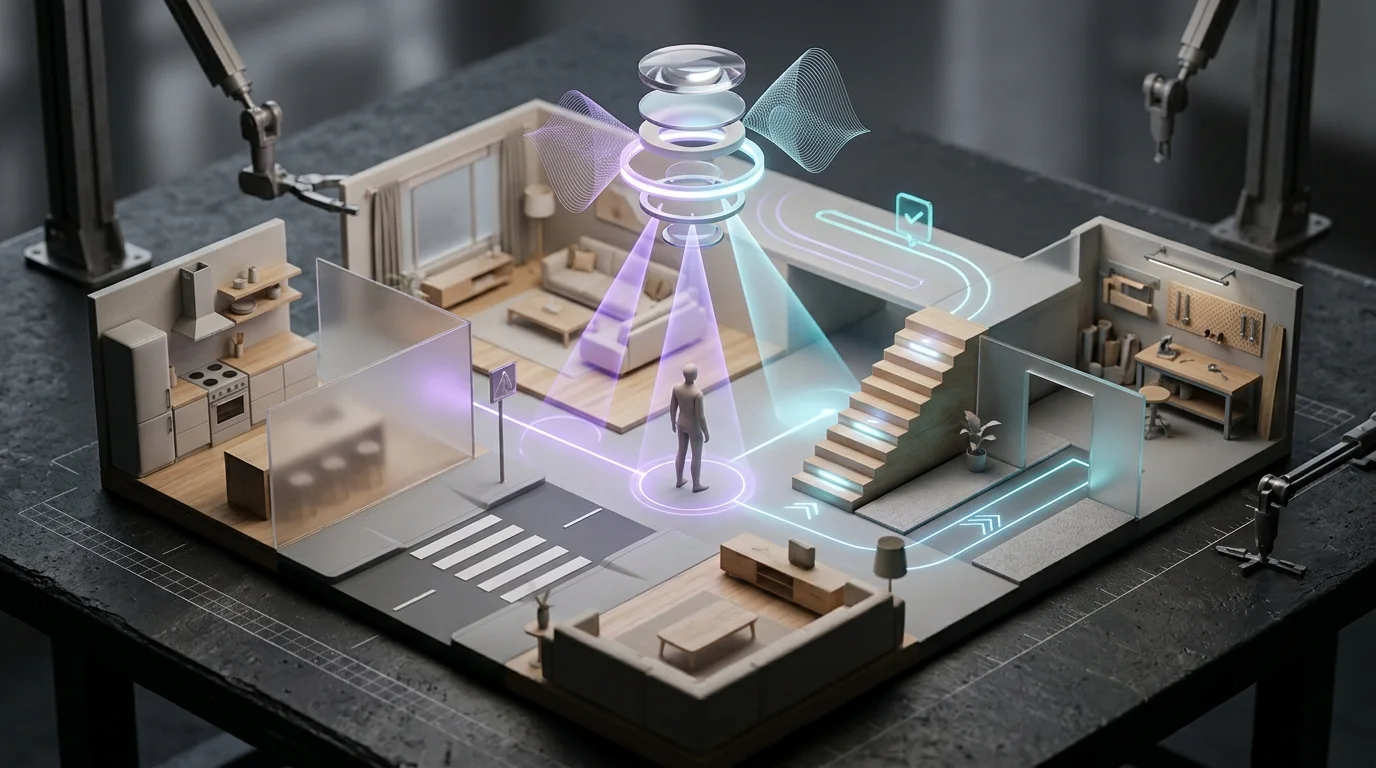
Der Ansatz richtet sich auf eine andere Frage als klassische Bildtests: Kann ein Modell eine Person während einer physischen Tätigkeit sinnvoll unterstützen, wenn es fortlaufend visuelle Eindrücke erhält, Anweisungen gibt und die Szene sich durch menschliches Handeln verändert? Die Autoren bezeichnen InteractiveWorld als eine verifizierbare Simulationsumgebung für diese Art der Zusammenarbeit. [2]
Das Projekt umfasst zwei miteinander verbundene Teile. InteractiveWorld ist der Simulator; InteractiveBench baut darauf einen Benchmark mit 120 mehrstufigen Aufgaben auf. Laut Repository verteilen sich die Aufgaben gleichmäßig auf sechs Kategorien. [2][3]
- Guidance: schrittweise Anleitung während einer Aufgabe. [3][4]
- Planning: Planung unter Vorgaben und Anpassung des Vorgehens. [4]
- Accessibility: Unterstützung, wenn die simulierte Person die Bilder nicht selbst erhält. [4]
- Decision: Auswahl auf Grundlage der beobachteten Situation und weiterer Anforderungen. [4]
- Prevention: rechtzeitige Warnung vor einem Fehler, ohne unnötige Unterbrechungen. [4]
- Finding: Wiederfinden von Gegenständen anhand zuvor erlebter Szenen. [4]
Vom Bildverständnis zur geschlossenen Interaktionsschleife
Bei einem statischen visuellen Benchmark erhält ein Modell typischerweise ein Bild oder einen Clip und wird anschließend an einer Antwort gemessen. InteractiveWorld setzt stattdessen auf eine fortlaufende Schleife: Der Assistent beobachtet eine Ich-Perspektive, kommuniziert mit einer simulierten Person, diese entscheidet und handelt, und die Umgebung liefert danach eine veränderte Beobachtung. [2][3]
Damit verschiebt sich auch der Maßstab für eine gelungene Antwort. Eine flüssige Erklärung genügt nicht, wenn die Person dadurch das falsche Objekt nimmt oder ein gewünschtes Ziel nicht erreicht. Im Projekt werden Aufgaben deshalb anhand des Zustands der Welt bewertet: Entscheidend ist, ob die vorgegebenen Ziele nach der Interaktion erfüllt sind. [2][3]
Das ist für multimodale Sprachmodelle relevant, weil ihre Leistung hier nicht auf das Erkennen eines Bildinhalts begrenzt ist. Sie müssen Informationen aus visuellen Beobachtungen und Gesprächsverlauf nutzen, passende Anweisungen formulieren und berücksichtigen, dass Handlungen den nächsten Zustand verändern. Diese Einordnung beschreibt die Konsequenz des entworfenen Testaufbaus; sie belegt nicht, dass Ergebnisse aus der Simulation automatisch auf reale Geräte oder Nutzer übertragbar sind. [2][3]
Eine simulierte Person statt eines Roboters als Handlungsträger
Das Repository hebt die menschliche Perspektive als Abgrenzung zu robotikzentrierten Simulatoren hervor. Eine animierte Person bewegt sich durch Innenräume, greift Gegenstände, öffnet Objekte und verwendet sie. Der Assistent erhält eine Ich-Perspektive und spricht; die Person bleibt diejenige, die entscheidet und Handlungen ausführt. [2][3]
Der Simulator stellt laut Repository 44 Szenen aus BEHAVIOR-1K bereit. Die Person wird über kurze Kommandos gesteuert, etwa zum Gehen, Greifen, Ablegen oder Sitzen. Aufgeführt werden insgesamt 36 Aktionsfamilien, darunter außerdem Öffnen, Kochen, Schneiden, Umrühren und die Nutzung eines Computers. [3]
Diese Konstruktion soll die Rollenverteilung eines tragbaren Assistenten abbilden: Das System unterstützt eine Person, anstatt die Aufgabe selbst als Roboter auszuführen. Der Unterschied ist für die Interpretation der Resultate wichtig. Gemessen wird in diesem Aufbau nicht allein eine autonome Manipulationsfähigkeit, sondern die Qualität der Anleitung innerhalb einer Mensch-KI-Interaktion. [2][3]
120 Aufgaben in sechs Kategorien
InteractiveBench bündelt 120 eingefrorene, mehrteilige Aufgaben, jeweils 20 pro Kategorie. Die sechs Bereiche heißen Guidance, Planning, Accessibility, Decision, Prevention und Finding. Der Benchmark ist damit auf unterschiedliche Formen der Unterstützung angelegt, von schrittweiser Anleitung bis zur Erinnerung an zuvor beobachtete Gegenstände. [3][4]
Die ergänzende Beschreibung von ExplainX nennt als Beispiele das Anleiten beim Kochen, das Auswählen von Speisen unter Zeit- oder Ernährungsvorgaben und das Beschreiben einer Küche für eine blinde simulierte Person. Bei Prevention soll der Assistent vor einem Fehler warnen, bei Finding etwa helfen, ein zuvor bewegtes Objekt wiederzufinden. Diese Beispiele illustrieren die Kategorien; sie sind keine eigenständigen Resultate des Benchmarks. [4]
Für Unternehmen liegt der mögliche Nutzen einer solchen Aufteilung in der differenzierteren Fehleranalyse. Ein Gesamtscore allein würde kaum erkennen lassen, ob ein Modell Schwierigkeiten mit Planung, räumlicher Beschreibung oder dem richtigen Zeitpunkt für eine Warnung hat. Diese Folgerung ist eine Analyse des Aufgabendesigns, nicht ein vom Projekt nachgewiesener Vorteil für den Produkteinsatz. [3][4]
Zustandsprüfung macht Erfolge nachvollziehbarer
In der Benchmark-Konfiguration übernimmt ein Modell die Rolle des Assistenten; ein zweites, festgelegtes Modell spielt die menschliche Person und setzt Anweisungen in Simulatoraktionen um. Das Ergebnis wird nicht allein anhand des Dialogs beurteilt: Eine Aufgabe gilt laut Repository dann als bestanden, wenn die geforderten Ziele im abschließenden Weltzustand erfüllt sind. [3]
Die Paper-Zusammenfassung beschreibt dafür zustandsbasierte Belohnungen. Damit lässt sich beispielsweise prüfen, ob ein Gegenstand tatsächlich am vorgesehenen Ort liegt. Im Unterschied zu einer Bewertung, die ausschließlich die Formulierung einer Antwort beurteilt, ist dieses Erfolgskriterium an einen veränderten Zustand der Simulation gebunden. [2][3]
Die Prüfbarkeit hat zugleich Grenzen. Ein formal erreichtes Simulationsziel sagt nicht ohne Weiteres aus, ob eine reale Person die Anweisung verstanden hätte, ob eine Kamera die relevante Information erfasst oder ob die Interaktion in einer unübersichtlichen Umgebung funktioniert. ExplainX weist ebenfalls darauf hin, dass die beschriebenen Tests Simulationen betreffen und keine bestätigte Übertragung auf reale Wearables darstellen. [4]
Die berichteten Modellwerte und eine nicht aufgelöste Abweichung
Im Abstract berichten die Autoren von Experimenten mit zwölf aktuellen multimodalen Sprachmodellen. Das stärkste Modell sei Claude Fable 5.1 gewesen; bei den langfristigen Aufgaben der Kategorien Guidance und Planning habe es höchstens 20 beziehungsweise 25 Prozent erreicht. Die Werte beziehen sich laut Abstract auf diese beiden Aufgabenbereiche und sollten nicht als allgemeine Erfolgsquote für sämtliche Aufgaben gelesen werden. [2]
Unter dem X-Beitrag steht ein Kommentar, der Claude Fable 5.1 mit 41,7 Prozent an die Spitze setzt und anmerkt, das Modell bleibe damit unter der Hälfte der Aufgaben. Der Kommentar erläutert jedoch weder, welche Aufgaben oder Metriken zugrunde liegen, noch wie die Zahl berechnet wurde. Da das Paper-Abstract stattdessen die genannten Höchstwerte für langfristige Guidance- und Planning-Aufgaben ausweist, lassen sich die Angaben anhand der bereitgestellten Informationen nicht direkt miteinander abgleichen. Die Kommentarzahl ist daher keine belastbare Ergänzung zu den im Abstract beschriebenen Ergebnissen. [1][2]
Auch die Ergebnisse des Abstracts bleiben eine Angabe der Autoren. Die bereitgestellten Quellen enthalten keine unabhängige Replikation der Modelltests. Für eine Bewertung als Auswahlgrundlage für Unternehmensanwendungen wären deshalb neben diesen Benchmarks auch eigene Tests mit passenden Nutzergruppen, Geräten und Aufgaben erforderlich. Der letzte Punkt ist eine analytische Schlussfolgerung aus der simulierten Versuchsanordnung, kein im Paper berichteter Befund. [2][3][4]
Hohe technische Einstiegshürden für eine eigene Auswertung
Das Repository beschreibt InteractiveWorld als Software für Linux mit einer NVIDIA-GPU. Als getestete Hardware nennt es eine A100 mit 80 GB; ein Simulatorprozess benötige ungefähr 4 GB GPU-Speicher. Für die Daten und vorbereiteten Assets veranschlagt das Projekt rund 100 GB Speicherplatz. Diese Werte stammen aus der Installationsbeschreibung des Projekts und sind keine unabhängige Leistungsprüfung. [3]
Zur Einrichtung gehören Isaac Sim, OmniGibson und Szenen sowie Objekte aus BEHAVIOR-1K. Hinzu kommen ein Körpermodell und Bewegungsdaten, die laut Repository separat beschafft werden müssen. Ein Vorbereitungsskript verarbeitet unter anderem 6.831 Objekte des Releases. Für Organisationen bedeutet das, dass ein Benchmark-Lauf nicht mit einer einfachen Modellabfrage gleichzusetzen ist: Infrastruktur, Datensätze und Lizenzbedingungen sind Teil des Aufwands. [3]
ExplainX ordnet den Code einer nichtkommerziellen Lizenz zu und weist darauf hin, dass für Daten und Körpermodelle zusätzliche Bedingungen gelten. Das Repository nennt seinerseits separate Bezugs- und Lizenzinformationen für diese Bestandteile. Eine kommerzielle Nutzung sollte daher nicht allein aus der öffentlichen Verfügbarkeit des Codes abgeleitet werden; die jeweils einschlägigen Lizenztexte müssen geprüft werden. [3][4]
Was der Ansatz für B2B-Teams leisten kann – und was nicht
Für Teams, die multimodale Assistenten für Brillen oder andere tragbare Geräte entwickeln, bietet InteractiveWorld ein konkretes Evaluationsmuster: eine begrenzte Beobachtungsperspektive, einen fortlaufenden Dialog, eine handelnde Person und ein messbares Aufgabenziel. Das kann helfen, Fehler jenseits der reinen Bildbeschreibung zu untersuchen, etwa ob Hinweise zum jeweiligen Gesprächs- und Szenenverlauf passen. Diese Anwendungsperspektive ist eine Analyse des bereitgestellten Designs, keine Zusage des Projekts für einen Produktivbetrieb. [2][3]
Die Ergebnisse sollten zugleich eng ausgelegt werden. Der Simulator bildet Innenräume und vordefinierte Aktionen ab; die Quellen belegen weder eine Prüfung in realen Wohnungen noch die Zuverlässigkeit mit tatsächlichen Trägern, Sensoren oder wechselnden Umgebungsbedingungen. Für Unternehmen ist InteractiveWorld daher eher als Forschungs- und Vergleichsumgebung zu verstehen als als Nachweis, dass ein Modell bereits sicher oder zuverlässig im Alltag assistieren kann. [3][4]
Die zentrale Neuerung liegt somit weniger in einem bereits belegten Einsatzreifegrad als in der Evaluationslogik: Nicht nur fragen, ob ein Modell eine Szene beschreiben kann, sondern prüfen, was nach seiner Anleitung in einer dynamischen Umgebung geschieht. Ob sich daraus belastbare Aussagen für konkrete Produkte ergeben, hängt von der Qualität der Simulation, der gewählten menschlichen Modellrolle und ergänzenden Tests außerhalb dieser Umgebung ab. [2][3]
Quellen
- [1] InteractiveWorld A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants paper: — https://x.com/_akhaliq/status/2115097545147924900 (abgerufen am 2026-10-27)
- [2] Paper page - InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants — https://huggingface.co/papers/2610.33966 (abgerufen am 2026-10-27)
- [3] GitHub - facebookresearch/InteractiveWorld: This is the official repo for paper InteractiveWorld A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants · GitHub — https://github.com/facebookresearch/InteractiveWorld (abgerufen am 2026-10-27)
- [4] InteractiveWorld: Meta Tests Glasses Assistants in 120 Tasks | explainx.ai Blog | explainx.ai — https://explainx.ai/blog/meta-interactiveworld-interactivebench-wearable-ai-assistant-simulator-2026 (abgerufen am 2026-10-27)
//Nächster Artikel
Regulierung
LLMs als Neuheitsprüfer: Kleine Prompt-Änderungen kippen ForschungsurteileEine Ai2-Studie zeigt, wie stark Prompts LLM-Urteile zur Forschungsneuheit verändern. Was das für automatisierte Ideenbewertung bedeutet.
// Artikel teilen
// Dranbleiben
Mindverse News folgen
Neue Meldungen erhalten Sie über unseren RSS-Feed oder auf LinkedIn.
Recherchieren Sie KI-News wie diese selbst — mit Mindverse Studio.
7 Tage kostenlos testen — ohne Kreditkarte, mit 200 Credits. Für Fragen zur Umsetzung buchen Sie eine persönliche Demo.
//Chronik
Rund um den 27. Oktober 2026
← Davor erschienen